Un modelopredictivo en este contexto es un marco computacional que pronostica dónde se unen las proteínas al ADN basándose en características de la secuencia. Estos modelos son esenciales para comprender la regulación génica, ya que ayudan a identificar qué segmentos de ADN son reconocidos por factores de transcripción, proteínas que controlan la expresión génica. Al predecir los sitios de unión a lo largo del genoma, los investigadores pueden mapear redes reguladoras y vincular variaciones genéticas con enfermedades.
Historia
Los primeros enfoques computacionales en la década de 1980 utilizaban secuencias consenso simples, pero los modelospredictivos modernos surgieron en la década de 2000 con métodos de aprendizaje automático como las máquinas de vectores de soporte y, más tarde, el aprendizaje profundo.
Cómo funciona
El modelo se entrena con datos conocidos de unión proteína-ADN, aprendiendo patrones en las secuencias de ADN que se correlacionan con la unión. Características como la composición de nucleótidos, las coincidencias de motivos y la accesibilidad estructural se codifican como entradas. Los algoritmos de aprendizaje automático, a menudo redes neuronales profundas, aprenden entonces una función que asigna estas características a la probabilidad de unión. Una vez entrenado, el modelo puede escanear genomas completos para predecir nuevos sitios de unión.
En la práctica
Estos modelos se utilizan para anotar genomas, identificar mutaciones reguladoras asociadas a enfermedades y diseñar circuitos génicos sintéticos en biotecnología.
Dato curioso
Algunos modelospredictivos pueden alcanzar ahora una precisión comparable a la de métodos experimentales como ChIP-seq, pero a una fracción del costo y del tiempo.
Imagina un mapa de vientos sobre una cordillera. El viento sopla principalmente cuesta abajo, obedeciendo los desniveles. Pero si miras de cerca, en algunos valles el aire se arremolina en pequeños remolinos que impiden que el viento simplemente fluya hacia abajo. Así es exactamente el campo de mutaciones en el ADN humano.
Imagina que intentas averiguar qué ocurrió en una habitación por el sonido que queda después de un disparo. El disparo ya no está, pero el eco aún resuena en las paredes. Así, aproximadamente, un neuropatólogo observa un corte de tejido cerebral en el que no aparece el tumor: la biopsia solo ha tomado tejido sano que ha reaccionado a la enfermedad.
En el hielo antártico, una partícula fantasma deja tras de sí solo un débil destello de luz azul. El detector IceCube capta esos destellos, y con ellos hay que deducir de dónde vino la partícula. El modelo PolarBERT aprendió a hacerlo, pero qué ve exactamente en su interior seguía siendo un misterio.
Una proteína en la célula no permanece inmóvil, como un maniquí en un escaparate. Sus átomos tiemblan, se estiran y se doblan constantemente, como una cuerda de guitarra tensa que sigue sonando después de que la rozas con el dedo. Para entender cómo funciona una proteína, hay que saber con qué firmeza cada parte se aferra a sus vecinas.
Bajo el microscopio electrónico, una proteína se ve como una serie de sombras borrosas: cientos de miles de imágenes de la misma molécula, pero desde ángulos distintos y con un fuerte ruido. Antes, a partir de esas sombras se armaba primero una 'neblina' tridimensional: un mapa de cómo se distribuye la carga eléctrica dentro de la proteína.
Una sola molécula de ADN, atrapada en una diminuta rendija metálica, tiembla y parpadea bajo el láser. Su señal no es una clara línea de letras, sino una mezcla caótica de destellos y sombras. Descifrar ese ruido es como entender un susurro en una sala abarrotada.
La nueva red neuronal actúa como un intérprete atento.
Una proteína es como una pequeña máquina que se enciende y se apaga bajo órdenes. La orden llega cuando otra molécula se adhiere a ella, como una llave en una cerradura. Después, la proteína cambia de forma y transmite la señal más allá. Pero cómo exactamente viaja la señal dentro de la proteína había sido un misterio durante mucho tiempo.
Si giras lentamente el dial de una radio antigua, el sonido no emerge del ruido de forma gradual, sino con un salto brusco, en el instante en que la antena entra en resonancia con la onda. Algo parecido ocurre con los genes en una célula viva.
Un coágulo crece como una bola de nieve que rueda montaña abajo: al principio es pequeño, va atrapando capas nuevas, y cuándo se convertirá en una avalancha es difícil de adivinar. En la sangre se desencadena una larga cadena de reacciones —la cascada de coagulación—, donde una sustancia despierta a otra y el coágulo gana masa.
Una campanilla escondida en una caja gruesa se puede hacer sonar sin abrir la tapa. Basta con enviar una onda de sonido a través de las paredes, y el badajo vibrará.
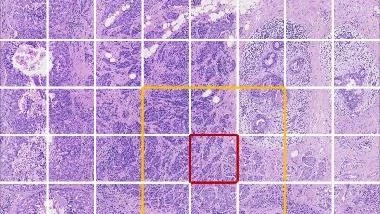
Una gran orquesta sin director. Cada músico es un gen, y la melodía es el complejo trabajo de la célula. Antes, al mirar una fotografía de tejido, el ordenador intentaba adivinar la parte de cada instrumento por separado. No sabía que los violines suelen tocar junto a las violas, y las trompetas con los trombones.
El cerebro no solo reacciona al mundo: constantemente está adivinando qué ocurrirá en el instante siguiente. Este principio se conoce como codificación predictiva: las neuronas comparan las expectativas con la realidad y actualizan su imagen interna cuando ocurre un error.
Una red donde los leones comen cebras y las hienas terminan con los restos no es solo una lista de almuerzos. Es un mapa de supervivencia de toda una región. Cuando el clima cambia, los animales migran y el mapa se rompe. Para entender dónde se romperá y dónde resistirá, hay que encontrar su «esqueleto» inmutable: esos vínculos que se repiten en distintos lugares.
Una proteína en la célula no es una pieza rígida, sino más bien un guante suave que puede envolver distintos objetos. Hasta ahora, los diseñadores de proteínas trabajaban como escultores, creando una llave para una única cerradura: un objetivo, una forma.
Una proteína se desliza por la hebra de ADN como una llave por un llavero, buscando su cerradura. Un giro equivocado y el gen quedará apagado. Para saber dónde se agarrará la proteína con firmeza, hay que medir la fuerza de ese agarre: la energía de unión.
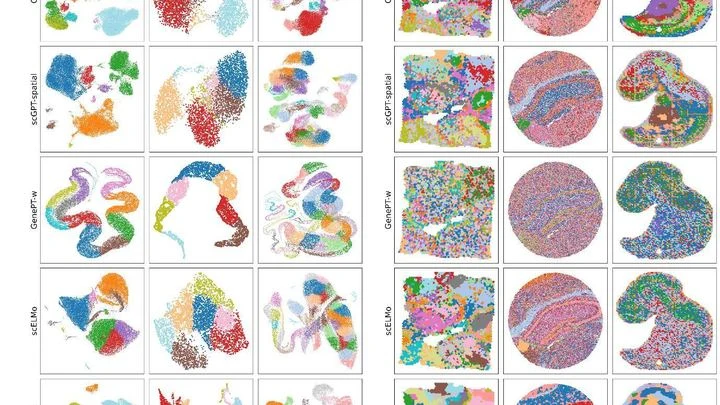
Cada vez más, los biólogos confían a las computadoras la lectura de las "instrucciones de uso" de una célula viva. Seis modelos recientes de inteligencia artificial —Nicheformer, CellPLM, scGPT-spatial, GenePT, scELMo y Novae— son como seis traductores de diferentes dialectos del mismo lenguaje celular.
Una biblioteca enorme donde cada libro es una instrucción precisa para ensamblar una molécula de proteína. La red neuronal AlphaFold2 ha leído millones de estos libros y ha aprendido a generar al instante un modelo tridimensional ya terminado.
Los genes son como casas en una ciudad: en algunas hierve la vida, en otras reina el silencio. Este 'paisaje' genético urbano fue analizado en mil mujeres con cáncer de mama.
Cuando los biólogos miden la actividad de miles de genes, normalmente solo ven una lista de correlaciones, como dos ingredientes en una sopa que suelen aparecer juntos. El método estándar busca ese tipo de pares, pero no muestra quién influye sobre quién.
Los datos sobre el funcionamiento de los genes suelen verse como una larga fila de números, similar a una franja de arcoíris (espectro) sin conexiones visibles. En el modelo scVision, estos números se transforman en una imagen con sentido: no una lista de ingredientes, sino la foto de un plato terminado.
Las células de un mismo organismo son como panaderos gemelos en una cocina compartida. Tienen el mismo libro de recetas (ADN), pero al copiar la receta en un apunte y al montar el plato, surgen errores aleatorios. Esta imprevisibilidad —la entropía— hace que en células idénticas a veces haya mucha proteína y a veces poca.
En una cocina con hornillas de gas, cada una calienta a su manera. Si el cocinero cambia las ollas de lugar, la comida puede quemarse. Lo mismo ocurre en una red inalámbrica: las antenas-hornillas y los usuarios-ollas requieren una colocación precisa. Las redes neuronales comunes no distinguen posiciones, considerando todas las hornillas iguales.
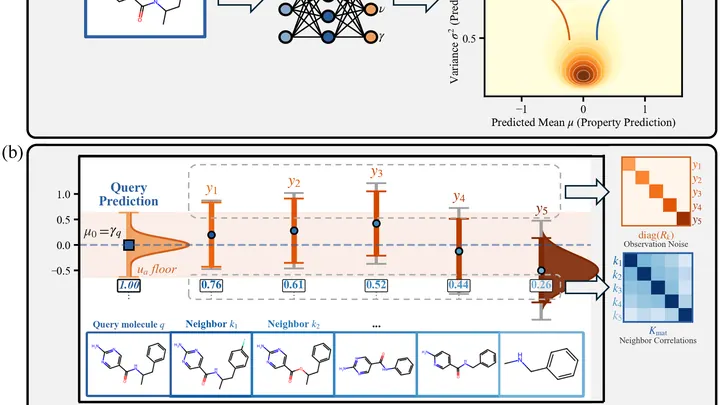
Predecir las propiedades de una nueva molécula es como adivinar el sabor de un plato desconocido. El programa funciona como un cocinero experimentado: «prueba» moléculas similares cuyas propiedades ya se conocen y, basándose en su «sabor», ajusta su conjetura.
La tecnología compleja —desde drones hasta robots cirujanos— a veces se comporta como un mustang salvaje: llena de desorden y caprichos, donde un leve contacto provoca una tormenta. En lugar de memorizar fórmulas, el nuevo método observa el sistema como un jinete adiestrador.
Un detective experimentado no calcula la trayectoria de un criminal a partir de las leyes de la física: consulta el archivo de casos similares. Así funciona este nuevo método de predicción: en lugar de ecuaciones complejas, dispone de un enorme archivo de trayectorias ya ocurridas: movimientos planetarios, cotizaciones de divisas, señales del espacio.
Has recibido un informe: en tu gen se ha reemplazado una "letra". Pero, ¿qué cambia eso? Una proteína no es una línea plana, sino una madeja compacta donde cada bucle se asienta en su hueco. Una sustitución en el interior de esa madeja es como una grieta en los cimientos, y en la superficie, como un arañazo en la fachada.
Una proteína en la célula no es una escultura congelada. Se mueve constantemente: se dobla, respira, tiembla. Este movimiento, llamado dinámica, determina cómo funciona la proteína. Pero observar directamente esa danza es difícil, y la simulación por computadora a menudo requiere enormes recursos computacionales.
Aislar la señal de un par de agujeros negros supermasivos es como distinguir los pasos de un bailarín en el estruendo de un huracán. En algún lugar del cosmos, estos monstruos giran en un lento tango gravitacional, deformando el propio espacio-tiempo.
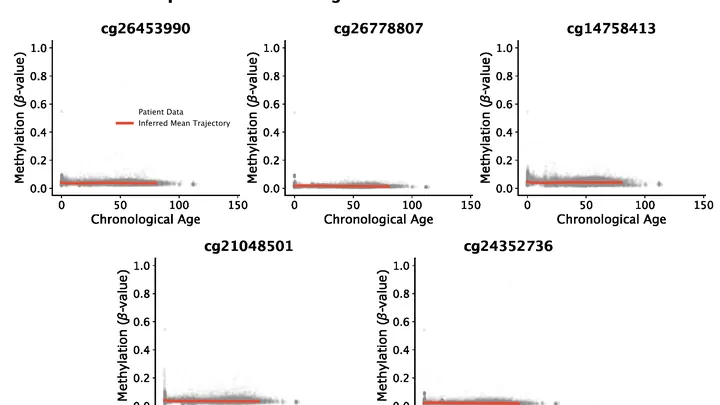
La metilación del ADN son pequeñas marcas químicas en nuestros genes. Con los años, cambian siguiendo un calendario bastante estricto. Los relojes epigenéticos convencionales observan estas marcas y dan un número: la edad biológica. Pero un número no cuenta cómo se reorganizó el patrón de marcas día a día, año tras año.
Imagina una audición para una orquesta sinfónica, donde de cientos de aspirantes solo se quedan aquellos cuyos instrumentos suenan limpios y resisten un feroz crescendo. En el mundo de los materiales, las computadoras han aprendido a generar «partituras atómicas»: miles de cristales virtuales que prometen ser la base de chips cuánticos o superconductores.
El sistema inmunitario se parece a un editor incansable que corrige el borrador de los anticuerpos, haciéndolos cada vez más afines a virus y bacterias.
Un ingeniero ajusta una antena: estira un segmento y la frecuencia se desplaza; cambia el ángulo y la ganancia cae. Algo parecido ocurre en el desarrollo de péptidos terapéuticos (cadenas cortas de proteínas).
Una red neuronal, como una hoja de papel cuadriculado, recibe señales homogéneas en su entrada y, por sí misma, traza una cuadrícula de coordenadas. Primero, las conexiones entre las entradas y las células de la red se asemejan a una colina suave: en el centro la respuesta es más fuerte y hacia los bordes se atenúa.
Compras una báscula de cocina nueva, pero en lugar de mostrar el peso exacto, solo indica la desviación respecto a una "norma". Para saber cuánto pesa una manzana, primero tienes que pesar decenas de otras manzanas y calcular el promedio.
Durante mucho tiempo, solo veíamos las proteínas en su posición final, como fotografías de bailarines congelados en una pose hermosa. Programas como AlphaFold aprendieron a predecir esta pose a partir de la cadena de eslabones de carbono. Pero la verdadera magia está en cómo la proteína encuentra esta forma más rápido de lo que parpadeas, ejecutando una danza vertiginosa.
Dos cuadrillas de obreros asfaltan una calle desde extremos opuestos. Avanzan una hacia la otra, y de su coordinación depende cuándo estará lista la vía.
Un laboratorio envía a un robot una lista de mil moléculas candidatas para un nuevo fármaco. El robot predictor, entrenado con datos antiguos, da para cada una una evaluación de 'apta o no apta'. Pero cuando la lista proviene de un área desconocida —otro virus o un tumor raro—, el robot empieza a confundirse. Su confianza sigue siendo alta, pero los aciertos reales caen a cero.
Un cable telefónico roto es un problema, pero un ADN roto es una catástrofe. Una rotura de doble cadena (cuando ambas hebras de la hélice se rompen en el mismo punto) amenaza a la célula con la muerte o con convertirse en cancerosa.
Un traductor no aprende un idioma con un libro de texto, sino escuchando el habla viva y viendo de inmediato qué hace la gente en respuesta a las palabras. Así funciona el nuevo método C3P para leer ADN bacteriano. Los modelos genómicos habituales intentan aprender las reglas simplemente "releyendo" miles de millones de letras del código genético, y a menudo se confunden.