Dos ojos ven mejor que uno: cómo una red neuronal aprende a ver un tumor exprés
Un médico examina una imagen del cerebro: en algún lugar, entre el entramado de tejidos, se esconde un tumor. Una mirada capta manchas pequeñas y bordes; otra, la forma general y la ubicación. Una persona combina ambas, pero con cientos de imágenes resulta agotador. El nuevo programa hace lo mismo automáticamente.
Una de sus partes funciona como una lupa: recorre la imagen y recoge detalles finos — textura, bordes, cambios locales. La segunda mira en amplitud, como desde lo alto, y conecta zonas distantes: dónde está el tumor respecto a los ventrículos, cómo encaja en el panorama general. Antes, estas miradas se combinaban de forma tosca — simplemente mezclando los resultados. Ahora se añadió una 'sala de negociación': un bloque especial decide cuánto tomar de cada mirada para cada imagen y cada región.
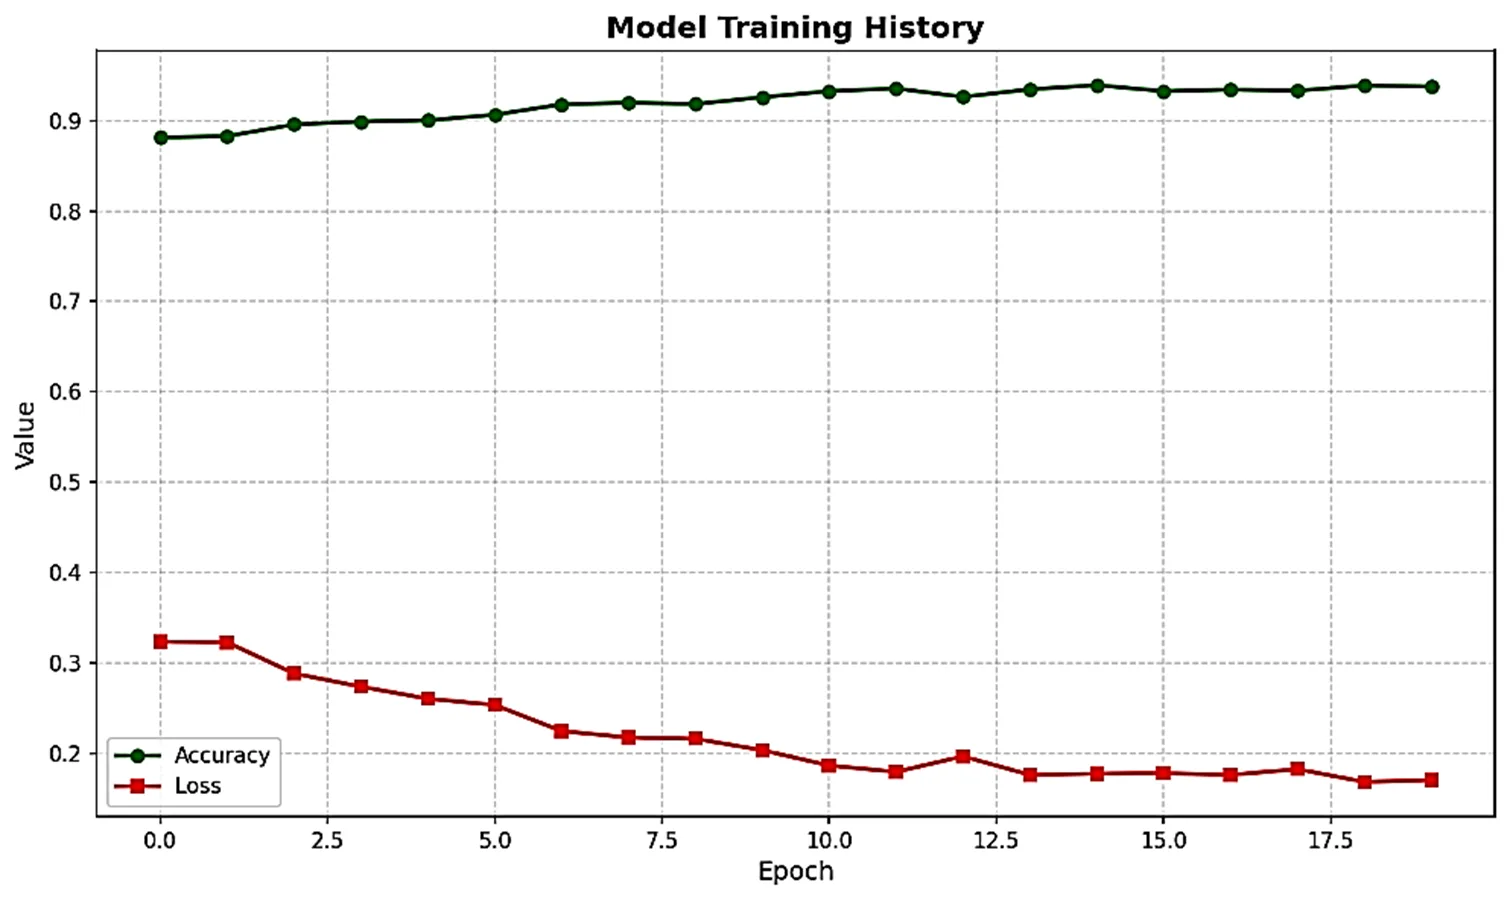
El modelo se entrenó con un conjunto de imágenes con y sin tumores. Reconoció correctamente el tumor en el 97,6% de los casos — más que cada parte por separado y que los métodos anteriores de fusión. La precisión, la exhaustividad y el índice general de calidad — todos mejoraron. Esto significa que la ponderación flexible de las dos miradas ayuda a ver la enfermedad con más claridad.
Este enfoque podría servir no solo para tumores cerebrales: cualquier imagen médica donde importen tanto los detalles finos como el panorama general se beneficiará de 'dos ojos con director de orquesta'.
Resumen original
tal como lo escribieron los autores, en inglés arXiv:2604.23137
Early detection and classifying brain tumors using Magnetic Resonance Imaging (MRI) images is highly important but difficult to extract in medical images. Convolutional Neural Networks (CNNs) are good at capturing both local texture and spatial information whereas Vision Transformers (ViTs) are good at capturing long-range global dependencies. We propose a new hybrid architecture that combines a SqueezeNet-style CNN branch with a MobileViT-style global transformer branch, through an Adaptive Attention Gate mechanism, in this paper. The gate learns dynamically per-sample, per-feature weights to weight the contribution of each branch, allowing context-sensitive merging of local and global representations. The proposed model has a test accuracy of 97.60, a precision of 97.30, a recall of 97.50, an F1-score of 97.40, and a macro-average area under the curve (AUC) of 0.9946 with a trained and evaluated on the Brain Tumor MRI Dataset (Kaggle). These scores are higher than single CNN and ViT baselines, and current competitive fusion methods, showing that dynamic feature weighting is an effective way to classify medical images.
Un AUC de 0,9946 significa que si tomas una imagen aleatoria con tumor y una sin tumor, el modelo casi siempre asignará a la primera una puntuación más alta de 'parecido a tumor'.