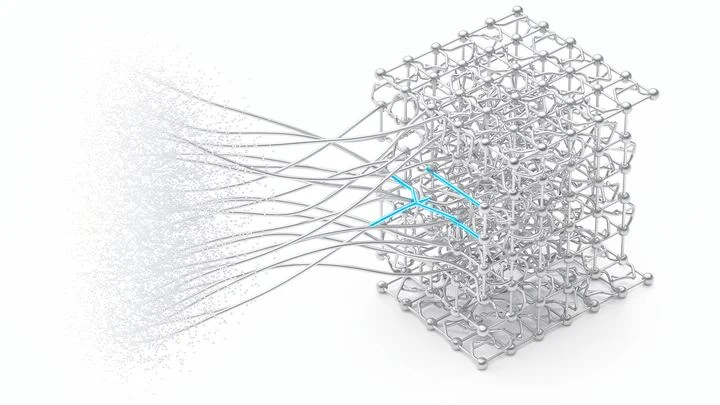
La visión artificial se basa en redes neuronales convolucionales (Convolutional Neural Networks, CNN). Su arquitectura imita la estructura de la corteza visual: células simples responden a líneas en un ángulo determinado, células complejas a combinaciones de estas. Una capa convolucional escanea la imagen con una pequeña ventana, multiplicándola por un filtro y creando mapas de características. Varias de estas capas construyen secuencialmente representaciones cada vez más abstractas: desde bordes y texturas hasta partes de objetos y rostros completos. Los sistemas modernos también utilizan mecanismos de atención y transformadores, procesando la imagen como una secuencia de parches.
Historia
El punto de partida se considera el trabajo de Hubel y Wiesel (1959) sobre la estructura de la corteza visual, que inspiró los modelos jerárquicos. En 1963, Larry Roberts implementó el programa "Blocks World", que interpretaba fotos de cubos. En los años 70, los métodos geométricos se desarrollaron activamente. En los 90 aparecieron los primeros detectores de bordes eficientes. Las redes convolucionales fueron propuestas por Yann LeCun en 1989, aplicándolas al reconocimiento de dígitos. La verdadera revolución ocurrió en 2012, cuando Alex Krizhevsky y sus colegas presentaron AlexNet, que utilizaba procesadores gráficos (GPU): la precisión en ImageNet saltó de ~74% a ~84%. En los años siguientes, las arquitecturas se profundizaron: VGG, ResNet (2015), que resolvió el problema del desvanecimiento del gradiente mediante conexiones de salto. A partir de 2020, los Vision Transformers (Dosovitskiy et al.) trasladaron el mecanismo de autoatención a las imágenes, y modelos como DALL·E 2 y Stable Diffusion aprendieron a generar nuevas imágenes a partir de descripciones textuales.
Cómo funciona
El bloque constructivo básico es la convolución: un núcleo de tamaño k×k se multiplica elemento a elemento por una región de la imagen, y el resultado se suma. Una capa de pooling reduce la resolución, destacando lo esencial. Las capas completamente conectadas toman el vector final de características y emiten una predicción. El entrenamiento se realiza mediante descenso de gradiente con retropropagación del error. En los sistemas modernos, a menudo se preentrena un modelo grande con grandes conjuntos de datos (ImageNet-21k) y luego se ajusta para la tarea objetivo (transfer learning). Para generar imágenes se utilizan autocodificadores (VAE), redes generativas antagónicas (GAN) y, más recientemente, modelos probabilísticos de difusión, que eliminan gradualmente el ruido de un campo aleatorio inicial hasta obtener una imagen nítida.
En la práctica
Un automóvil reconoce señales de tráfico y peatones en tiempo real para frenar a tiempo o advertir al conductor.
Dato curioso
El sistema Google Translate puede traducir el texto de una fotografía de un menú en tiempo real: apuntas la cámara al texto extranjero y en la pantalla aparece directamente en tu idioma, todo gracias al reconocimiento y comprensión de la imagen.
En la década de 1980, la competencia de reconocimiento de voz de DARPA puso fin al debate entre métodos estadísticos y reglas escritas a mano, estableciendo un estándar unificado para todo el campo.
Un radiólogo mira una tomografía abdominal y no ve solo órganos, sino su disposición mutua: qué riñón es más grande, dónde está el tumor respecto al vaso. Es como leer un mapa, donde no basta con saber dónde suele estar una ciudad, sino que hay que poder medir la distancia entre dos puntos del terreno.
Perderse en una sala de espejos es facilísimo: cada pared refleja a la otra y parece que ya has estado allí. Más o menos así se confunde el cerebro cuando hay muchos lugares parecidos alrededor. Las neuronas encargadas del mapa espacial pueden emitir la misma señal para dos esquinas distintas de una habitación. Esto se llama ambigüedad espacial.
Imagina que buscas luciérnagas en un bosque oscuro. En lugar de fotografiar todo el bosque cada segundo y luego examinar las imágenes, llevas contigo un pequeño dispositivo que detecta por sí mismo los destellos y recorta de la imagen solo un círculo alrededor de cada uno. El resto — la oscuridad — no se guarda. Así funciona el nuevo sensor para cámaras científicas.
Por la fibra óptica los datos viajan a la velocidad de la luz, pero el camino no es perfecto: la señal se enturbia, como una voz en un pasillo largo. Cuanto mayor es la velocidad y la distancia, más fuertes son las distorsiones. Normalmente se corrigen con electrónica, pero esta no puede seguir el ritmo de la luz.
Un haz de luz entra en una cubeta de vidrio con vapor de cesio y modifica el estado interno de los átomos: así se escribe la información. Un instante después, otro haz la lee según cómo los átomos absorben la luz. No es un disco duro, sino más bien un bloc de notas que pasa las páginas solo.
La cámara de un teléfono inteligente capta la luz con diminutos sensores, pero por sí solos no distinguen los colores. Por eso se colocan filtros de color delante de ellos: rojo, verde, azul, como vidrieras en una ventana. Cada sensor ve solo su color, y luego un programa ensambla la imagen completa a partir de esas piezas.
Una imagen obtenida con una dosis baja de rayos X se parece a mirar a través de un vidrio empañado: los contornos están, pero los detalles se ahogan en una neblina turbia. Los médicos necesitan este tipo de imágenes durante la radioterapia para apuntar el haz con precisión al tumor y no dañar los tejidos sanos.
Predecir el rendimiento de una reacción química es como intentar adivinar la cosecha conociendo solo la composición del suelo. Tradicionalmente, los químicos se apoyaban en largas columnas de números —los descriptores cuánticos— que describen la energía de los electrones, pero no dicen nada sobre la forma de la molécula.
Predecir el rendimiento de una reacción química es como intentar adivinar la cosecha conociendo solo la composición del suelo. Tradicionalmente, los químicos se apoyaban en largas columnas de números —los descriptores cuánticos— que describen la energía de los electrones, pero no dicen nada sobre la forma de la molécula.
En la galaxia espiral Fuegos Artificiales hay 6410 guarderías estelares. Ese es el número de regiones donde, en este momento, están naciendo estrellas masivas, identificadas por un algoritmo en antiguas imágenes radiación ultravioleta del Edwin Hubble.
Cada mañana docenas de telescopios apuntan al Sol. Sus cámaras captan una angosta banda de luz roja: la línea Hα, descubierta por Johann Jakob Balmer. En las imágenes aparecen hebras oscuras, caprichosamente curvadas. Parecen puntadas de un tapiz gigante que cose la corona ardiente. Son los filamentos solares.
Una prótesis ocular no transmite al cerebro una fotografía, sino un punteado escaso de puntos brillantes: los fosfenos. Para distinguir en ese parpadeo una taza o unas llaves, la persona debe mover la cabeza como una linterna en la oscuridad e ir juntando poco a poco los contornos del objeto. Es un proceso lento, parecido a armar un rompecabezas al que le faltan la mayoría de las piezas.
Al armar el rompecabezas del Universo, los astrónomos están acostumbrados a que cada nueva pieza encaje exactamente en el cuadro ya formado. Pero a veces aparecen piezas que parecen recortadas de otro rompecabezas. Veinte mil núcleos galácticos activos — y el once por ciento de ellos la red neuronal descarta con seguridad como extraños.
Cada vez que un niño con parálisis cerebral se dispone a mover la pierna, en su cerebro se produce un pico eléctrico especial: un lento desplazamiento de voltaje. Los científicos lo llaman potencial relacionado con el movimiento.
Las cámaras del coche autónomo captan la luz como telescopios apuntando a una galaxia lejana. Cada fotograma es una observación fragmentaria; juntos deben combinarse en un mapa del camino.
La computadora, como un astrónomo, no pega las imágenes, sino que genera varias posibles vistas aéreas y las compara con los datos reales.
Un radar común marca al dron solo como un punto. El nuevo método convierte el eco de radio en una escultura volumétrica: la señal delinea la forma, inclinación y movimiento.
En una escena tridimensional, cada punto es como un caramelo cuyo color cambia según el ángulo de visión. Para describir este juego de tonos, por cada punto se almacenan decenas de números — una función matemática especial ideada por Joseph Fourier. La memoria se llena al instante.
El cerebro de quien medita es una orquesta, y la atención es el director. Cuando te concentras en la respiración, todos los instrumentos tocan en armonía. Pero de repente, un pensamiento-violonchelo da una nota falsa: eso es la divagación mental. El director experimentado no entra en pánico: capta al instante la disonancia y devuelve suavemente a la orquesta a la melodía principal: la respiración.
Un IA común ve las imágenes médicas como rompecabezas de fragmentos desconocidos: dos imágenes no emparejadas las considera completamente diferentes. Es como intentar distinguir a gemelos sin saber que son familia. En medicina, los pacientes con la misma enfermedad se ven casi iguales en la resonancia, y el algoritmo se equivoca al confundir a los «parientes».
Una cámara de un solo píxel se asemeja a un pintor que crea una obra a través de una plantilla con múltiples agujeros. Cada toma deja pasar solo una parte del flujo de luz, y luego una computadora reconstruye la imagen completa a partir de este mosaico. Antes, el orden de las máscaras era fijo, como si el pintor usara siempre la misma plantilla sin prestar atención a la escena.
Muchos procesos naturales se describen mediante ecuaciones, pero solo tenemos fragmentos de ellas. El nuevo método actúa como un cartógrafo que, a partir de pocos puntos de referencia, reconstruye un mapa completo del terreno.
Un programa de seguimiento común se asemeja a un navegante que guía un barco por las estrellas. Pero en cuanto el cielo se nubla, las coordenadas empiezan a desviarse y en los datos aumenta la entropía (medida de incertidumbre). El nuevo algoritmo incorpora un «copiloto»: un módulo que monitoriza el nivel de confianza del navegador principal.
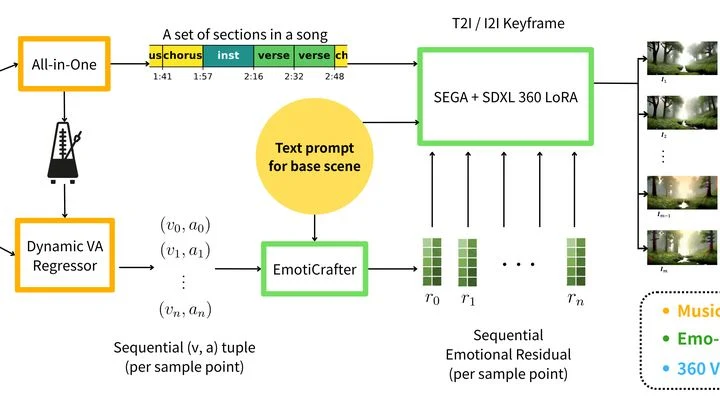
El director sostiene no una batuta, sino un pincel, y cada movimiento da vida a color y forma. La nueva tecnología funciona de manera similar: convierte el estado de ánimo de la canción en un vídeo panorámico que envuelve al oyente.
Primero, el algoritmo, al igual que el análisis de la luz por el espectro, descompone la pista en emociones.
Los datos sobre el funcionamiento de los genes suelen verse como una larga fila de números, similar a una franja de arcoíris (espectro) sin conexiones visibles. En el modelo scVision, estos números se transforman en una imagen con sentido: no una lista de ingredientes, sino la foto de un plato terminado.
El enfoque estándar actual para entrenar a la IA se parece a un niño encerrado en una biblioteca: recuerda millones de libros, pero no sabe que el fuego quema o que una caída duele.
Comunicarse con neuronas vivas es como sintonizar un viejo receptor de radio: no solo hay que captar la onda correcta, sino también orientar la antena.
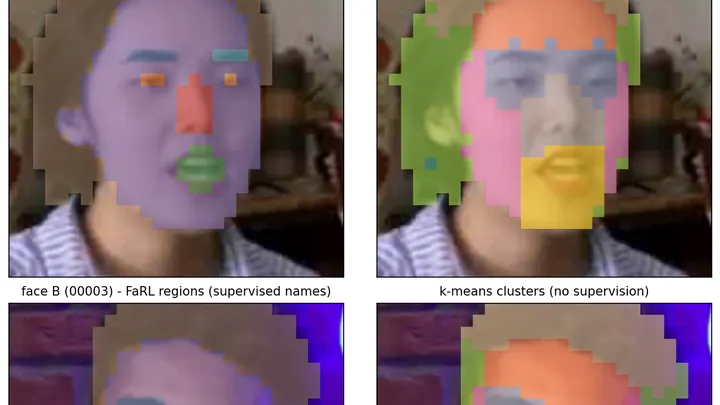
Entrenado con imágenes cotidianas, el modelo DINOv3 comenzó inesperadamente a ver rostros como un espectro: por sí mismo, sin pistas, resalta las zonas de los ojos, la nariz, la boca.
Una persona en un bote gira desplazando el peso de su cuerpo. El mismo truco emplea el barco no tripulado: el giro lo realiza una carga móvil dentro del casco. Una red neuronal controla su movimiento, anticipando el caos de las olas y las ráfagas de viento.
Los tomógrafos no toman fotografías instantáneas. Recogen multitud de «sombras» —proyecciones del interior desde distintos ángulos o con diferentes señales— y a partir de ellas reconstruyen matemáticamente una imagen tridimensional.
Un niño que explora un apartamento desconocido gatea de un objeto a otro y recuerda lo que se ve desde cada rincón. Así, el cerebro construye un mapa mental: un modelo interno del espacio. El algoritmo gradCSCG funciona con el mismo principio: recibe un flujo de video de una cámara y dibuja de forma autónoma el esquema de la habitación, basándose únicamente en el cambio de las imágenes.
En una cocina con hornillas de gas, cada una calienta a su manera. Si el cocinero cambia las ollas de lugar, la comida puede quemarse. Lo mismo ocurre en una red inalámbrica: las antenas-hornillas y los usuarios-ollas requieren una colocación precisa. Las redes neuronales comunes no distinguen posiciones, considerando todas las hornillas iguales.
Un cocinero que aprende a cocinar con dibujos corre el riesgo de arruinar cada plato. La misma trampa le espera a la visión por computadora: los modelos necesitan miles de imágenes etiquetadas, pero recopilarlas manualmente es costoso y tedioso. Las imágenes sintéticas resuelven el problema, solo si se ven realistas.
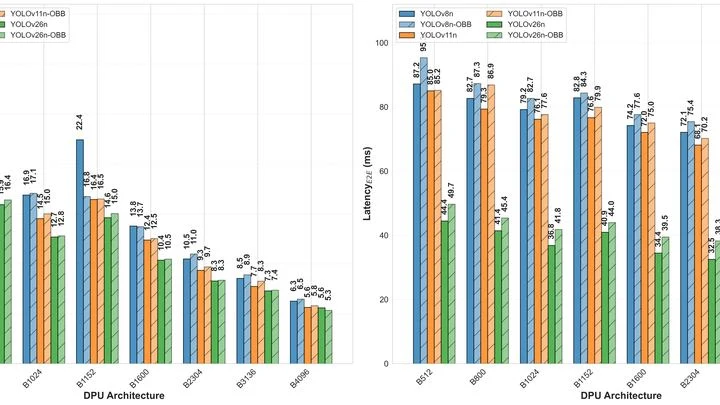
Los sistemas modernos de visión artificial están ganando autonomía: los ingenieros han logrado implementar un algoritmo de reconocimiento de patrones directamente en un chip diminuto, liberando a la cámara de la necesidad de enviar datos a una computadora voluminosa.
El flotador en el tanque del inodoro es un controlador ideal: al detectar el nivel de agua, lleva instantáneamente el sistema al equilibrio sin mirar al pasado. Los ingenieros aplicaron este principio a las redes neuronales.
Ensamblar un chip óptico es como un juego en el que hay que guiar un rayo a través de un laberinto de diminutos espejos y divisores de haz. Cada uno de estos elementos funciona como una aguja en una vía de tren: o deja pasar la luz de frente o la desvía a la vía contigua. El objetivo es obtener a la salida un patrón de luz estrictamente definido, gastando la menor cantidad posible de “agujas”.
El microscopio electrónico es un órgano gigante: en lugar de tubos, lentes electromagnéticas; en lugar de aire, un flujo de electrones acelerados. Antes solo pintaba frescos mudos del mundo atómico, condenando a los científicos a una descodificación extenuante.
Mira el cielo nocturno: no es un puñado de luces, sino un manuscrito de múltiples capas. Bajo la brillante tinta de las estrellas y las galaxias aflora un texto pálido, casi borrado.
El microlente gravitacional es un asombroso efecto cósmico, predicho por Einstein y desarrollado por Zwicky. Un cuerpo masivo que pasa entre nosotros y una estrella lejana curva su luz como una lente, creando amplificaciones y distorsiones características.
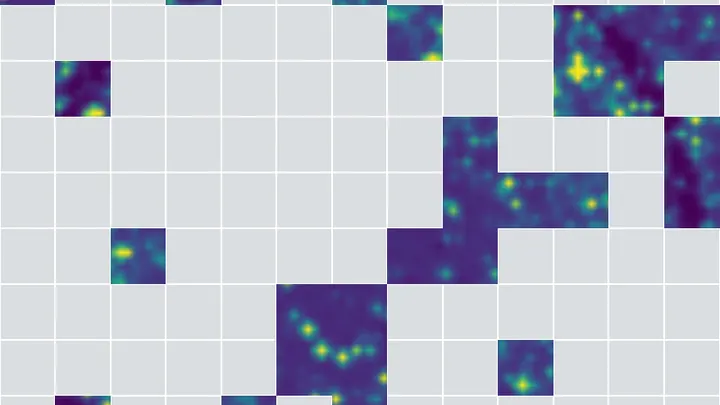
En el Universo joven, hace unos diez mil millones de años, las galaxias parecían campos ilimitados después de una tormenta: por todas partes brotaban gigantescos grumos de formación estelar de miles de años luz, donde las estrellas jóvenes nacían con una energía desenfrenada. Hoy esas regiones casi han desaparecido: en las galaxias cercanas, los focos intensos son raros.