Un constructor de proteínas con memoria de las mejores jugadas exprés
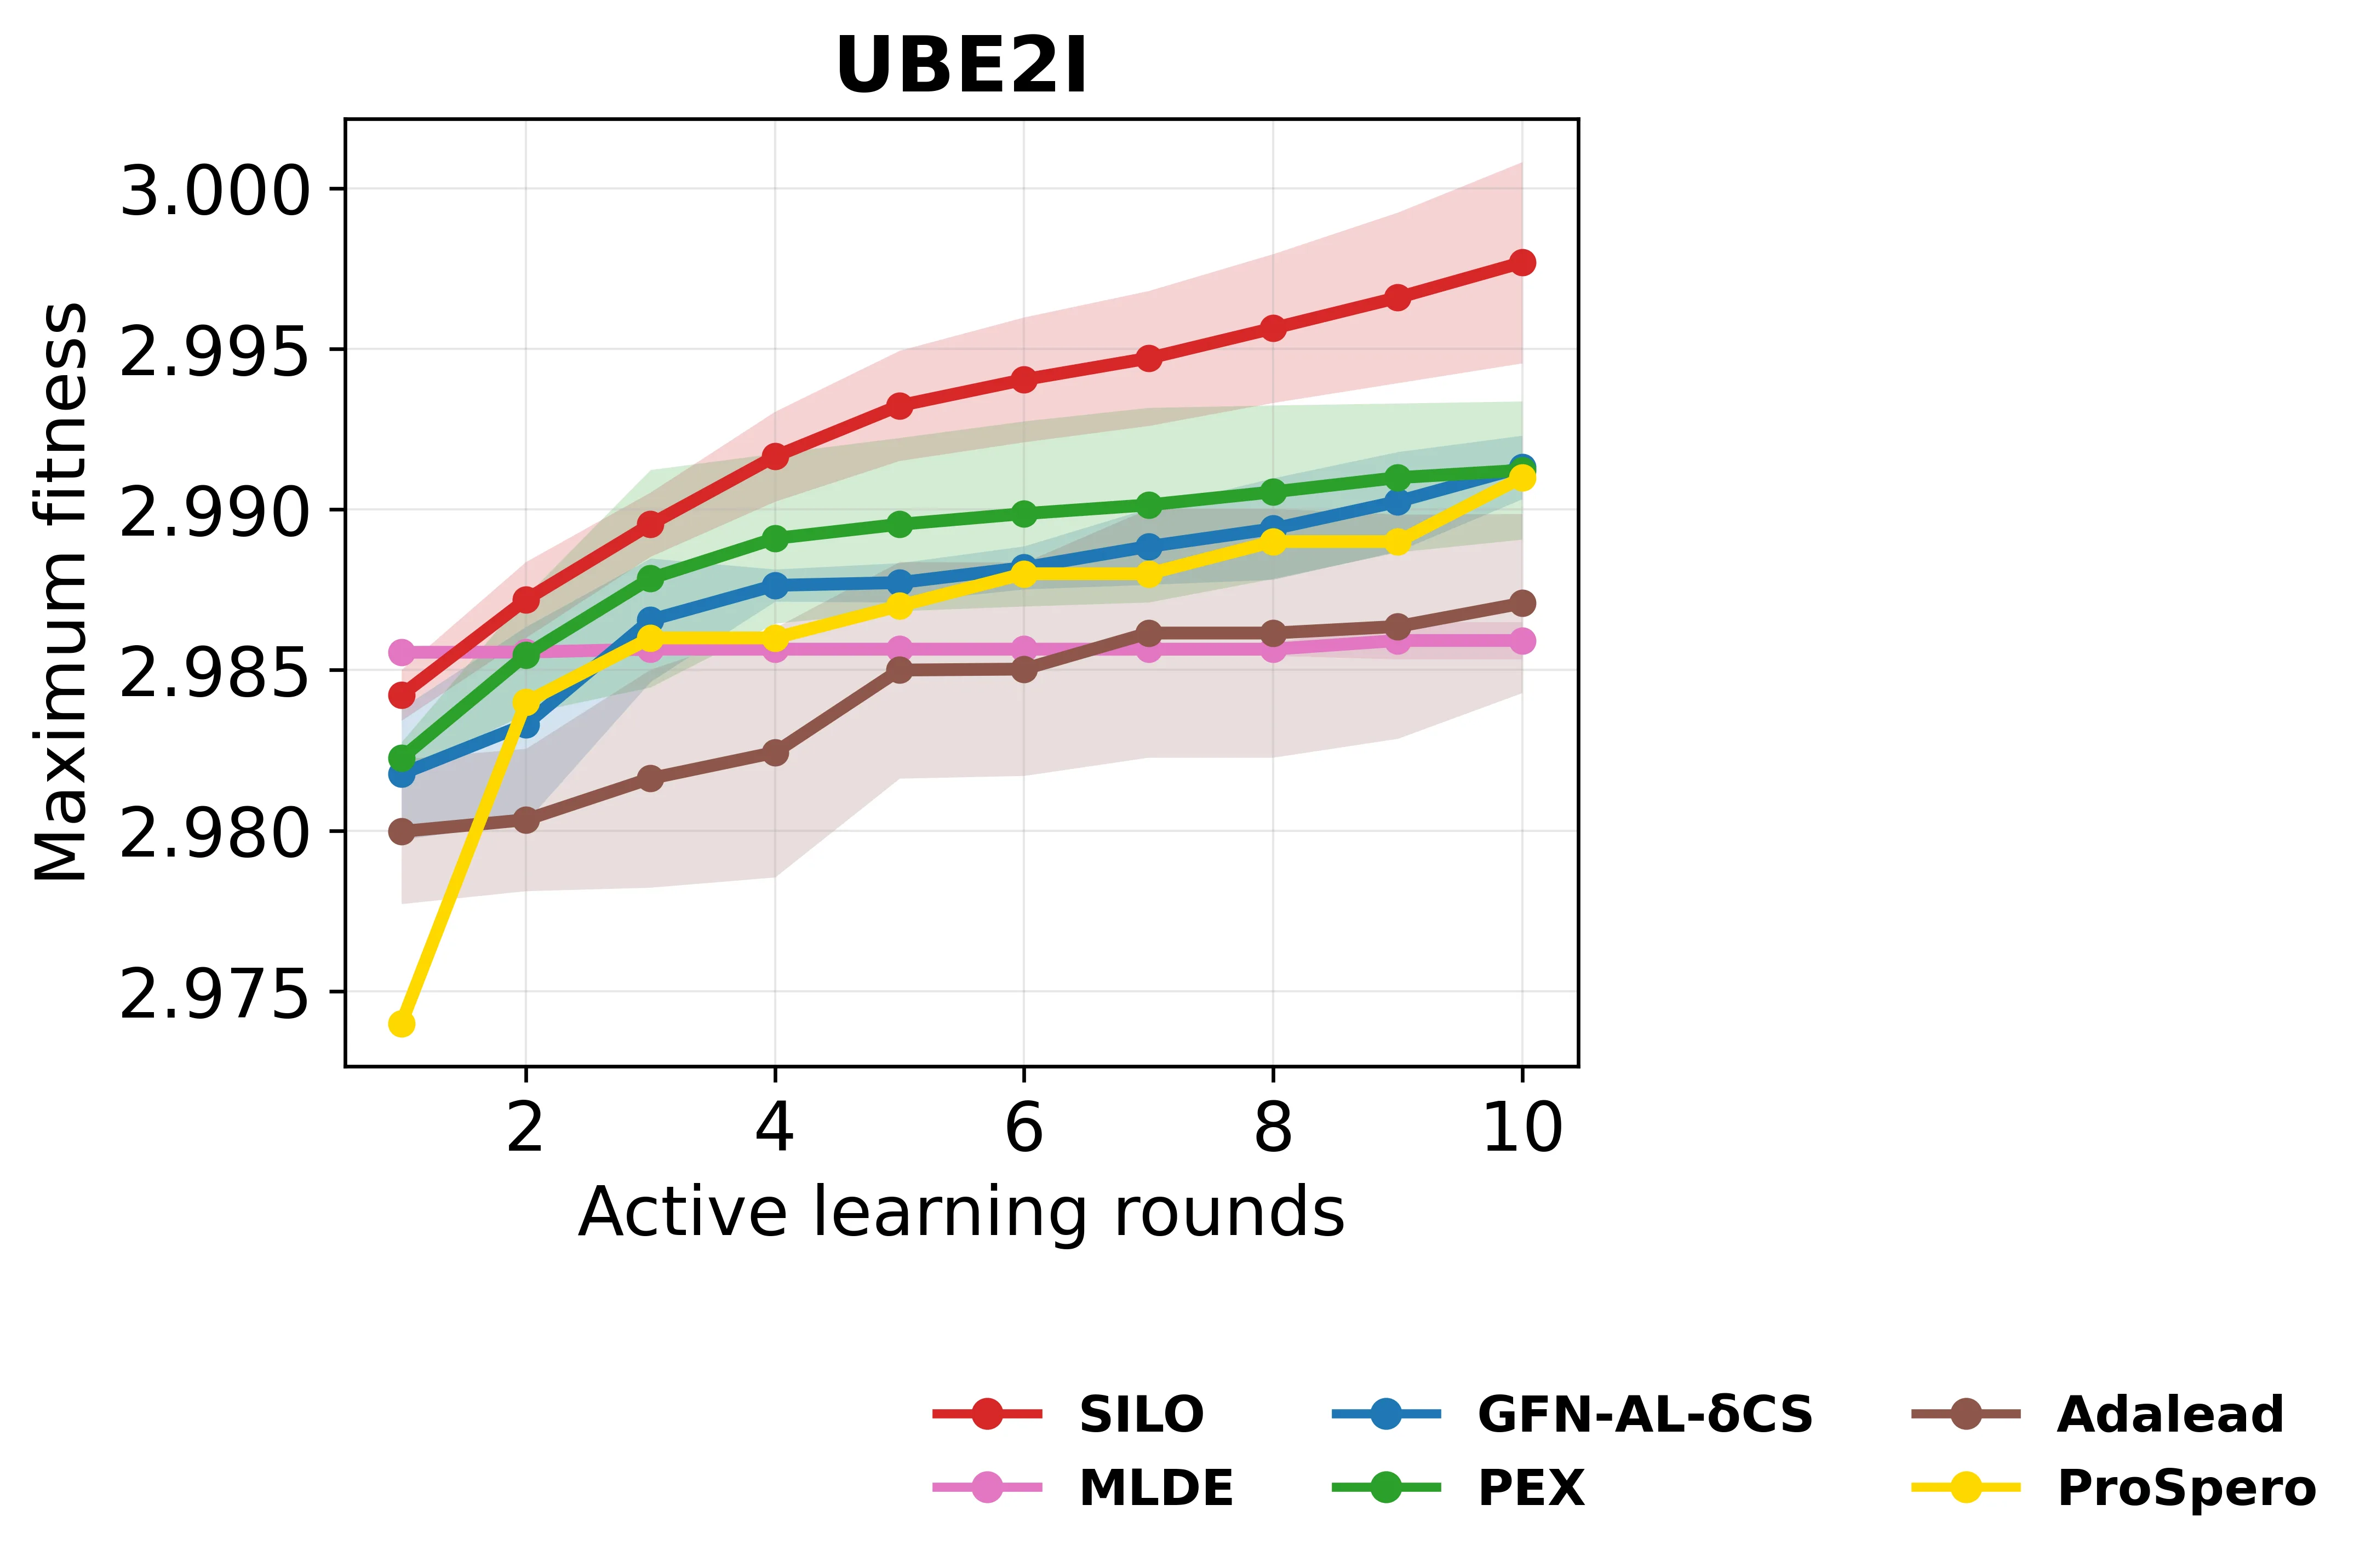
Mejorar la receta de un plato complejo es un arte delicado, sobre todo si solo puedes probar unas pocas variantes al día. Cambiar los ingredientes al azar es arriesgado: quitas la sal o la levadura y la base se echa a perder. Algo parecido ocurre con las proteínas: las mutaciones aleatorias suelen romper partes vitales, y cada prueba de laboratorio cuesta tiempo y dinero.
El nuevo enfoque, llamado SILO, actúa de otra manera. Divide cada cambio en dos pasos: primero elige una posición en la cadena de la proteína y luego decide qué aminoácido colocar allí. Esto recuerda a reparar un motor: el mecánico no cambia todas las piezas en fila, sino que busca el componente específico que falla y le busca el repuesto adecuado. Además, SILO usa un truco ingenioso: la 'prueba de alanina'. Sustituye temporalmente la posición por el ladrillo más simple (alanina) para ver cuán importante es para el funcionamiento de la proteína. Así, el algoritmo evita tocar los puntos críticos.
Durante la búsqueda, SILO acumula experiencia. En cada ronda genera varias variantes, las prueba en un modelo computacional y recuerda las más exitosas. Luego aprende a imitar esos movimientos ganadores, sin intentar predecir la 'puntuación' exacta de cada cambio, porque esas puntuaciones suelen ser ruidosas y confusas. Este enfoque se parece al aprendizaje de un cocinero: en lugar de calcular la temperatura perfecta del horno con fórmulas, simplemente repite los gestos del chef cuando prepara la mejor versión del plato.
La conclusión es simple: para crear la proteína ideal no hace falta probarlo todo. Basta con recordar tus mejores pasos y sortear con cuidado las zonas frágiles, como un artesano que conoce su herramienta y no estropea la pieza en bruto.
Resumen original
tal como lo escribieron los autores, en inglés arXiv:2605.26690
Protein sequence optimization under tight oracle budgets requires methods that explore vast combinatorial spaces while making each evaluation informative. Existing reinforcement learning and off-policy generative approaches often degrade under surrogate noise, and position-agnostic mutation proposals risk disrupting functionally critical residues. We introduce SILO, a trajectory-level self-improvement imitation framework for oracle-budgeted protein design. SILO uses a hierarchical edit policy that decomposes each mutation into a position choice followed by a residue choice. In each active-learning round, the policy samples candidate trajectories via incremental stochastic beam search without replacement (SBS), and a UCB-based proxy ensemble, combined with an alanine-scan fitness score (AFS), selects candidates with functionally relevant edits for in silico oracle evaluation. The policy is then updated by next-action cross-entropy imitation on the round's best oracle-labeled trajectories, avoiding value-function estimation. Across eight reproduced protein fitness landscapes and five strong baselines from prior work, SILO achieves the highest maximum and top-100 mean fitness on 8 of 8 landscapes within our evaluations, often exhibiting faster early-stage improvement. In low-data and noisy-proxy stress tests on two landscapes per setting, SILO remains competitive or best when several baselines degrade. Ablations show that SBS with AFS account for much of the gains, with iterative imitation providing additional improvement. Code is available at: https://github.com/grimmlab/SILO.git
La prueba de alanina que usa SILO se inventó en la década de 1980: los biólogos reemplazaban los aminoácidos por alanina uno tras otro para localizar los 'puntos calientes' importantes para el funcionamiento de la proteína. Es como comprobar qué botón del ascensor está roto pulsándolos uno a uno.