Molecular property prediction is a computational method using graph neural networks and AI to estimate material characteristics without laboratory experiments.
La predicción de propiedades moleculares es un campo interdisciplinario en la intersección de la química, la física y la informática, donde los modelos informáticos se entrenan con datos experimentales para estimar las características de las moléculas sin síntesis de laboratorio. Los modelos pueden basarse en leyes físicas (mecánica cuántica) o en el análisis estadístico de grandes volúmenes de datos (aprendizaje automático). Predicen parámetros como toxicidad, actividad biológica, solubilidad, punto de fusión e incluso el color de la sustancia.
Historia
Las raíces se remontan a la década de 1960, cuando Corwin Hansch formuló las relaciones cuantitativas estructura-propiedad (QSAR), proponiendo ecuaciones lineales que vinculan la hidrofobicidad de los sustituyentes con la actividad biológica. En los años 1970-80, el desarrollo de la computación permitió incluir índices químico-cuánticos y descriptores tridimensionales. El punto de inflexión llegó en la década de 2010 con la aparición del aprendizaje profundo y la disponibilidad de GPU: los modelos aprendieron a "leer" moléculas directamente desde la estructura del grafo, logrando alta precisión en la predicción de solubilidad, toxicidad y energías de estados excitados. Hoy, la predicción de propiedades es parte integral del cribado virtual en farmacia y del diseño de nuevos materiales.
Cómo funciona
La base de cualquier predicción es la representación de la molécula en un espacio de descriptores o una representación vectorial. Los descriptores más simples son el conteo de átomos de un cierto tipo, la masa molecular, el área superficial. Los más complejos codifican información sobre anillos, donantes/aceptores de enlaces de hidrógeno, cargas parciales (calculadas, por ejemplo, mediante el método de Gasteiger). En las redes neuronales de grafos, cada átomo recibe un vector de características que se actualiza iterativamente con mensajes de los átomos vecinos; el vector molecular final se agrega y se pasa a una capa totalmente conectada que emite la predicción. El entrenamiento minimiza una función de pérdida, como el error cuadrático medio para propiedades continuas o la entropía cruzada para clasificación. Las leyes físicas más importantes en las que se basan los métodos cuánticos son: la ecuación de Schrödinger (estacionaria y dependiente del tiempo) y el principio de Pauli (prohibición de que dos fermiones ocupen el mismo estado cuántico). Para los modelos estadísticos, la física explícita no es necesaria, pero la elección de características a menudo está motivada por el principio "similar es similar": moléculas similares tienen propiedades cercanas. La calidad del modelo se verifica en un conjunto de prueba utilizando métricas (R², RMSE, AUC).
En la práctica
Acelera el desarrollo de nuevos materiales y medicamentos, desde plásticos biodegradables hasta fármacos dirigidos contra el cáncer.
Dato curioso
Los algoritmos modernos pueden comprobar millones de variantes moleculares en segundos para un nuevo fármaco, mientras que la síntesis y prueba de una sola molécula en el laboratorio lleva semanas y cuesta miles de dólares.
En la escena del crimen se encuentra una mancha. El experto toma un hisopo y, unas horas después, el instrumento entrega una lista de las proteínas que componían el fluido. Antes, una prueba rápida podía fallar si había varios fluidos: la sangre se mezclaba con la saliva y la tira reactiva daba un resultado falso.
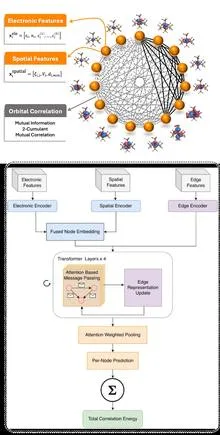
Un cartógrafo que dibuja no montañas ni ríos, sino las conexiones invisibles entre electrones: así podría describirse la nueva red neuronal. En lugar de coordenadas atómicas, toma orbitales moleculares y traza un grafo donde los nodos son los orbitales y las aristas, sus medidas de entrelazamiento cuántico.
Una proteína en la célula no permanece inmóvil, como un maniquí en un escaparate. Sus átomos tiemblan, se estiran y se doblan constantemente, como una cuerda de guitarra tensa que sigue sonando después de que la rozas con el dedo. Para entender cómo funciona una proteína, hay que saber con qué firmeza cada parte se aferra a sus vecinas.
Una proteína en la célula no permanece inmóvil, como un maniquí en un escaparate. Sus átomos tiemblan, se estiran y se doblan constantemente, como una cuerda de guitarra tensa que sigue sonando después de que la rozas con el dedo. Para entender cómo funciona una proteína, hay que saber con qué firmeza cada parte se aferra a sus vecinas.
Un ingeniero de proteínas se parece a un cocinero que intenta hacer un plato que sea a la vez sabroso, saludable y barato. Al cambiar un ingrediente, corre el riesgo de estropear otro. Antes, los asistentes informáticos solo podían evaluar las propiedades de las proteínas por separado, sin ver cómo se relacionan entre sí.
Un intérprete se distrae con cada ruido en la sala, y una reunión de una hora se convierte en dos. Algo parecido ocurre con los modelos fundamentales moleculares: aprenden el lenguaje de las moléculas a partir de corpus enormes, pero para cada nueva conversación requieren un ajuste. Monroe cambia las reglas: no aprende un idioma nuevo, sino que capta al instante el sentido común a partir de unos pocos ejemplos.
Un ingeniero de proteínas se parece a un cocinero que intenta hacer un plato que sea a la vez sabroso, saludable y barato. Al cambiar un ingrediente, corre el riesgo de estropear otro. Antes, los asistentes informáticos solo podían evaluar las propiedades de las proteínas por separado, sin ver cómo se relacionan entre sí.
Buscar un material nuevo es como cocinar sin receta: pruebas y pruebas, y a menudo tiras todo a la basura. Antes, los científicos revisaban manualmente los artículos y probaban las composiciones una por una. Ahora ha aparecido un "chef robot" que lee la literatura, mezcla los componentes y observa el resultado.
El instrumento ilumina la muestra con un haz infrarrojo y las moléculas responden con su patrón de absorción, como campanillas de distinto tono. Ese patrón, el espectro, guarda información sobre la composición química.
El instrumento ilumina la muestra con un haz infrarrojo y las moléculas responden con su patrón de absorción, como campanillas de distinto tono. Ese patrón, el espectro, guarda información sobre la composición química.
En una cacerola con agua flotan esferas microscópicas: partículas coloidales. Cada esfera está cubierta de largos hilos poliméricos, semejantes a un cepillo, y lleva una carga eléctrica. Si se ajustan bien la temperatura y la composición de la disolución, las esferas comienzan a ordenarse por sí solas en patrones regulares: cristales.
Una computadora normal calcula haciendo circular cargas eléctricas por los cables. ¿Y se puede calcular con calor? Una red de tubos por los que circula agua caliente y fría puede realizar operaciones lógicas simples si se conectan los tubos en el orden adecuado.
Cuando el azúcar cae en el té, se disuelve. Pero, ¿por qué no vuelve a precipitarse? Todo se debe al potencial químico, una magnitud que indica cuán "conveniente" es para una sustancia encontrarse en un lugar y estado determinados. Para una sustancia pura es fácil de calcular, pero para una mezcla de varios componentes es un verdadero rompecabezas.
Cuando el azúcar cae en el té, se disuelve. Pero, ¿por qué no vuelve a precipitarse? Todo se debe al potencial químico, una magnitud que indica cuán "conveniente" es para una sustancia encontrarse en un lugar y estado determinados. Para una sustancia pura es fácil de calcular, pero para una mezcla de varios componentes es un verdadero rompecabezas.
Un libro de cocina sin lista de ingredientes: eso es lo que enfrenta un científico al ver un esquema de reacciones químicas. Las flechas y fórmulas en el papel se ven ordenadas, pero en cuanto empiezas a buscar en el laboratorio moléculas que se comporten exactamente así, comienza una verdadera aventura.
Un libro de cocina sin lista de ingredientes: eso es lo que enfrenta un científico al ver un esquema de reacciones químicas. Las flechas y fórmulas en el papel se ven ordenadas, pero en cuanto empiezas a buscar en el laboratorio moléculas que se comporten exactamente así, comienza una verdadera aventura.
Dentro de cada célula, constantemente hay moléculas que se encuentran y se separan. Algunas parejas se mantienen unidas con fuerza, como un velcro; otras apenas se rozan, como el polen al viento. Son precisamente estos roces fugaces, cuya fuerza de unión es comparable a la disolución de un grano de sal en un vaso de agua, los que controlan muchas señales y decisiones celulares.
Predecir el rendimiento de una reacción química es como intentar adivinar la cosecha conociendo solo la composición del suelo. Tradicionalmente, los químicos se apoyaban en largas columnas de números —los descriptores cuánticos— que describen la energía de los electrones, pero no dicen nada sobre la forma de la molécula.
Predecir el rendimiento de una reacción química es como intentar adivinar la cosecha conociendo solo la composición del suelo. Tradicionalmente, los químicos se apoyaban en largas columnas de números —los descriptores cuánticos— que describen la energía de los electrones, pero no dicen nada sobre la forma de la molécula.
Una molécula polar se parece a una pesa diminuta con cargas distintas en sus extremos. Normalmente, estas partículas se pegan o se separan rápidamente al encontrarse: las fuerzas eléctricas son demasiado fuertes. Pero los autores del trabajo encontraron la manera de convertir esa agresividad en un juego controlable.
Una proteína en la célula no es una pieza rígida, sino más bien un guante suave que puede envolver distintos objetos. Hasta ahora, los diseñadores de proteínas trabajaban como escultores, creando una llave para una única cerradura: un objetivo, una forma.
Dentro de cada célula bulle su propia logística: diminutos motores proteicos, como mensajeros, transportan cargas a lo largo de una red de microtúbulos. Uno de los principales trabajadores es la cinesina, que avanza utilizando la energía del ATP (la principal moneda energética de la célula).
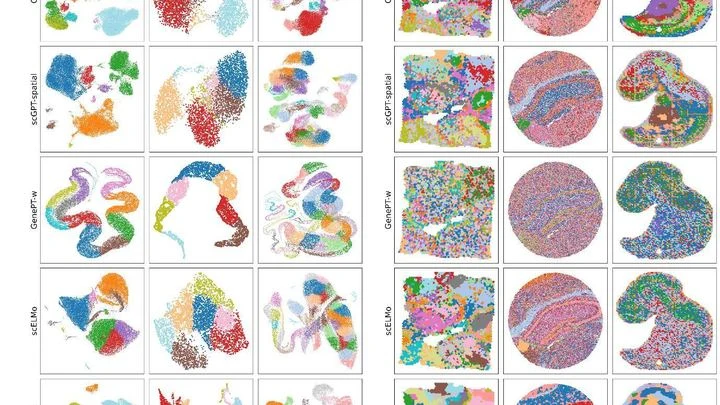
Cada vez más, los biólogos confían a las computadoras la lectura de las "instrucciones de uso" de una célula viva. Seis modelos recientes de inteligencia artificial —Nicheformer, CellPLM, scGPT-spatial, GenePT, scELMo y Novae— son como seis traductores de diferentes dialectos del mismo lenguaje celular.
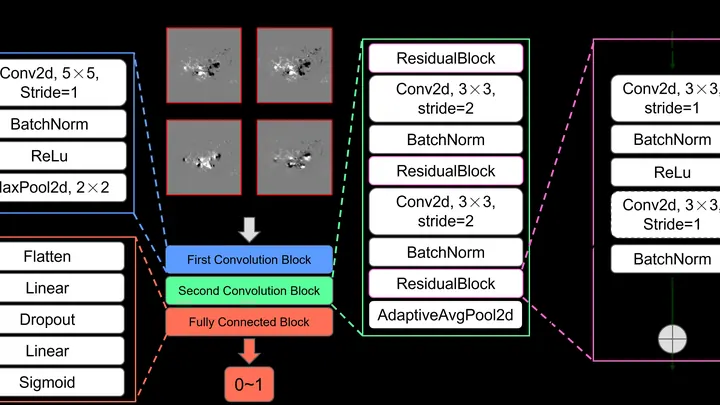
El Sol dibuja sin cesar garabatos de campos magnéticos en su superficie. Estos patrones no son meras ondulaciones, sino una escritura en la que la naturaleza ha cifrado advertencias sobre erupciones.
Una biblioteca enorme donde cada libro es una instrucción precisa para ensamblar una molécula de proteína. La red neuronal AlphaFold2 ha leído millones de estos libros y ha aprendido a generar al instante un modelo tridimensional ya terminado.
La inteligencia artificial que predice la acústica de una sala se parece a un estudiante en un examen con una chuleta. Si los puntos de prueba son los mismos que los de entrenamiento, el modelo simplemente memoriza la 'huella sonora' de cada posición, como un estudiante que reconoce el examen por una esquina doblada.
Un grupo de búsqueda rastrea un campo brumoso. Al principio, las personas se dispersan ampliamente: una alta 'temperatura' de búsqueda significa una gran variedad de intentos. Al encontrar un rastro, se acercan. Pero la velocidad de acercamiento es crítica: si se estrecha el círculo demasiado pronto, el mejor hallazgo quedará fuera.
En una sopa hirviendo, las moléculas chocan caóticamente y reaccionan. Pero si medimos cómo cambian sus concentraciones, emergen patrones. Así funcionan las redes químicas de carbono: mezclas de moléculas que espontáneamente «cocinan» información, convirtiendo cada reacción en un cálculo elemental. Antes solo se usaban para modelar la naturaleza.
En una olla de sopa, bastan dos termómetros para saber la temperatura en todas partes, si se sabe que el calor sube en círculos desde el fondo. Así ocurre en la ciencia: a partir de pocas mediciones hay que reconstruir la imagen completa del campo térmico.
Un conductor en una carretera resbaladiza no sabe exactamente cómo reaccionará el coche al volante, y aprende sobre la marcha, dejando margen para el error. De manera similar se comporta un algoritmo de control inteligente.
Cuando una estrella gigante colapsa en una supernova o dos bolas de neutrones se fusionan en una danza cósmica, billones de neutrinos se llevan la energía del cataclismo.
Preparar un plato complejo exige una receta clara: primero cortar, luego sofreír, añadir las especias en el momento justo. Las transformaciones químicas también siguen recetas paso a paso, mecanismos donde los átomos de carbono e hidrógeno se reorganizan en un orden estricto.
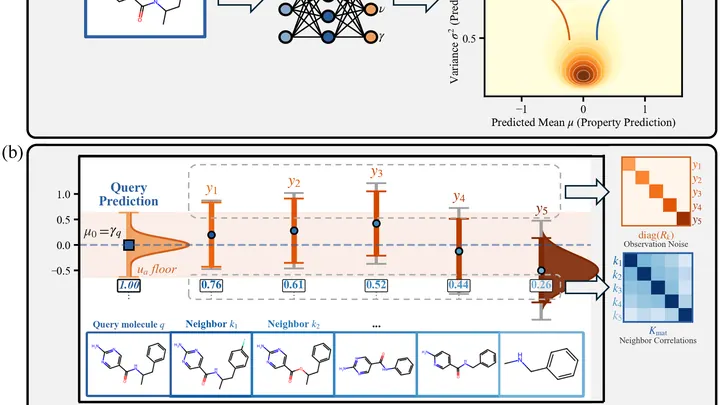
Predecir las propiedades de una nueva molécula es como adivinar el sabor de un plato desconocido. El programa funciona como un cocinero experimentado: «prueba» moléculas similares cuyas propiedades ya se conocen y, basándose en su «sabor», ajusta su conjetura.
La tecnología compleja —desde drones hasta robots cirujanos— a veces se comporta como un mustang salvaje: llena de desorden y caprichos, donde un leve contacto provoca una tormenta. En lugar de memorizar fórmulas, el nuevo método observa el sistema como un jinete adiestrador.
Un detective experimentado no calcula la trayectoria de un criminal a partir de las leyes de la física: consulta el archivo de casos similares. Así funciona este nuevo método de predicción: en lugar de ecuaciones complejas, dispone de un enorme archivo de trayectorias ya ocurridas: movimientos planetarios, cotizaciones de divisas, señales del espacio.
El microscopio electrónico es un órgano gigante: en lugar de tubos, lentes electromagnéticas; en lugar de aire, un flujo de electrones acelerados. Antes solo pintaba frescos mudos del mundo atómico, condenando a los científicos a una descodificación extenuante.
Mira el cielo nocturno: no es un puñado de luces, sino un manuscrito de múltiples capas. Bajo la brillante tinta de las estrellas y las galaxias aflora un texto pálido, casi borrado.
Has recibido un informe: en tu gen se ha reemplazado una "letra". Pero, ¿qué cambia eso? Una proteína no es una línea plana, sino una madeja compacta donde cada bucle se asienta en su hueco. Una sustitución en el interior de esa madeja es como una grieta en los cimientos, y en la superficie, como un arañazo en la fachada.
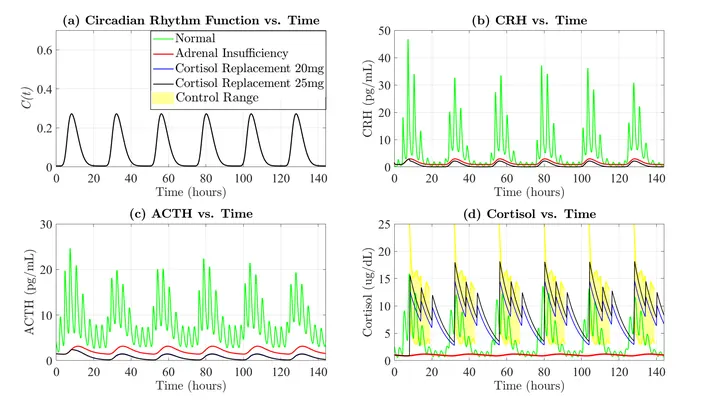
Dentro de cada uno de nosotros laten unos relojes invisibles. Controlan la liberación de cortisol, la hormona que nos ayuda a despertarnos por la mañana, a lidiar con la ansiedad y a mantener el sistema inmunitario en forma. En la insuficiencia suprarrenal, estos relojes se estropean: el cuerpo no puede producir por sí solo la cantidad necesaria de cortisol.
Las perovskitas híbridas son las estrellas emergentes de la fotovoltaica: su eficiencia crece tan rápido que parece que estamos al borde de una revolución solar. Pero estos materiales, como intrincados mosaicos de átomos, son extremadamente vulnerables: la humedad, el calor y la luz los convierten rápidamente en polvo.