Un modèle de langue assemble une protéine comme un puzzle express
Une protéine ressemble à un collier de perles – les acides aminés – qui se replie en une forme bien précise, et c'est cette forme qui détermine son rôle dans la cellule. Les concepteurs de protéines déplacent les perles pour obtenir la forme voulue, mais le nombre de combinaisons est immense. Le réseau de neurones LigandMPNN ne propose qu'une variante à la fois, un peu comme quelqu'un qui assemble un puzzle et qui, dès le premier essai, place la pièce au mauvais endroit.
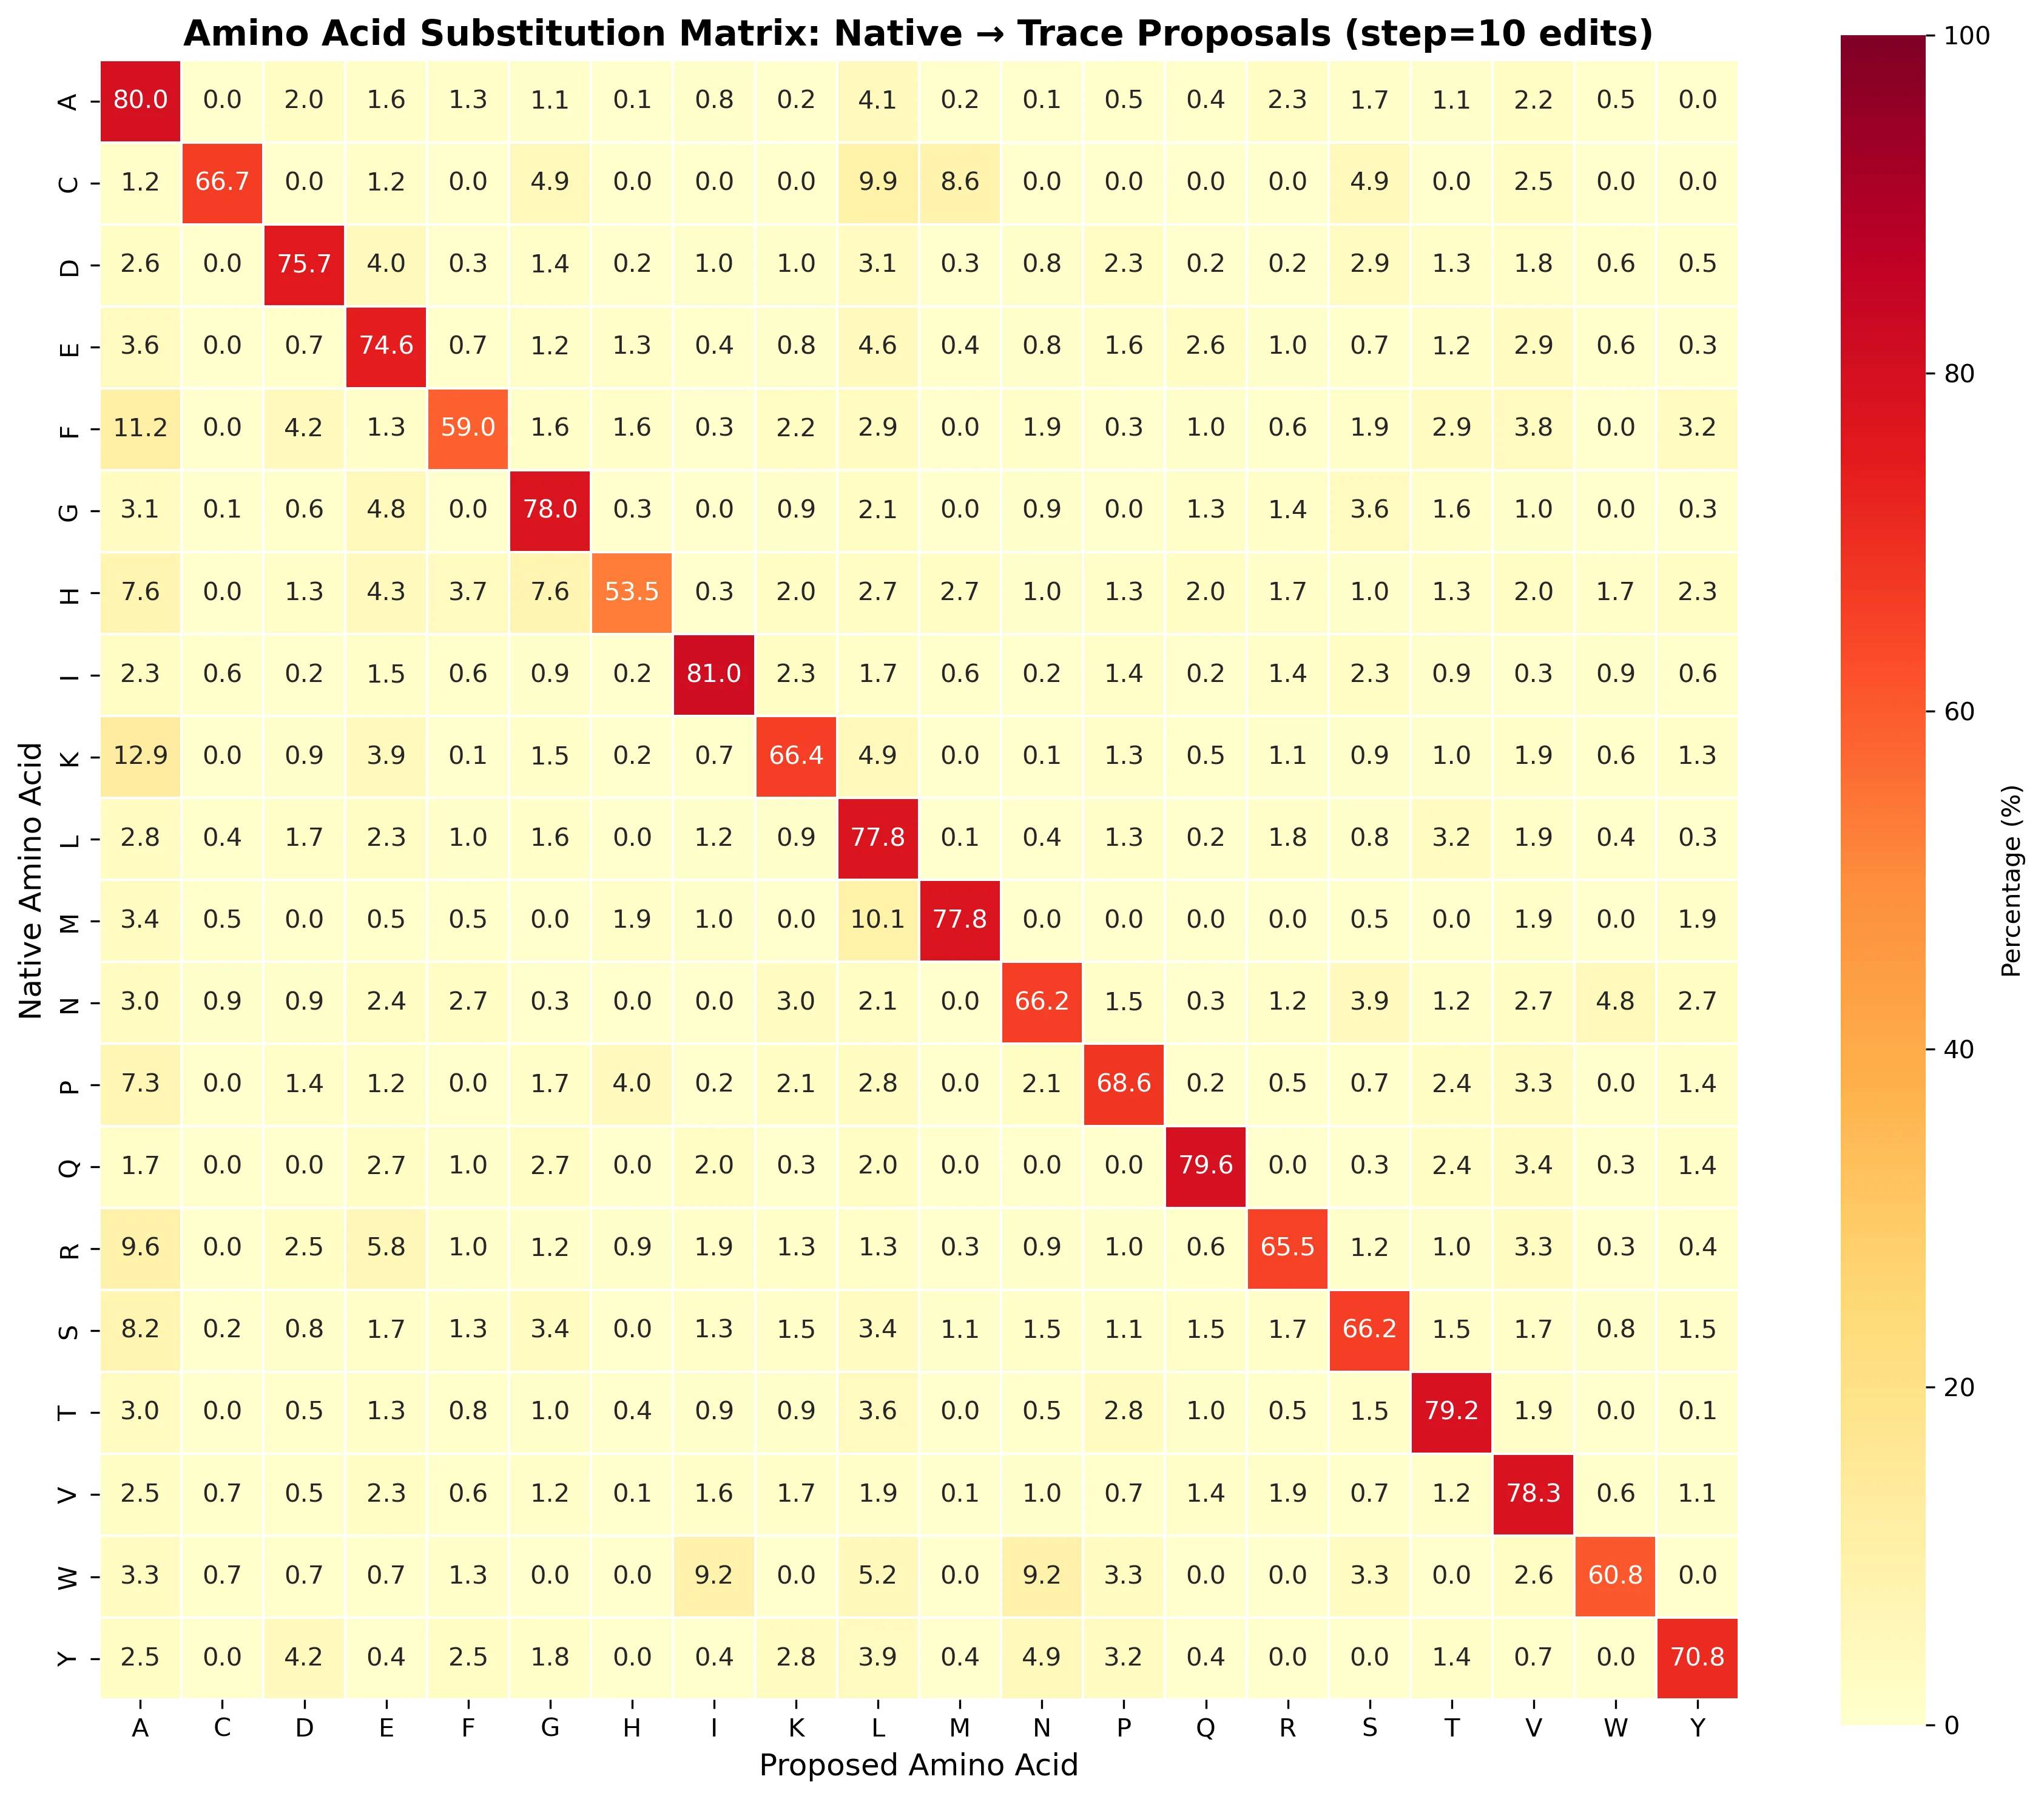
La nouvelle méthode RosettaSearch utilise un grand modèle de langue comme générateur d'idées. Le modèle propose de nombreuses séquences modifiées, et le programme RosettaFold3 vérifie rapidement dans quelle mesure chacune se replie en la structure cible. La recherche s'effectue sous un budget de calcul serré : comme un cuisinier qui goûte son plat, ajoute une pincée de sel, goûte à nouveau – et ainsi de suite jusqu'à la perfection. Lors d'un test sur 400 protéines pour lesquelles LigandMPNN avait donné des variantes ratées, RosettaSearch a trouvé des améliorations dans 18 à 68 % des cas, et le succès global a été multiplié par 2,5. La méthode fonctionne aussi sur des structures entièrement nouvelles, générées par ordinateur.
Fait intéressant, la qualité des améliorations augmente avec la « capacité de raisonnement » du modèle : les versions plus puissantes (o4-mini et Gemini-3) s'en sortent mieux. On peut aussi ajouter la vision : le modèle regarde une image de la structure prédite de la protéine et en tient compte lors de la génération. C'est la première grande démonstration que les modèles de langue peuvent servir d'optimiseurs pour la conception de protéines, sans apprentissage laborieux.
Résumé original
tel que rédigé par les auteurs, en anglais arXiv:2604.17175
We introduce RosettaSearch, an inference-time multi-objective optimization approach for backbone conditioned protein sequence design. We use large language models (LLMs) as a generative optimizer within a search algorithm capable of controlled exploration and exploitation, using rewards computed from RosettaFold3, a structure prediction model, under a strict computational budget. In a large-scale evaluation, we apply RosettaSearch to 400 suboptimal sequences generated by LigandMPNN (a state-of-the-art model trained for protein sequence design), recovering high-fidelity designs that LigandMPNN's single-pass decoding fails to produce. RosettaSearch's designs show improvements in structural fidelity metrics ranging between 18% to 68%, translating to a 2.5x improvement in design success rate. We observe that these gains in success rate are robust when RosettaSearch-designed sequences are evaluated with an independent structure prediction oracle (Chai-1) and generalize across two distinct LLM families (o4-mini and Gemini-3), with performance scaling consistently with reasoning capability. We further demonstrate that RosettaSearch improves the sequence fidelity of ProteinMPNN designs for de novo backbones from the Dayhoff atlas, showing that the approach generalizes beyond native protein structures to computationally generated backbones. We also demonstrate a multi-modal extension of RosettaSearch with vision-language models, where images of predicted protein structures are used as feedback to incorporate structural context to guide protein sequence generation. To our knowledge, this is the first large-scale demonstration that LLMs can serve as effective generative optimizers for backbone-conditioned protein sequence design, yielding systematic gains without any model retraining.
Les protéines ne sont faites que de 20 types d'acides aminés, mais leurs combinaisons offrent plus de possibilités qu'il n'y a d'atomes dans l'Univers.
Dans le roman « Solaris » de Stanislas Lem, l'océan crée des structures à la demande des humains – RosettaSearch fait quelque chose de similaire pour les protéines, mais pour l'instant en éprouvette.