L'apprentissage contrastif est une approche en apprentissage automatique qui permet de construire des représentations de données de qualité sans étiquetage (apprentissage auto-supervisé). Il s'appuie sur la notion de perte contrastive : le modèle attire les représentations (plongements) d'objets sémantiquement proches (paires positives) et repousse les représentations d'objets non liés (paires négatives). Par exemple, pour les images, les paires positives sont différentes vues (augmentations) d'une même photo, tandis que les négatives sont toutes les autres images du mini-lot. Ainsi, le réseau neuronal apprend à extraire des caractéristiques invariantes, en ignorant les variations non essentielles d'éclairage, de rotation, d'échelle. La méthode a servi de base à de nombreux systèmes de reconnaissance modernes, où elle surpasse souvent l'apprentissage supervisé avec peu d'étiquettes.
Histoire
Les racines remontent à l'apprentissage métrique : les réseaux siamois (Bromley et al., 1993) pour la comparaison de signatures. En 2006, Hadsell et LeCun ont proposé la perte contrastive pour l'apprentissage de représentations invariantes. Le regain d'intérêt est lié aux progrès de l'apprentissage auto-supervisé pour les images : en 2018, le modèle InstDisc (Wu et al.) utilisait un memory bank ; les percées ont été MoCo (He et al., 2020) avec une file d'attente d'exemples négatifs et SimCLR (Chen et al., 2020) avec une grande taille de lot et une forte augmentation. Ces travaux ont montré que le pré-entraînement contrastif atteint une précision proche de l'apprentissage supervisé, et le dépasse parfois lors du réglage fin sur de petits échantillons. Par la suite, l'approche a été adaptée pour la vidéo, l'audio, les graphes et les données multimodales (CLIP, 2021).
Comment ça marche
L'algorithme comprend trois étapes : (1) l'augmentation stochastique des données crée deux représentations indépendantes d'une même entrée (par exemple, recadrage aléatoire, distorsion de couleur) ; (2) un encodeur (ResNet, ViT) les projette dans des vecteurs d'un espace latent ; (3) une tête de projection (MLP) les transforme dans un espace de dimension réduite où l'on calcule la perte contrastive InfoNCE : L = -log[ exp(sim(z_i, z_j)/τ) / ∑_{k=1}^{2N} 1_{k≠i} exp(sim(z_i, z_k)/τ) ], où sim est la similarité cosinus, τ un paramètre de température. L'optimisation réduit l'entropie croisée entre la distribution des paires positives et négatives. Pour éviter l'effondrement des représentations (tous les vecteurs convergeant vers un même point), on utilise des mécanismes : paires négatives issues d'une file d'attente (MoCo), arrêt du gradient et prédicteur (BYOL), clustering (SwAV). Au final, l'espace latent acquiert une structure sémantique invariante aux transformations appliquées.
En pratique
Reconnaissance de visages sans étiquettes, recherche d'images similaires dans de grandes archives, amélioration des diagnostics à partir d'images médicales lorsque les données annotées sont rares.
Anecdote
Le système CLIP d'OpenAI, entraîné de manière contrastive sur des paires image-texte, est capable de peindre des tableaux à partir d'une description, bien qu'il n'ait jamais appris le style artistique directement — il a simplement saisi les corrélations.
Un interprète dans une salle où l'on parle simultanément trois langues n'entend d'abord qu'un brouhaha général. Mais s'il se met à faire répéter, à tendre l'oreille vers les intonations et à préciser sans cesse qui a répondu par quelle phrase, peu à peu des voix distinctes émergent de la cacophonie.
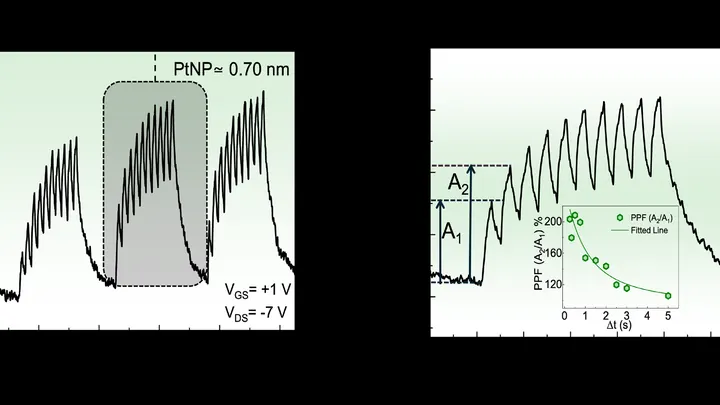
Un film plastique aussi épais qu'un cheveu, et à l'intérieur, des points de platine plus petits qu'un millionième de millimètre. Ces points se nichent à la frontière de deux couches du transistor et capturent la charge électrique comme une éponge absorbe l'eau. Lorsque la charge s'accumule, le transistor modifie sa résistance — et mémorise cet état.
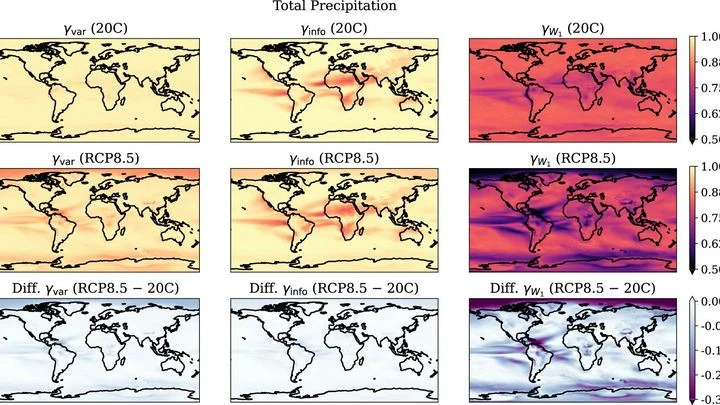
En hiver, dans un quartier de la ville, il tombe trois fois plus de neige que dans le quartier voisin. Une année, c'est la canicule, l'autre, le froid. Ce sont les caprices de la météo. Mais sur des décennies, on observe un autre glissement, plus lent : les hivers deviennent en moyenne plus doux. Distinguer l'un de l'autre est la tâche principale des climatologues.
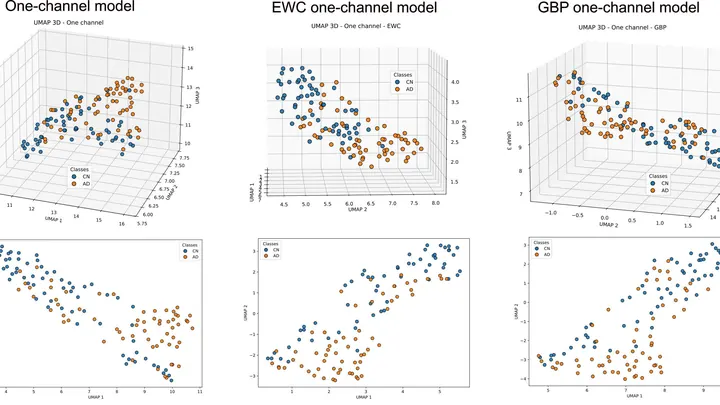
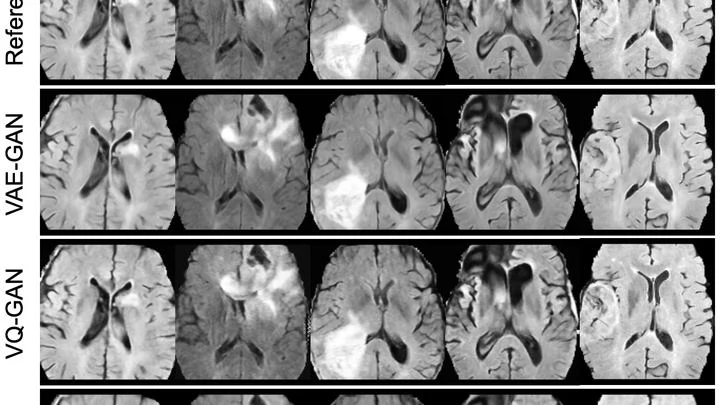
Un médecin passe des années à apprendre à reconnaître les maladies sur les images du cerveau. D'abord, il repère parfaitement les signes du vieillissement, puis il maîtrise les tumeurs – et soudain, il se met à confondre ce qu'il savait auparavant. C'est à peu près ce qui arrive à de nombreux réseaux de neurones : les nouvelles connaissances effacent les anciennes.
Dans un entrepôt, des cartons de pommes et de poires. Les pommes sont nombreuses, les poires rares. Mais quand le magasinier dit « un fruit à la peau lisse », nous pensons plus souvent à la poire rare qu'à la pomme fréquente. C'est l'effet de taux de base inversé : un dérèglement persistant dans la façon dont le cerveau résout l'ambiguïté entre les catégories.
En 1998, le mathématicien David Boyd a remarqué une chose étrange. Il étudiait la mesure de Mahler d'un polynôme — une quantité qui mesure la « complexité » de ses racines — et a découvert que pour une famille de courbes, elle s'exprime toujours par un nombre rationnel spécial, multiplié par la valeur de la dérivée de la fonction L.
Prédire le rendement d'une réaction chimique, c'est un peu comme essayer de deviner la récolte en ne connaissant que la composition du sol. Traditionnellement, les chimistes s'appuyaient sur de longues colonnes de nombres – les descripteurs quantiques – qui décrivent l'énergie des électrons mais restent muets sur la forme de la molécule.
Un réseau de neurones prédit l'avenir d'un système — par exemple, comment le plasma va tourbillonner dans un champ magnétique ou comment un visage va changer dans une vidéo. Les erreurs sont inévitables, et plus il regarde loin, plus elles s'accumulent.
Chaque matin, des dizaines de télescopes se braquent sur le Soleil. Leurs caméras capturent une fine bande de lumière rouge : la raie Hα, découverte par Johann Jakob Balmer. Sur les images, des filaments sombres et capricieusement incurvés apparaissent.
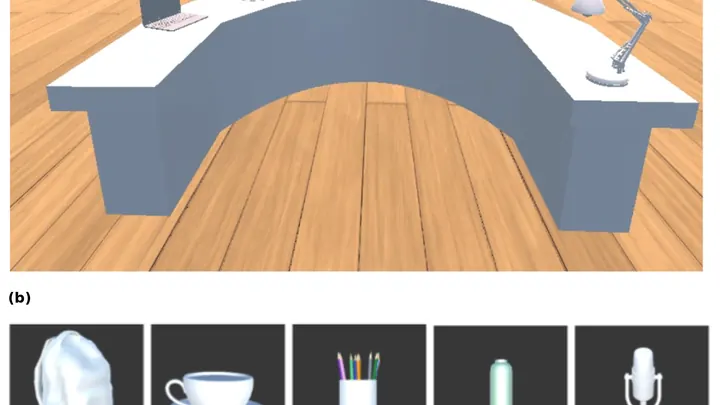
Une prothèse oculaire transmet au cerveau non pas une photographie, mais un pointillé clairsemé de points lumineux — les phosphènes. Pour distinguer une tasse ou des clés dans ce scintillement, la personne doit balayer la tête comme une lampe de poche dans l'obscurité et assembler petit à petit les contours de l'objet.
Une IA classique regarde les images médicales comme des puzzles faits de pièces inconnues : elle considère que deux images non appariées sont complètement différentes. C'est comme essayer de distinguer des jumeaux sans connaître leur lien de parenté. Or, en médecine, les patients atteints d'une même maladie présentent des IRM presque identiques, et l'algorithme se trompe en confondant les « parents ».
Un signal radio à modulation en couches évoque les strates d'une cité antique : chaque niveau porte sa propre information, mais avec le temps, ils s'emmêlent à cause des interférences. Les algorithmes classiques se perdent dans ce fouillis. La nouvelle méthode TSDN agit comme un réseau de neurones archéologue.
Les données d'un seul scan CT équivalent à plusieurs longs métrages. TCAM-Diff contourne ce goulot d'étranglement : le programme compresse la vue tridimensionnelle en trois projections d'ombre, un peu comme un sculpteur qui reconstituerait une statue à partir de ses silhouettes sur trois murs.
L'approche standard pour une classe de problèmes d'apprentissage automatique évoque un ressort étiré qu'on oublie de relâcher : les méthodes standard gonflent artificiellement la taille du problème, transformant les calculs en trou noir pour la mémoire et le temps.
Le cerveau communique par de brefs clics électriques. Autrefois, pour apprendre cette langue, il fallait des milliers d'exemples traduits par l'expérimentateur. La méthode MOJO suit une autre voie : comme dans l'apprentissage par immersion, elle écoute d'abord le « flux de conscience » sans aucune indication et repère elle-même les motifs récurrents.
Imaginez un conducteur sur une route verglacée : il ne connaît pas la réaction exacte de sa voiture aux mouvements du volant et doit apprendre en conduisant, en gardant intuitivement une marge de manœuvre pour une éventuelle erreur. C'est ainsi que fonctionne un algorithme de contrôle adaptatif.
Un enfant qui explore un appartement inconnu rampe d'un objet à l'autre et mémorise ce qu'il voit depuis chaque coin. C'est ainsi que le cerveau construit une carte mentale — un modèle interne de l'espace. L'algorithme gradCSCG fonctionne sur le même principe : il reçoit un flux vidéo d'une caméra et dessine lui-même le plan du lieu, en s'appuyant uniquement sur le changement des images.
Quand vous tapez « salade » et que le clavier propose « césar », en coulisses, des millions de téléphones apprennent ensemble à prédire les mots. Ils n'échangent pas vos messages, mais seulement les améliorations de l'algorithme commun — comme un entraîneur qui envoie aux athlètes uniquement les changements au programme : « ajoutez 5 pompes à ceux d'hier ».
Sur une cuisinière à gaz, chaque brûleur chauffe différemment. Si le cuisinier déplace les casseroles, la nourriture peut brûler. Il en va de même dans un réseau sans fil : les antennes-brûleurs et les utilisateurs-casseroles nécessitent un placement précis. Les réseaux de neurones classiques ne distinguent pas les positions, considérant tous les brûleurs comme identiques.
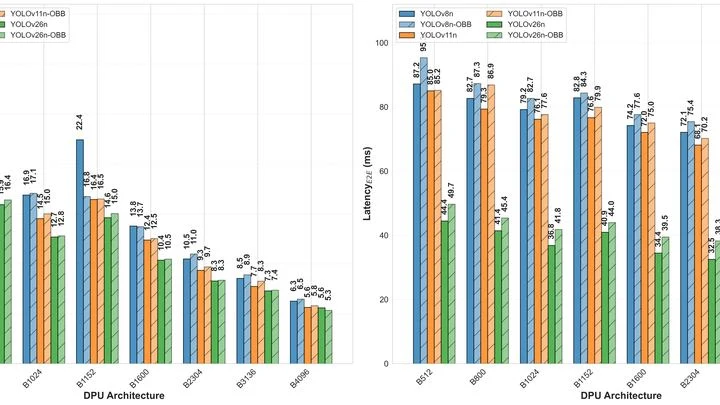
Les systèmes modernes de vision artificielle gagnent en autonomie : des ingénieurs ont réussi à implémenter un algorithme de reconnaissance des formes directement sur une puce miniature, évitant ainsi à la caméra de transmettre des données à un ordinateur encombrant.
La caténaire d'un chemin de fer évoque une galaxie : l'énergie s'y propage comme la gravitation, et les trains deviennent des exoplanètes. Plus les convois consomment du courant en même temps, plus les fluctuations de tension s'amplifient — des ondes gravitationnelles parcourent le système, menaçant de provoquer des coupures.
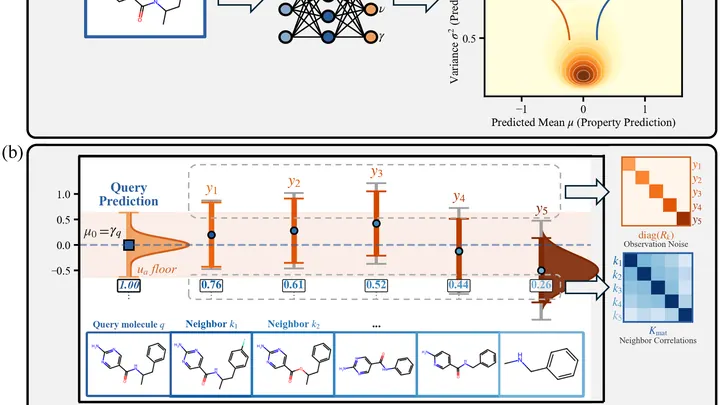
Prédire les propriétés d'une nouvelle molécule, c'est un peu comme deviner le goût d'un plat inconnu. Le programme agit comme un chef expérimenté : il « goûte » des molécules similaires dont les propriétés sont déjà connues et, en se basant sur leur « saveur », affine son estimation.
Un grand réseau de neurones, comme Whisper, maîtrise des centaines de langues et ressemble au modèle standard de l'univers : tout est équilibré. Mais l'apprentissage d'une langue rare rompt cet équilibre — elle se transforme en trou noir qui attire toutes les ressources d'apprentissage.
L'apprentissage automatique n'est plus depuis longtemps un simple outil — il devient un chercheur qui extrait lui-même les lois de la nature à partir des données. Mais comment un esprit de silicium parvient-il à la compréhension ?
La DFTB, c'est le train à grande vitesse de la chimie quantique : des centaines de fois plus rapide que la DFT classique, mais toujours sur des rails électroniques. Cependant, son moteur — l'auto-cohérence itérative des charges — ressemble parfois à un orchestre où chaque instrument commence sur une note arbitraire.
Le microlentillage gravitationnel est un effet cosmique fascinant, prédit par Einstein et développé par Zwicky. Un corps massif, passant entre nous et une étoile lointaine, courbe sa lumière comme une lentille, créant des amplifications et distorsions caractéristiques.
Les profondeurs du cosmos ne sont pas silencieuses — elles regorgent de messages chiffrés. Chaque étoile, chaque quasar envoie son code lumineux tremblotant : rythmé comme le morse d'une céphéide, ou chaotique comme un chiffre brisé de supernova. Les astronomes interceptent ces signaux par millions chaque nuit — mais comment les lire sans clé ?
L'or ne se trouve pas en surface — il est caché dans des tonnes de stérile. Pour extraire un gramme de métal précieux, les chercheurs d'or tamisent des mètres cubes de terre.
Pendant des siècles, les astronomes ont scruté le ciel nocturne, guettant les moindres variations de luminosité des étoiles. Ces séries irrégulières — les courbes de lumière — sont comme des portées musicales : chaque étoile joue sa propre mélodie unique.
Créer un matériau aux propriétés données est un art qui s'est longtemps reposé sur l'intuition et la chance. La nature ne donne aucun indice : des dizaines d'éléments dans le tableau de Mendeleïev, et le nombre de leurs combinaisons tend vers l'infini.
Les réfrigérateurs et climatiseurs modernes aux fréons empoisonnent silencieusement l'atmosphère. L'alternative : les matériaux caloriques à l'état solide, qui se refroidissent lors d'un changement rapide de pression grâce à l'effet barocalorique.
Le cerveau n'apprend pas chaque tâche à partir de zéro : il transfère l'expérience d'une activité à une autre. Mais comment savoir quelles tâches sont réellement apparentées ? Les neuroscientifiques ont eu une idée astucieuse : laisser un réseau artificiel « observer » l'activité cérébrale pendant une tâche, puis tenter de prédire l'activité pendant une autre.
Les détecteurs de rayons X fonctionnent comme un nid d'abeilles : dans les alvéoles hexagonales, des particules scintillent de temps en temps. Les algorithmes classiques étirent ces alvéoles sur une grille carrée, ce qui fait apparaître de faux fantômes de polarisation.
La danse de centaines de particules : certaines paires tournent lentement et avec fluidité, d'autres s'agitent à un rythme effréné. Pour comprendre l'essence de la danse, il faut suivre les mouvements lents – ce sont eux la chorégraphie principale du système.
Un chef ne gaspille pas ses ingrédients en préparant tout le plat pour en évaluer le goût — il goûte une goutte de sauce. C'est la même logique qui sous-tend la méthode du « jumelage d'informations » pour prédire la résistance des métaux.
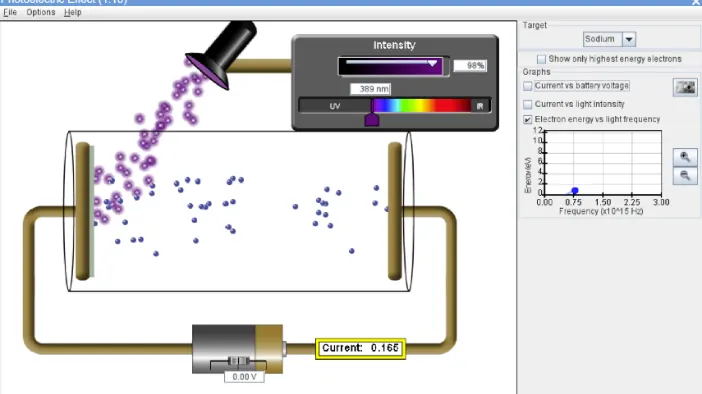
Comprendre l'effet photoélectrique — lorsque la lumière arrache des électrons à un matériau — c'est un peu comme apprendre à cuisiner sans recette. Les outils numériques viennent à la rescousse : les jeux donnent l'intuition, les simulations apportent la précision.
Un traducteur n'apprend pas une langue dans un manuel, mais en écoutant la parole vivante et en voyant immédiatement ce que les gens font en réponse aux mots. C'est exactement ainsi que fonctionne la nouvelle méthode C3P pour lire l'ADN bactérien.
Dans l'océan des transactions bancaires, les fraudes sont plus rares que les étoiles à neutrons dans l'espace — seulement 0,1 % de toutes les opérations. Un détecteur ordinaire s'habitue à tout ce flux propre et perd de sa vigilance.
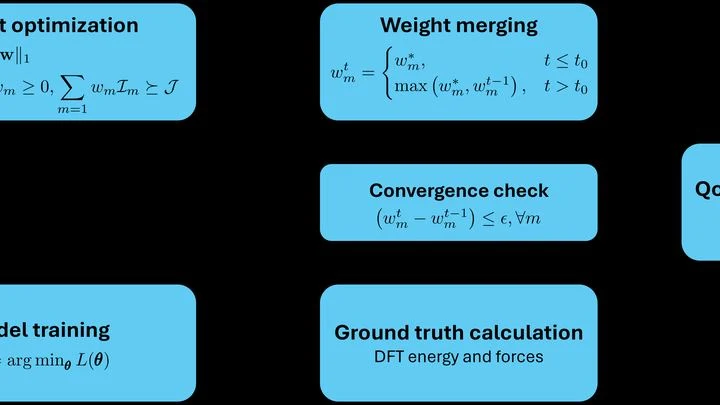
C'est là qu'intervient le système hybride Q-SYNTH avec son générateur quantique.
Vous goûtez un plat au restaurant, mais vous n'avez pas vu le menu. Vous posez des questions au serveur — trop salé ? avec quelles épices ? — et à partir des réponses, vous essayez de deviner quel chef l'a préparé.
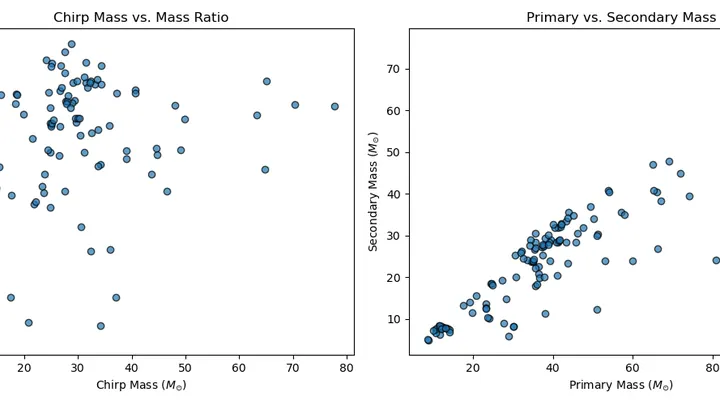
La symphonie joue, mais une note fausse, à peine perceptible, s'est glissée dans la partition. C'est à peu près ainsi que les physiciens recherchent des écarts par rapport à la relativité générale dans les « sons » de l'Univers — les ondes gravitationnelles issues de la fusion de trous noirs.