Un modèle de langage protéique est un type de modèle d'apprentissage automatique entraîné sur de grands ensembles de données de séquences protéiques, de manière analogue à la façon dont les modèles de langage sont entraînés sur des textes. Ces modèles apprennent les motifs statistiques et les relations entre les acides aminés dans les protéines, capturant ainsi les contraintes évolutives et structurelles. Une fois entraînés, ils peuvent être utilisés pour prédire la structure, la fonction et les interactions des protéines, ainsi que pour concevoir de nouvelles protéines aux propriétés souhaitées.
Histoire
Le concept a gagné en importance à la fin des années 2010 et au début des années 2020, avec des modèles comme ProtBERT et ESM (Evolutionary Scale Modeling) de Meta AI, s'appuyant sur les avancées du traitement du langage naturel.
Comment ça marche
Le modèle est généralement un réseau de neurones profond, souvent basé sur des architectures de transformeurs, qui traite les séquences protéiques comme des « phrases » d'acides aminés. Pendant l'entraînement, il apprend à prédire les acides aminés masqués ou manquants en se basant sur le contexte environnant, de la même manière qu'un modèle de langage prédit les mots manquants. Cela force le modèle à internaliser les dépendances complexes entre les acides aminés, qui reflètent les règles physiques et évolutives régissant le repliement et la fonction des protéines. Après l'entraînement, les représentations internes du modèle peuvent être utilisées pour des tâches en aval comme la prédiction de structure ou la conception de protéines.
En pratique
Il est utilisé dans la découverte de médicaments, l'ingénierie enzymatique et la biologie synthétique pour prédire les structures protéiques et concevoir de nouvelles protéines aux fonctions spécifiques, telles que des enzymes pour des procédés industriels ou des anticorps thérapeutiques.
Anecdote
Il a été démontré que les modèles de langage protéique apprennent des informations évolutives sans être explicitement entraînés sur des données évolutives, simplement en observant les motifs présents dans les séquences protéiques existantes.
Quatre vieilles cartes dormaient dans des tiroirs différents. Sur chacune étaient marqués les gènes liés au vieillissement cellulaire, mais les cartes ne concordaient pas : noms différents, échelles différentes, légendes différentes. Le chercheur qui voulait un gène pour son expérience devait les recouper à la main, au risque de laisser passer une annotation importante.
Dans une maison des miroirs, on s'approche d'une glace déformante et l'on se voit tantôt nain, tantôt géant. Les modèles d'apprentissage automatique populaires font à peu près pareil quand on leur demande de deviner l'âge biologique à partir d'analyses sanguines ou d'images cérébrales : ils étirent l'âge sur les bords, le sous-estimant chez les personnes âgées et le surestimant chez les…
Sur les lieux d'un crime, on trouve une tache. L'expert prélève un écouvillon, et quelques heures plus tard, l'appareil fournit une liste de protéines qui composaient le liquide. Auparavant, un test rapide pouvait se tromper si plusieurs liquides étaient présents : le sang se mélangeait à la salive, et la bandelette donnait un faux résultat.
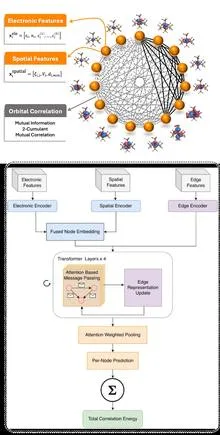
Un cartographe qui ne dessine ni montagnes ni rivières, mais les liens invisibles entre les électrons : c'est ainsi qu'on pourrait décrire ce nouveau réseau de neurones. Au lieu des coordonnées atomiques, il prend les orbitales moléculaires et trace un graphe dont les nœuds sont les orbitales et les arêtes, les mesures de leur intrication quantique.
Un radiologue regarde un scanner abdominal et voit non seulement des organes, mais aussi leur disposition mutuelle : quel rein est plus gros, où se trouve la tumeur par rapport au vaisseau. C'est comme lire une carte : il ne suffit pas de savoir où se trouve habituellement une ville, il faut aussi savoir mesurer la distance entre deux points sur le terrain.
Dans la glace antarctique, une particule fantôme ne laisse qu'un faible éclat de lumière bleue. Le détecteur IceCube capture ces éclats, et à partir d'eux, il faut déterminer d'où vient la particule. Le modèle PolarBERT a appris à le faire, mais ce qu'il voit réellement à l'intérieur restait un mystère.
Une protéine dans une cellule ne reste pas immobile comme un mannequin en vitrine. Ses atomes tremblent, s'étirent et se plient constamment, un peu comme une corde de guitare tendue qui continue de vibrer après qu'on l'a pincée. Pour comprendre comment une protéine fonctionne, il faut savoir à quel point chaque partie est fermement liée à ses voisines.
Un ingénieur en protéines ressemble à un cuisinier qui essaie de préparer un plat à la fois savoureux, sain et économique. En modifiant un ingrédient, il risque d'en gâcher un autre. Autrefois, les assistants informatiques ne pouvaient évaluer les propriétés des protéines qu'individuellement, sans voir comment elles sont liées entre elles.
L'interprète se laisse distraire par le moindre bruit dans la salle, et une réunion d'une heure s'étire sur deux. C'est le même problème pour les modèles de fondation moléculaires : ils apprennent le langage des molécules sur d'immenses corpus, mais chaque nouvelle conversation exige un réglage.
Une protéine ressemble à une minuscule machine qui s'allume et s'éteint sur commande. La commande arrive lorsqu'une autre molécule s'y fixe, comme une clé dans une serrure. Ensuite, la protéine change de forme et transmet le signal plus loin. Mais comment exactement le signal circule à l'intérieur de la protéine est longtemps resté un mystère.
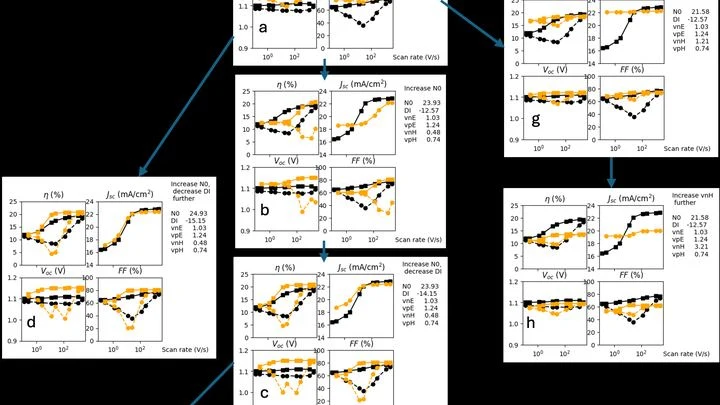
Une batterie solaire à pérovskite, c'est comme une jeune athlète : au début, elle donne d'excellents résultats, mais avec l'âge, elle se fatigue. En huit heures, ses performances chutent nettement, et aucune cause visible comme des fissures ou de la poussière n'apparaît. Des scientifiques ont pris une batterie et ont relevé ses mesures à la 0e, 90e, 280e et 480e minute de sa vie.
En tournant lentement le bouton de réglage d'un vieux poste de radio, vous entendez le son émerger du bruit non pas progressivement, mais par un saut brusque, au moment où l'antenne entre en résonance avec l'onde. C'est à peu près ainsi que se comportent les gènes dans une cellule vivante.
Dans chaque cellule, des rencontres et des séparations ont lieu en permanence. Certaines paires tiennent solidement, comme un scratch, d'autres se touchent à peine, comme du pollen porté par le vent.
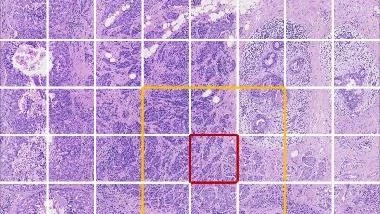
Un immense orchestre sans chef. Chaque musicien est un gène, et la mélodie est le travail complexe de la cellule. Autrefois, en regardant une photo de tissu, l'ordinateur essayait de deviner la partition de chaque instrument individuellement. Il ne savait pas que les violons jouent généralement avec les altos, et les trompettes avec les trombones.
Une protéine dans la cellule n'est pas une pièce rigide, mais plutôt un gant souple qui peut saisir différents objets. Jusqu'ici, les concepteurs de protéines travaillaient comme des sculpteurs, créant une clé pour une seule serrure : une cible, une forme.
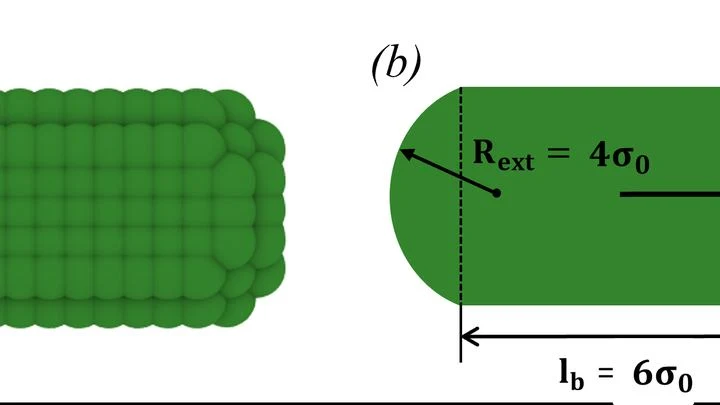
Un biofilm bactérien ressemble à une ville de mucus. Les maisons en sont les microbes eux-mêmes. Les rues et les ponts sont de longues molécules de polymères que les bactéries sécrètent à l'extérieur. Toute cette construction n'est pas figée : les ponts se rompent et se ressoudent sans cesse.
Quatre faibles traits sur l’image — tout ce que voit l’astronome. Ainsi, un sculpteur restaure la forme d’un verre invisible à partir de quatre ombres.
Une protéine glisse le long du brin d'ADN comme une clé sur un trousseau, cherchant sa serrure. Un mauvais tournant, et le gène reste éteint. Pour savoir où la protéine s'agrippera solidement, il faut mesurer la force de cette prise, c'est-à-dire l'énergie de liaison.
En 2025, les grands modèles de langage comme GPT ne se contentent plus de discuter — ils aident les scientifiques à monter des expériences. Mais le même outil peut tomber entre les mains de personnes malveillantes. Une équipe de chercheurs a construit un terrain d'essai numérique pour le vérifier.
Une immense bibliothèque où chaque livre est une instruction précise pour assembler une molécule de protéine. Le réseau de neurones AlphaFold2 a lu des millions de ces livres et a appris à fournir instantanément un modèle tridimensionnel prêt à l'emploi.
Une IA classique regarde les images médicales comme des puzzles faits de pièces inconnues : elle considère que deux images non appariées sont complètement différentes. C'est comme essayer de distinguer des jumeaux sans connaître leur lien de parenté. Or, en médecine, les patients atteints d'une même maladie présentent des IRM presque identiques, et l'algorithme se trompe en confondant les « parents ».
L'intelligence artificielle qui prédit l'acoustique d'une salle fait penser à un étudiant qui triche à l'examen avec une antisèche. Si les points de validation sont les mêmes que ceux de l'entraînement, le modèle se contente de mémoriser l'« empreinte » sonore de chaque position, comme un étudiant qui reconnaît un sujet grâce à un coin de page plié.
Les modèles qui transforment le texte en audio reproduisent bien les sons isolés, mais se mélangent les pinceaux quand le scénario en comporte plusieurs. Par exemple, selon le scénario, on a d'abord une sonnerie, puis des pas, puis un claquement de porte. Le générateur peut intervertir les événements, et le spectateur entendra les pas avant la sonnerie.
Les juges automatiques de la parole sont des algorithmes qui évaluent la prononciation et les émotions. Cependant, ils fonctionnent souvent comme un critique culinaire qui rend son verdict après avoir lu le menu, sans avoir goûté le plat.
Vous êtes sous la douche : vous tournez le robinet, et l'eau est tantôt glacée, tantôt brûlante. Les tuyaux vivent leur vie – la pression varie de façon imprévisible. Le nouveau contrôleur apprend au fur et à mesure : il ne connaît pas le circuit d'eau, mais en quelques minutes il s'adapte et amène la température à un niveau confortable, sans franchir les seuils de sécurité.
L'approche standard actuelle de l'apprentissage de l'IA ressemble à un enfant enfermé dans une bibliothèque : il mémorise des millions de livres, mais ignore que le feu brûle et que la chute fait mal.
Le cerveau communique par de brefs clics électriques. Autrefois, pour apprendre cette langue, il fallait des milliers d'exemples traduits par l'expérimentateur. La méthode MOJO suit une autre voie : comme dans l'apprentissage par immersion, elle écoute d'abord le « flux de conscience » sans aucune indication et repère elle-même les motifs récurrents.
Dans une casserole de soupe, deux thermomètres suffisent pour connaître la température partout — à condition de savoir que la chaleur se propage en cercles depuis le fond. De même en science : à partir de mesures éparses, il faut reconstruire l'image complète du champ thermique.
Les cellules d'un même organisme sont comme des jumeaux boulangers dans une cuisine commune. Ils partagent le même livre de recettes (l'ADN), mais des erreurs aléatoires surviennent lorsqu'ils recopient la recette sur une antisèche et lorsqu'ils assemblent le plat.
Imaginez un conducteur sur une route verglacée : il ne connaît pas la réaction exacte de sa voiture aux mouvements du volant et doit apprendre en conduisant, en gardant intuitivement une marge de manœuvre pour une éventuelle erreur. C'est ainsi que fonctionne un algorithme de contrôle adaptatif.
Évaluer la qualité d'une image, c'est le travail d'un contrôleur méticuleux muni de tout un attirail. Le réseau de neurones IQA-T1 agit exactement ainsi : il ne se contente pas de dévisager l'image, il y applique tantôt un spectroscope, tantôt un luxmètre.
Le son se décrit naturellement par un nombre complexe, où le volume représente la force de l'onde et la phase sa position dans le temps. Les réseaux de neurones classiques séparent ces deux aspects en coordonnées indépendantes, un peu comme si l'on donnait une adresse par quartiers : « deux à l'est, un au nord ».
Lorsqu'une étoile géante s'effondre en supernova ou que deux étoiles à neutrons fusionnent dans une danse cosmique, des billions de neutrinos emportent l'énergie du cataclysme.
En général, les algorithmes apprennent à agir dans des conditions prédéfinies, comme l'eau qui coule dans un lit déjà creusé. La nouvelle méthode renverse cette logique : elle permet au système d'apprendre à la fois à agir et à modifier son environnement.
Dans une pièce bruyante, l'humain distingue la voix recherchée grâce à ses deux oreilles, qui perçoivent une différence dans l'arrivée du son. Un ordinateur équipé de plusieurs microphones agit de la même manière : il reçoit des indices spatiaux — d'où vient chaque voix.
La préparation d'un plat complexe exige une recette claire : d'abord couper, puis faire revenir, ajouter les épices au bon moment. Les transformations chimiques suivent aussi des recettes pas à pas — des mécanismes où les atomes de carbone et d'hydrogène se réarrangent strictement dans l'ordre.
Les systèmes électriques équipés de panneaux solaires et d'éoliennes ressemblent à une partie d'échecs : la couverture nuageuse et les variations de charge sont des coups de l'adversaire impossibles à prévoir. Pour maintenir l'équilibre, les opérateurs devaient auparavant évaluer des dizaines de scénarios (incertitude) — ce qui demandait trop de temps et de calculs.
Quand vous tapez « salade » et que le clavier propose « césar », en coulisses, des millions de téléphones apprennent ensemble à prédire les mots. Ils n'échangent pas vos messages, mais seulement les améliorations de l'algorithme commun — comme un entraîneur qui envoie aux athlètes uniquement les changements au programme : « ajoutez 5 pompes à ceux d'hier ».
Un réseau neuronal qui génère des sons à partir de texte, c'est un peu comme une cuisine où chaque « plat » est préparé par des dizaines de cuisiniers. Beaucoup ne font que gêner : ils envoient des signaux erronés et gaspillent des ressources.
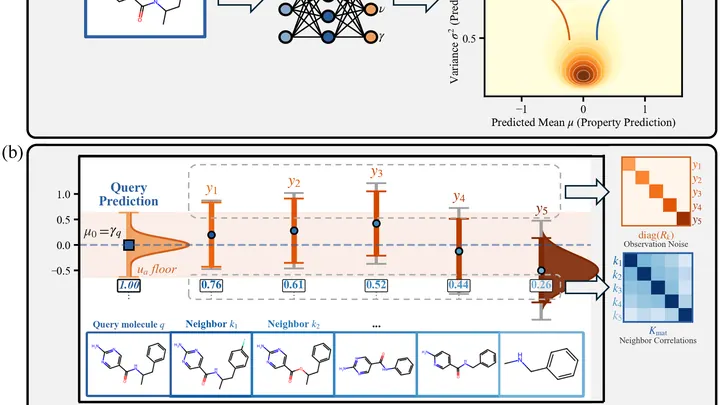
Prédire les propriétés d'une nouvelle molécule, c'est un peu comme deviner le goût d'un plat inconnu. Le programme agit comme un chef expérimenté : il « goûte » des molécules similaires dont les propriétés sont déjà connues et, en se basant sur leur « saveur », affine son estimation.