Нейроны заговорили простым языком экспресс
Художник пишет картину, поглядывая на зрителя в зале. Если зритель улыбается — художник добавляет на холст больше красного и округлых линий, если хмурится — убирает синий и ломает углы. Примерно так же нейробиологи «допрашивают» нейроны зрительной коры, только вместо красок — сотни тысяч фотографий, а вместо улыбки — электрический импульс.
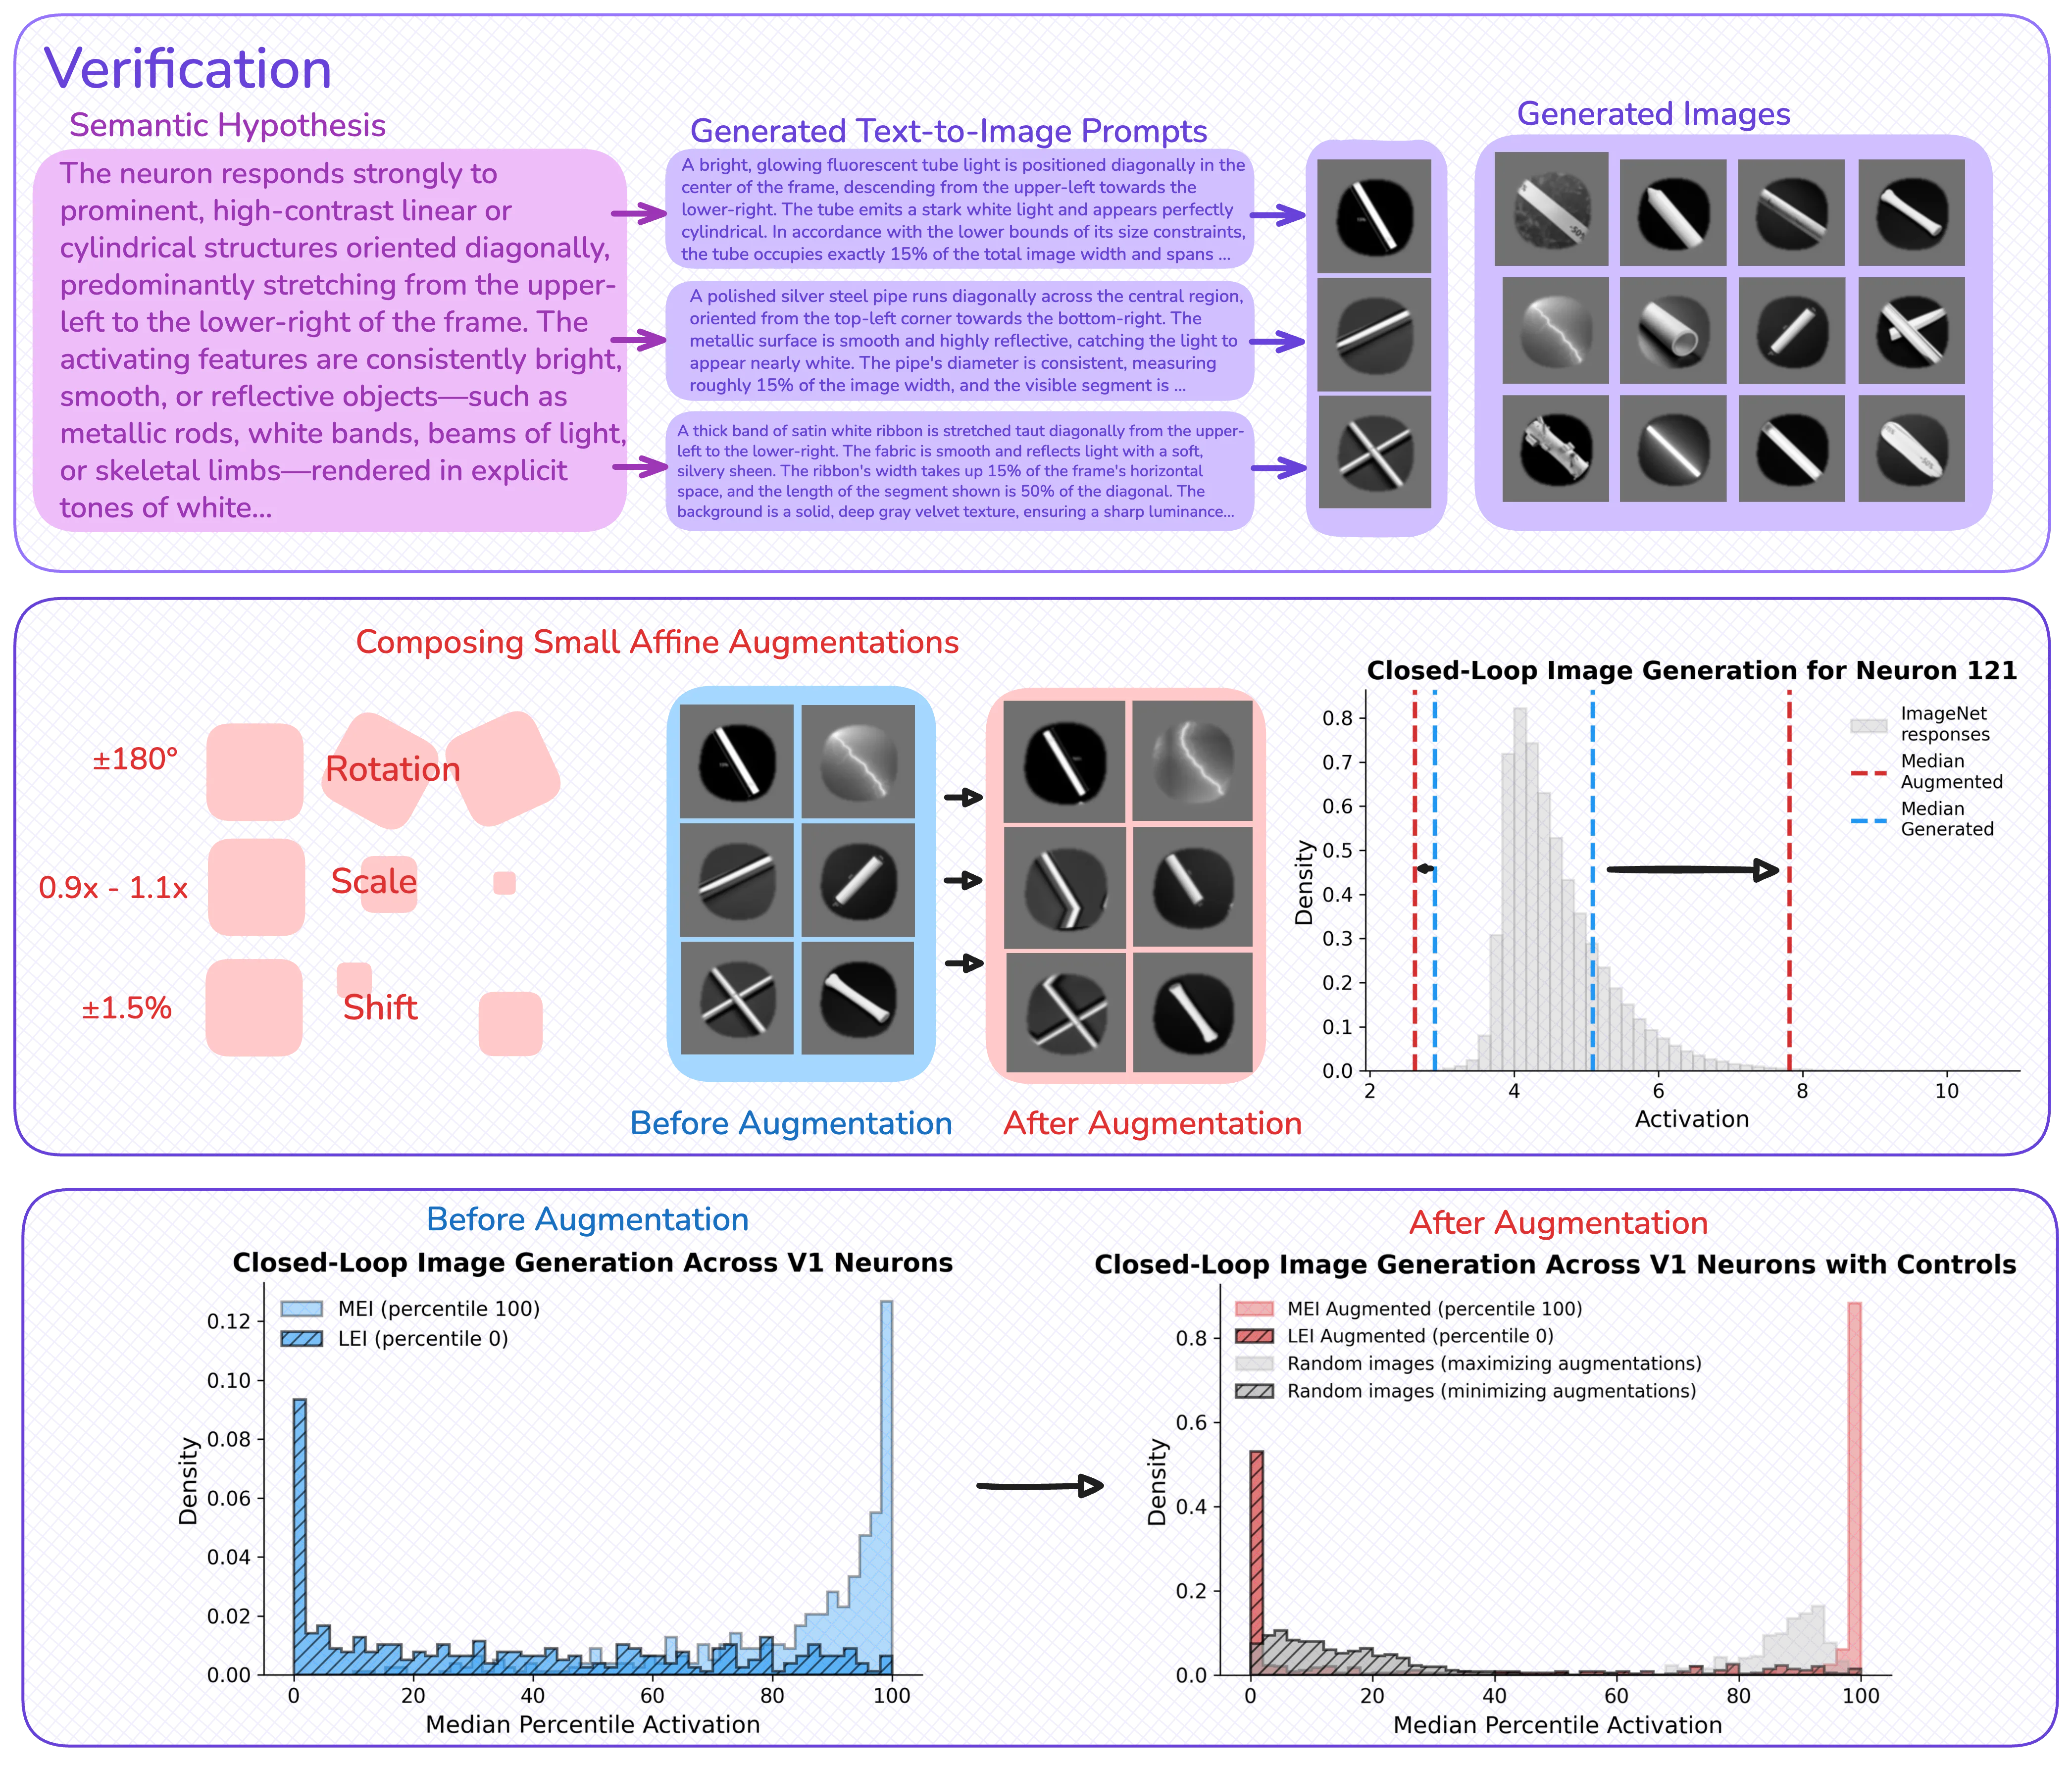
Для самой первой зрительной зоны (V1) у учёных долго была удобная модель: нейроны там реагируют на простые признаки — наклон линии, частоту полосок. Но уже в соседней зоне V4, где собираются более сложные образы, такого чёткого языка не было. Авторы новой работы решили, что универсальным языком может стать самый обычный, человеческий. Они взяли цифровые копии участков мозга макаки (V1 и V4), «показали» им множество изображений и для каждого нейрона отобрали те, что вызвали самый сильный и самый слабый отклик. Затем эти картинки скормили зрительно-языковой модели, которая выдала короткую подпись — гипотезу о том, что любит или не любит данный нейрон.
Чтобы проверить гипотезы, учёные по тем же словесным описаниям синтезировали новые, невиданные ранее изображения и снова «показали» их цифровым нейронам. Результат поразил: в зоне V4 картинки, созданные по «любимому» описанию, заставляли 96,1% нейронов выдавать мощный ответ (выше 95-го перцентиля от естественных стимулов), а «нелюбимые» изображения, наоборот, гасили 97,6% нейронов ниже 5-го перцентиля. Случайные картинки давали лишь около 10% таких попаданий. Для V1 активация работала так же точно, а вот подавление описать словами оказалось сложнее — видимо, «нелюбимое» для простых клеток менее определённо.
Этот подход напоминает игру в «испорченный телефон» между мозгом, картинкой и текстом, но с научной строгостью. Он позволяет не просто подбирать стимулы наугад, а целенаправленно «расспрашивать» каждый нейрон на понятном нам языке. В перспективе такой замкнутый цикл — от изображений к словам и обратно к синтезированным образам — может стать основой для автоматического научного открытия, где алгоритм сам формулирует и проверяет гипотезы о работе мозга. Так художник, начавший с угадывания настроения зрителя, получает в руки словарь его предпочтений — и пишет картину, которая зажигает нейроны с первой секунды.
Оригинальная аннотация
как её написали авторы, на английском arXiv:2605.12485
Understanding what individual neurons encode is a core question in neuroscience. In primary visual cortex (V1), mathematical models (e.g., Gabor functions) capture neural selectivity, but no comparable framework exists for higher areas. We show that natural language can fill this role: across macaque V1 and V4, the selectivity of most neurons is captured by concise, verifiable semantic descriptions. Using digital twins of V1 and V4, we develop a closed-loop framework that translates each neuron's high- and low-activating images into dense captions, generates a semantic hypothesis and synthesized images, and verifies the hypothesis in silico. Descriptions range from oriented edges and spatial frequency in V1 to conjunctions of form, color, and texture in V4. In V4, images generated from activating and suppressing hypotheses drove 96.1% of neurons above the 95th and 97.6% below the 5th percentile of natural-image responses, respectively (vs. ~10% for random images); V1 activation results matched V4, while V1 suppression was less describable in language. Representational similarity analysis reveals partial alignment between neural activity, vision embeddings, and language embeddings, with vision most aligned to neural activity; alignment lost in the text bottleneck is recovered when hypotheses are rendered back into images, showing that linguistic compression is lossy yet semantically faithful. Together, these results show that combining generative models with neural digital twins enables interpretable, testable descriptions of neural function at scale, toward agentic scientific discovery.
В зоне V4 у макак нашли нейроны, которые реагируют на сочетание цвета и текстуры — например, красный объект на деревянной поверхности. Это удивительно похоже на то, как художники описывают свои работы.
Идея «читать мысли» нейронов через языковые модели перекликается с рассказом Теда Чана «История твоей жизни», где расшифровка инопланетного языка меняет восприятие реальности.