Распознавание речи — это технология, которая позволяет машинам преобразовывать устную речь в текст или команды. Она включает анализ звуковых сигналов, извлечение акустических признаков и их сопоставление с лингвистическими единицами, такими как фонемы и слова. Современные системы используют глубокие нейронные сети, обученные на огромных объёмах речевых данных, чтобы достичь точности, близкой к человеческой, даже в шумной обстановке или при разнообразных акцентах.
История
Ранние попытки в 1950-х годах использовали простое сопоставление с образцом для распознавания цифр. В 1980-х область продвинулась благодаря скрытым марковским моделям, но прорыв произошёл в 2010-х, когда глубокое обучение заменило традиционные акустические модели, что резко повысило точность.
Как это работает
Процесс начинается с оцифровки звуковой волны и разделения её на короткие кадры (например, по 25 мс). Для каждого кадра извлекаются признаки, такие как мел-частотные кепстральные коэффициенты (MFCC), которые отражают спектральную форму звука. Эти векторы признаков подаются в нейронную сеть — часто рекуррентную или архитектуру на основе трансформера, — которая выдаёт вероятности для возможных фонем или символов. Затем языковая модель объединяет эти вероятности с лингвистическими ограничениями, чтобы получить наиболее вероятную текстовую последовательность. Современные сквозные модели (например, Whisper, DeepSpeech) обучаются отображать аудио в текст напрямую, минуя явное выравнивание по фонемам.
Где применяется
Распознавание речи используется в виртуальных помощниках (Siri, Alexa), автоматических сервисах транскрипции, устройствах с голосовым управлением и в системах субтитров в реальном времени для людей с нарушениями слуха.
Любопытный факт
Современные системы распознавания речи настолько чувствительны, что их можно обмануть неслышимыми ультразвуковыми командами, скрытыми в аудиозаписях, — уязвимость, обнаруженная в 2017 году.
В 1980-х годах соревнование DARPA по распознаванию речи положило конец спору между статистическими методами и рукописными правилами, задав единый стандарт для всей области. Для речевых нейроинтерфейсов, переводящих мозговую активность в слова, такого общего эталона до сих пор не было: каждая система использует свой словарь, способ записи и тип речи.
Мозг можно представить как оркестр, где дирижёр — кора больших полушарий, а таламус — первая скрипка. Таламус — это центральная ретрансляционная станция: он получает сенсорные сигналы, в том числе зрительные от глаз, и передаёт их в соответствующие области коры, например в зрительную кору.
Поиск нового материала напоминает кулинарные эксперименты без рецепта: пробуешь, пробуешь — и часто выбрасываешь. Раньше учёные вручную просматривали научные статьи и по одному проверяли составы. Теперь появился «робот-повар», который сам читает литературу, смешивает компоненты и анализирует результат.
Магнитоэнцефалограф — прибор, похожий на шлем с сотнями датчиков, — улавливает слабые магнитные поля, которые создают работающие нейроны. Если человек слушает речь, в этих сигналах прячутся отпечатки услышанных слов. Но достать их оттуда непросто: сигнал от тысяч источников сливается в запутанный клубок.
Каждое утро десятки телескопов наводятся на Солнце. Их камеры ловят узкую полоску красного света — линию Hα, открытую Иоганном Бальмером. На снимках проступают тёмные, прихотливо изогнутые нити. Они похожи на стежки гигантского гобелена, прошивающего раскалённую корону. Это солнечные волокна.
Человеческий разум похож на конструктор, который сам себя достраивает. Новые идеи не умирают вместе с человеком — они передаются, смешиваются и отбираются. Этот процесс называют культурной эволюцией: полезные изобретения закрепляются, а бесполезные забываются. Так работает храповик — механизм, который крутится только вперёд.
Художник делает быстрый набросок углём — и лицо на портрете уже узнаваемо. Астрофизики решают схожую задачу: спектр звезды — это её индивидуальный портрет, раскрывающий температуру, состав, силу тяжести. До недавнего времени для получения такого портрета требовалась кропотливая «живопись маслом» — код радиативного переноса в условиях отклонения от локального теплового равновесия (non-LTE).
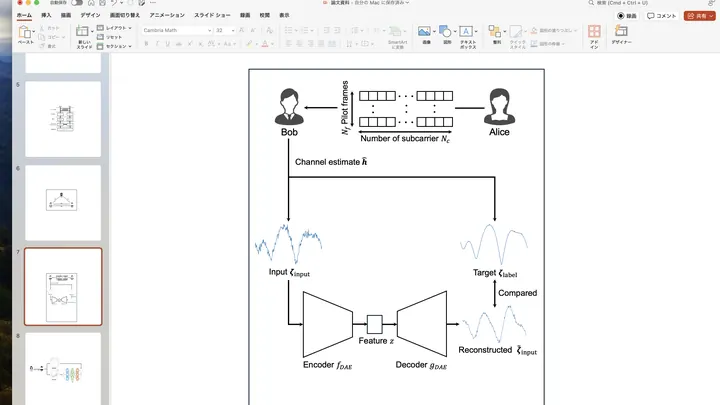
Когда два мобильных устройства пытаются сформировать общий секретный ключ, извлекая его из случайных флуктуаций радиоволн, неизбежные помехи искажают результаты измерений. Представьте двух человек, которые пытаются разглядеть один и тот же пейзаж сквозь запотевшее стекло: каждый видит лишь размытый силуэт, и совместить их наблюдения в единую картину крайне сложно.
Пилоту в воздушном бою необходимо мгновенно идентифицировать объект и его намерения. Традиционные системы ожидают полного набора радарных данных — это сродни вратарю, который реагирует лишь после удара по мячу. Новый алгоритм действует как опытный вратарь: анализируя начальные движения нападающего, он предсказывает манёвр цели задолго до завершения траектории.
Радиосигналы в замкнутом пространстве ведут себя подобно акустическим волнам в концертном зале: многократно отражаясь от стен, мебели и других поверхностей, они формируют уникальную интерференционную картину — своего рода безмолвную «мелодию» каждого места. Смартфон, оснащённый приёмником, подобно чуткому уху, регистрирует эту картину через анализ помех и искажений сигнала.
Человек без усилий выхватывает нужный голос из гомона вечеринки — наш мозг справляется с этой задачей, словно опытный рыбак, безошибочно узнающий плеск знакомой рыбы в бурном потоке. Для компьютера то же самое — пока задача на пределе возможностей. Прежние программы тренировались на стерильных записях, где нет ни эха, ни звона приборов.
Искусственный интеллект, предсказывающий акустику помещения, напоминает студента на экзамене со шпаргалкой. Если проверочные точки совпадают с учебными, модель просто запоминает звуковой «отпечаток» каждой позиции — как студент, узнающий билет по загибу уголка.
Модели, превращающие текст в аудио, хорошо воссоздают одиночные звуки, но путаются, когда в сценарии их несколько. Например, по сценарию сначала звонок, потом шаги, потом хлопок двери. Генератор может переставить события, и зритель услышит шаги до звонка.
Исследователи нашли неожиданное решение: вместо программирования сложных правил они взяли нейросеть, которая «понимает» аудио, и сделали её строгим контролёром.
Радиосигнал со слоистой модуляцией — представьте: несколько независимых информационных потоков, наложенных друг на друга, — напоминает культурный слой древнего города. Каждый уровень несёт свою историю, но со временем, под воздействием помех и искажений, они спутываются в хаотичную мешанину. Обычные алгоритмы демодуляции теряются в этой смеси, не в силах разделить слои.
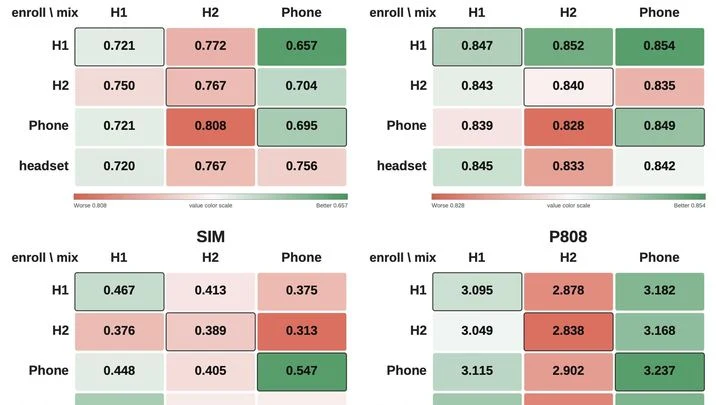
Автоматические судьи речи — это алгоритмы, обученные оценивать произношение и эмоциональную окраску голоса. Однако, как показали исследования, они часто ведут себя подобно кулинарному критику, который выносит вердикт, прочитав меню, но не попробовав само блюдо.
Освоение иностранного языка сродни настройке музыкального инструмента. Новая технология действует как интеллектуальный тюнер: она принимает вашу аудиозапись и эталонную речь носителя, затем динамически растягивает или сжимает их во времени — подобно тому, как подтягивают струну для точного совпадения тонов, — чтобы идеально совместить сигналы, и оценивает три ключевых параметра: чистоту звуков (артикуляцию)…
Мозг общается короткими электрическими разрядами — потенциалами действия. Прежде расшифровка этого языка требовала тысяч размеченных примеров: экспериментатор сопоставлял сигнал с конкретным движением или словом. Метод MOJO предлагает иной подход — подобно изучению языка через погружение, он сначала вслушивается в «поток сознания» без всяких подсказок и самостоятельно выявляет повторяющиеся паттерны.
Голосовые помощники нередко напоминают повара, который монотонно зачитывает рецепт по бумажке, не вкладывая ни капли аппетита. Новый архив русских диалогов «Диалоги» меняет правила игры. Три актёра в студии, подобно шеф-поварам, замешали 20 часов живых разговоров, приправив их двенадцатью эмоциональными «специями».
Звуковой сигнал удобно представлять комплексным числом: его модуль (амплитуда) отражает громкость, а аргумент (фаза) — положение волны во времени, её мгновенный сдвиг. Традиционные нейросети расщепляют это единое описание на две независимые координаты — грубо говоря, задают адрес в декартовой сетке: «два шага на восток, один на север».
Традиционные слуховые аппараты напоминают повара, который готовит по рецепту вслепую. Они анализируют звуковой беспорядок с микрофона и на его основе усиливают речь. В шумном кафе такой подход часто ошибается. Новая система ведёт себя как опытный кулинар: сначала обрабатывает сигнал, а затем «пробует» результат.
В шумной комнате человек выделяет нужный голос благодаря бинауральному слуху: два уха улавливают микроскопическую разницу во времени прихода звуковых волн и их интенсивности. Компьютер с массивом микрофонов действует аналогично — он извлекает пространственные подсказки, вычисляя направление на каждый источник звука.
Человеческий слух устроен так, что мозг выделяет в первую очередь знакомые паттерны — голос собеседника, шум дождя, сигнал автомобиля. Однако новая система работает по иному принципу: она фиксирует любой звуковой всплеск, даже тот, что никогда не встречался ранее.
Представьте кухню, где каждое «блюдо» — синтезированный по тексту звук — готовят десятки поваров. Многие из них лишь мешают: подают ложные сигналы и бесцельно тратят ресурсы. Именно так устроена полная версия нейросети-генератора звуков: множество её связей не участвуют в деле, но потребляют вычислительную мощность.
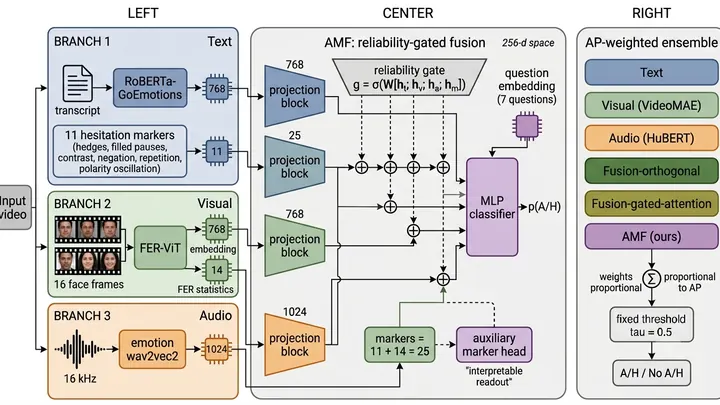
Новая система анализирует короткое интервью, чтобы распознать сомнения человека, объединяя текст, голос и выражение лица. Но главным ключом к неуверенности оказалась тёмная материя речи — паузы и слова-паразиты, которые стандартные речевые системы стирают, словно чёрная дыра, поглощающая всё без следа.
Поплавок в бачке унитаза — идеальный контроллер: чувствуя уровень воды, он мгновенно приводит систему в равновесие без оглядки на прошлое. Инженеры применили этот принцип к нейросетям. Они переписали стандартную архитектуру так, что вместо каскада вычислений она решает одно уравнение равновесия.
Очистка речи от шумов напоминает настройку старого телевизора: перекрутишь ручку контрастности — и лица становятся неестественными. Исследователи применили метод, позволяющий раздельно регулировать амплитуду (громкость) и фазовый сдвиг (сдвиг по времени) для каждой частоты звука — это спектроскопия, разложение сигнала на частотные…
Крупная нейросеть, такая как Whisper, владеющая сотнями языков, напоминает стандартную модель физики элементарных частиц — стройную систему, где всё находится в тонком равновесии.
Стандартный подход к оцифровке речи, лежащий в основе современных телекоммуникаций, — это прямая дискретизация: тысячи раз в секунду фиксируется мгновенная громкость сигнала. Представьте, что вы пробуете бульон чайной ложкой — каждый глоток даёт лишь слабый намёк на вкус, а чтобы уловить букет, приходится черпать снова и снова.
В зале суда — строка, поданная на вход. Двенадцать присяжных (вычислительных путей) изучают её символ за символом. Каждый может вынести «виновен» (принять) или «невиновен». Для обычного недетерминированного автомата (НКА) достаточно одного голоса «за». Но в суде с симметрической разностью (XNFA) вердикт выносится по нечётности: если число голосов «виновен» нечётно — слово принято.
Сто двадцать жителей Монтелаго — не люди, а цифровые персонажи. У каждого, помимо имени и биографии, три скрытые координаты: доверие к муниципальным властям, оценка достоверности источника, воспринимаемая адекватность информации. Эти числа известны создателям, но не самой системе.
Статистические модели — это попытка натянуть идеальную математическую паутину на неровный ландшафт данных. Когда модель сопротивляется, она издаёт напряжение, но мы привыкли его игнорировать. Исследователи часами вглядываются в графики остатков, пытаясь угадать, где модель «трещит по швам». Сквилер переводит это сопротивление в звук.
Вы рассказываете другу историю, а его мозг словно настраивается на вашу волну — одни и те же участки активируются в такт вашим словам. Учёные записали такую «нейронную синхронизацию» с помощью магнитоэнцефалографии (прибора, улавливающего магнитные поля мозга) и решили проверить, может ли компьютерная языковая модель повторить этот танец смыслов.
Камера смартфона снимает всё подряд, а глаз сразу выделяет главное. Сетчатка не просто передаёт картинку в мозг — она прямо на месте подчёркивает контуры, гасит лишний шум и подстраивается под яркость. Инженеры давно пытаются повторить этот трюк в «умном» железе, чтобы камеры тратили меньше энергии и быстрее принимали решения.
В пробирке плавают молекулы. Их количество — скажем, концентрация какого-то белка — становится входным сигналом. А на выходе нужен не просто мутный раствор, а чёткий ответ вроде «да» или «нет».
Авторы работы строят химическую цепочку, которая делает именно это.
Спутник MethaneSAT высматривает утечки метана — газа, который невидим для человеческого глаза, но обладает мощным парниковым эффектом. Его главный инструмент — спектрометр, прибор, регистрирующий тончайшие изменения в спектре света, прошедшего сквозь атмосферу.
Рука выводит в воздухе слово «мама» — знакомые дуги и палочки. Мозг при этом не прокручивает фотографию каждой буквы. Он запускает цепочку простых движений. Нейроинженеры проверили эту идею: мысленный почерк — не галерея готовых картинок, а конструктор из одних и тех же двигательных «кирпичиков».
Спектр — это как фотография внутреннего устройства вещества, сделанная светом. Когда луч проходит сквозь образец или отражается от него, молекулы оставляют на этой фотографии характерные тёмные полосы — пики. Но если снимок засвечен или покрыт серой пеленой, разглядеть детали почти невозможно.
Художник пишет картину, поглядывая на зрителя в зале. Если зритель улыбается — художник добавляет на холст больше красного и округлых линий, если хмурится — убирает синий и ломает углы. Примерно так же нейробиологи «допрашивают» нейроны зрительной коры, только вместо красок — сотни тысяч фотографий, а вместо улыбки — электрический импульс.
Мелодия звучит — и мозг не просто слушает ноту за нотой. Он работает как дирижёр, который уже знает партитуру: каждая следующая нота ожидаема, потому что предыдущие ещё звучат в памяти. Но как нейроны удерживают это эхо? В новой статье предложена модель импульсной нейросети PCL+ — сети, где сигналы передаются короткими разрядами, как в настоящем мозге.
Каждый раз, когда вы раздумываете над рискованным шагом — вложить ли деньги в акции или переждать, — в голове идёт внутренний диалог. Обычно учёные пытаются восстановить ход этого диалога по одному лишь итоговому выбору, как если бы детектив восстанавливал разговор двух людей, глядя на фотографию места встречи. Такой картины часто не хватает: одни и те же действия могут родиться из совершенно разных размышлений.