Символьная регрессия — это разновидность машинного обучения, которая ищет математическую формулу, а не просто подбирает параметры заранее выбранного уравнения, чтобы наилучшим образом описать набор данных. В отличие от нейронных сетей, которые часто действуют как «черные ящики», символьная регрессия выдает выражения, понятные человеку, например F = G·m₁·m₂/r². Это делает ее мощным инструментом для научных открытий, поскольку она позволяет выявлять скрытую структуру природных явлений непосредственно из данных.
История
Концепция была популяризирована в 1990-х годах Джоном Козой в рамках генетического программирования, хотя более ранние работы по символьной регрессии с использованием генетических алгоритмов существовали уже в 1980-х годах.
Как это работает
Метод использует эволюционные алгоритмы или другие методы поиска для комбинирования базовых математических операций (+, −, ×, ÷, sin, exp и т. д.) в кандидатные формулы. Каждая формула оценивается по тому, насколько хорошо она предсказывает данные, и лучшие кандидаты подвергаются «мутации» и «скрещиванию» для получения новых поколений. Процесс повторяется до тех пор, пока не появится простая и точная формула, часто с учетом штрафа за сложность, чтобы избежать переобучения.
Где применяется
Она используется в физике для повторного открытия законов из экспериментальных данных, в инженерии для идентификации систем, а в финансах — для моделирования динамики рынка.
Любопытный факт
В 2019 году алгоритм символьной регрессии независимо переоткрыл закон всемирного тяготения Ньютона и другие фундаментальные уравнения физики на основе сырых наблюдательных данных.
Переводчик в переполненном зале пытается разобрать речь одного человека, но слышит гул сотен голосов. Молекула, хранящая квантовую информацию в спине, оказывается в похожей ситуации: её спин окружён тепловым дрожанием атомов, и именно это дрожание постепенно стирает память. Задача — понять, какие именно колебания «перекрикивают» остальные.
Алмаз — не просто украшение. Внутри его кристаллической решётки прячутся дефекты, которые чувствуют магнитное поле лучше многих приборов. Один такой дефект — NV-центр — работает как крошечный компас, но его стрелка колеблется от тепла и шума. Чтобы компас показывал точное направление, нужна калибровка.
Переводчик отвлекается на каждый шорох в зале — и час совещания превращается в два. Так и молекулярные фундаментальные модели: они выучивают язык молекул на гигантских корпусах, но для каждого нового разговора требуют настройки. Monroe меняет правила: она не учит новый язык, а мгновенно находит общий смысл по нескольким примерам.
Одинокая рыба замечает тень над головой. Бежать? Если это просто лист, она зря потратит силы и выдаст себя хищнику. Если это цапля — промедление смертельно. Таков вечный компромисс одиночки: быстрая реакция означает много ложных тревог, осторожность — риск быть съеденным.
В стае всё иначе. Сосед, который спокойно продолжает щипать водоросли, — это живое доказательство того, что опасности нет.
Удержать в голове точное положение ручки, пока её медленно двигают, — для мозга рядовая задача. Для искусственных нейросетей она почти невыполнима. Обычные рекуррентные сети, такие как GRU (Gated Recurrent Unit) и LSTM (Long Short-Term Memory), склонны разбивать непрерывное движение на жёсткие ступеньки: ручка не ползёт плавно, а перескакивает из точки в точку.
Прогноз выхода химической реакции — это попытка предсказать урожай, зная лишь состав почвы. Долгое время химики опирались на длинные колонки чисел, так называемые квантовые дескрипторы, которые описывают энергию электронов, но умалчивают о форме молекулы.
Восстановить целостную картину по обрывкам — всё равно что расслышать мелодию оркестра в шумном зале. Такие задачи стоят в фотометрии — области, измеряющей поток излучения от небесных тел, где по слабому мерцанию восстанавливают яркость звезды. Традиционные методы требуют точных сведений о помехах, а они почти всегда неизвестны.
Обычные алгоритмы компьютерного зрения воспринимают медицинские изображения как набор несвязанных фрагментов — любые два несовпадающих снимка для них абсолютно различны. Это напоминает попытку отличить близнецов, не зная об их родстве. В медицине же пациенты с одним заболеванием часто выглядят на МРТ почти идентично, и алгоритм ошибается, путая «родственные» случаи.
Оценка качества снимка — это работа для дотошного контролёра с целым арсеналом инструментов. Нейросеть IQA-T1 действует именно так: она не просто разглядывает картинку, а методично применяет то спектроскоп, то люксметр. Цифровой шум, словно рябь на воде, маскирует дефекты, но анализ частот — спектроскопия изображения — позволяет выявить потерю резкости.
Приготовление сложного блюда требует чёткого рецепта: сначала нарезать, потом обжарить, добавить специи в нужный момент. Химические превращения тоже идут по пошаговым рецептам — механизмам, где атомы углерода и водорода перестраиваются строго по очереди.
Раньше нейросети часто выдумывали несуществующие шаги, как повар-фантазёр, заменяющий соль сахаром.
Нейроморфные чипы функционируют по принципам, отличным от классических компьютеров, построенных по архитектуре фон Неймана с раздельными блоками памяти и процессора.
Поплавок в бачке унитаза — идеальный контроллер: чувствуя уровень воды, он мгновенно приводит систему в равновесие без оглядки на прошлое. Инженеры применили этот принцип к нейросетям. Они переписали стандартную архитектуру так, что вместо каскада вычислений она решает одно уравнение равновесия.
Стандартный подход к оцифровке речи, лежащий в основе современных телекоммуникаций, — это прямая дискретизация: тысячи раз в секунду фиксируется мгновенная громкость сигнала. Представьте, что вы пробуете бульон чайной ложкой — каждый глоток даёт лишь слабый намёк на вкус, а чтобы уловить букет, приходится черпать снова и снова.
Вглядитесь в ночное небо — перед вами не россыпь огней, а многослойная рукопись. Под яркими чернилами звёзд и галактик проступает блёклый, почти стёртый текст. Это послание тёмной материи, начертанное гравитационным линзированием: невидимые массы искажают свет далёких галактик, оставляя едва заметные водяные знаки на космическом пергаменте.
Гамма-небо, запечатлённое телескопом Fermi, — это грандиозная симфония из тысяч источников. Здесь ритмичные пульсации пульсаров, мощные аккорды активных ядер галактик, но больше всего — неотождествлённых объектов, чья партия остаётся загадкой.
Свет от далёких галактик идёт к нам миллиарды лет, но на пути его ломает и выгибает невидимая паутина тёмной материи. Этот эффект, предсказанный Эйнштейном в рамках общей теории относительности, называют гравитационным линзированием.
Квантовые спиновые цепочки напоминают шеренгу людей, передающих друг другу секретное рукопожатие: каждый поворачивается к соседу, и от того, насколько крепко они сжали ладони, зависит, как пробежит волна по всей цепочке.
Чёрная дыра — не застывшая пустота, а живой магнитный двигатель. Её «сердце» — аккреционный диск — пульсирует: вдох — вещество закручивается в воронку, выдох — магнитное пересоединение разрывает силовые линии, и плазма выстреливает прочь от горизонта.
Врач ставит диагноз не по наитию. Он открывает медицинский справочник и показывает, на какую статью опирается. Примерно так работает новая система KG-TRACE.
Рентгеновские детекторы устроены подобно пчелиным сотам: в шестиугольных ячейках то здесь, то там регистрируются вспышки — следы попадания отдельных фотонов. Традиционные алгоритмы вынуждены растягивать эту естественную гексагональную структуру на прямоугольную сетку, что порождает артефакты — ложные призраки поляризации, искажающие реальную картину.
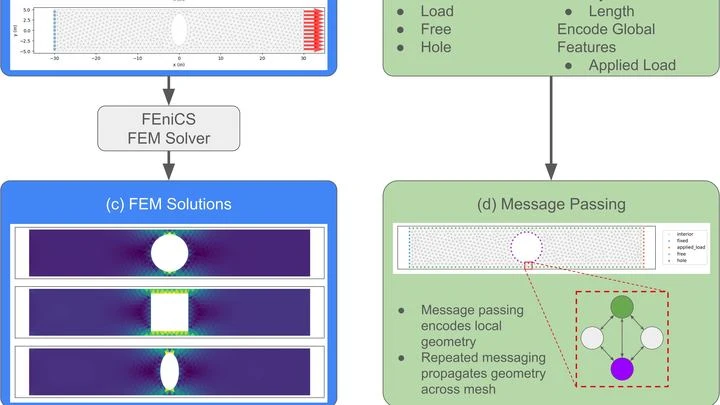
Проектирование машин сродни кулинарии: необходимо точно знать, где «тесто» порвётся. Классические численные методы, например, анализ методом конечных элементов, проверяют каждую точку детали часами — это как обмерять всю кастрюлю, чтобы ручка не отвалилась.
Художник пишет картину, поглядывая на зрителя в зале. Если зритель улыбается — художник добавляет на холст больше красного и округлых линий, если хмурится — убирает синий и ломает углы. Примерно так же нейробиологи «допрашивают» нейроны зрительной коры, только вместо красок — сотни тысяч фотографий, а вместо улыбки — электрический импульс.
Когда сталкиваются чёрные дыры — объекты с гравитацией настолько сильной, что даже свет не может их покинуть, — дрожит сама ткань пространства-времени, четырёхмерного континуума, объединяющего три пространственных измерения и время.
Завод, где сотни крошечных сборочных линий работают без остановки. Каждая линия — это молекулярный мотор, который превращает химическое топливо в движение. Чтобы мотор ехал быстрее или в нужную сторону, инженер меняет настройки — форму деталей, силу взаимодействий.
В зале с сотней инструментов звучит симфония, но дирижёр скрыт за ширмой. Учёный слышит только ноты, которые играют инструменты, и хочет понять, кто задаёт ритм. Научные данные похожи на такой оркестр: мы записываем показания приборов, но не видим скрытых механизмов, которые ими управляют. MOSAIC учится по этим записям находить дирижёров и объяснять, на какие инструменты они влияют.
Астрономы, подобно поварам, долгое время описывали Вселенную, опираясь на одни и те же громоздкие рецепты — сложные математические формулы, оценивающие распределение галактик по светимости и массе, а также структуру невидимых фундаментов из тёмной материи — таинственной субстанции, проявляющей себя лишь через гравитацию.
Если показать одну и ту же фотографию кота двум разным нейросетям, они часто приходят к похожему выводу: «кот». Но если спросить их подробнее, ответы могут разойтись. Одна модель обратит внимание на усы, другая — на окрас, третья — на позу. Получается, что даже внутри «зрительного» мира нейросетей нет полного единства.
Учёные придумали способ измерить это единство для каждой картинки отдельно.
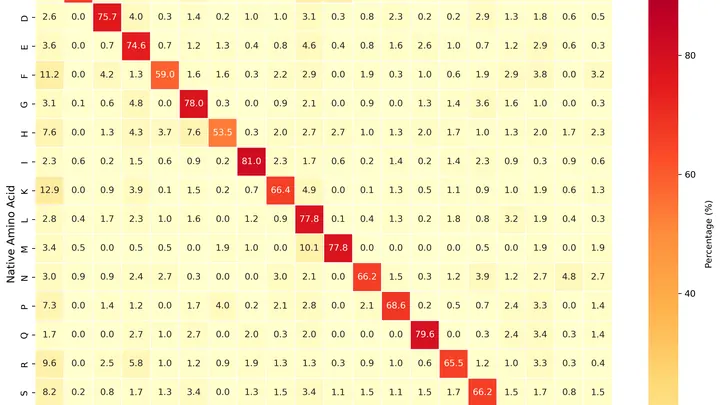
Белок похож на цепочку бусин-аминокислот, которая сворачивается в строго определённую форму — от этой формы зависит, как белок работает в клетке. Дизайнеры белков меняют бусины местами, чтобы получить нужную форму, но перебор вариантов огромен.
Стандартная космологическая модель опирается на Большой взрыв и тёмную энергию — гипотетическую форму энергии, заставляющую Вселенную расширяться с ускорением.
Обычный компьютер, когда ищет закон природы по данным, пытается угадать готовую формулу целиком. Это как если бы повар, не зная рецепта, разом вывалил все ингредиенты в кастрюлю и надеялся, что получится суп. Чаще всего выходит несъедобная каша: формула длинная, но бессмысленная, и на новых данных она ошибается.
Учёные предложили другой путь: пусть машина идёт по стопам великих физиков.
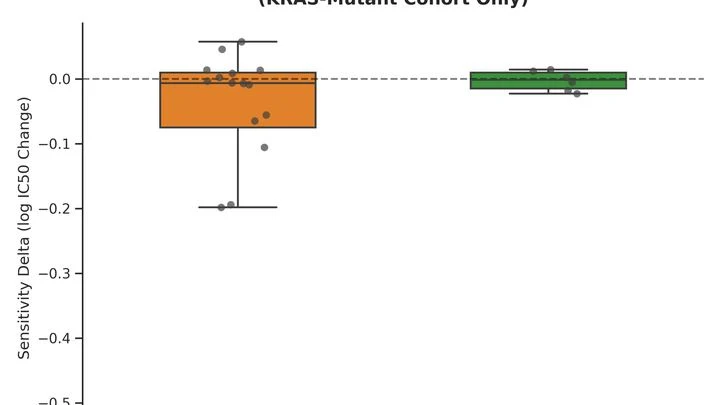
Раковая клетка похожа на упрямый замок, который меняет свои ключи, когда вы пытаетесь его открыть. Лекарство действует как отмычка, но клетка быстро находит способ её не пустить. В новом исследовании учёные построили компьютерную модель, которая повторяет поведение раковых клеток при разных поломках в их генах.
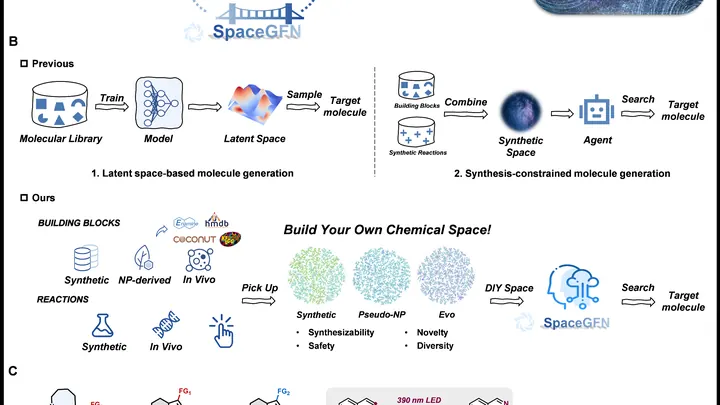
Раньше генеративные модели для поиска лекарств работали как художник, который рисует, не выбирая холст. Они учились на существующих молекулах и просто выдавали похожие, не задумываясь о том, как устроено само пространство возможных соединений. SpaceGFN меняет подход: теперь химическое пространство — это конструктор, где пользователь задаёт детали и правила сборки.
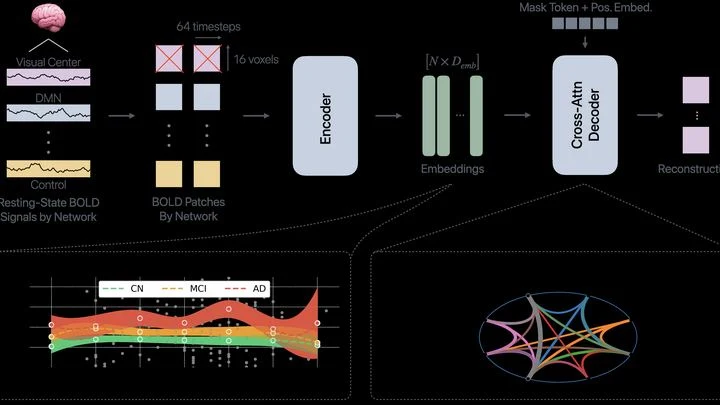
Мозг — это не один большой компьютер, а скорее оркестр, где разные группы музыкантов играют свои партии. Сети нейронов, отвечающие за память, внимание или эмоции, постоянно переговариваются. При болезни Альцгеймера этот оркестр начинает фальшивить: одни группы замолкают, другие играют невпопад. Но как это увидеть на снимке мозга?
Учёные придумали хитрый способ.
Когда две частицы сталкиваются и разлетаются, физики записывают результат как сложную математическую формулу. Таких формул много, и между ними есть невидимые связи — как между разными рецептами одного блюда: меняешь порядок действий, а вкус тот же. Раньше эти связи выводили вручную, тратя месяцы и годы.
Теперь за это взялась программа, которая ищет закономерности в числах.
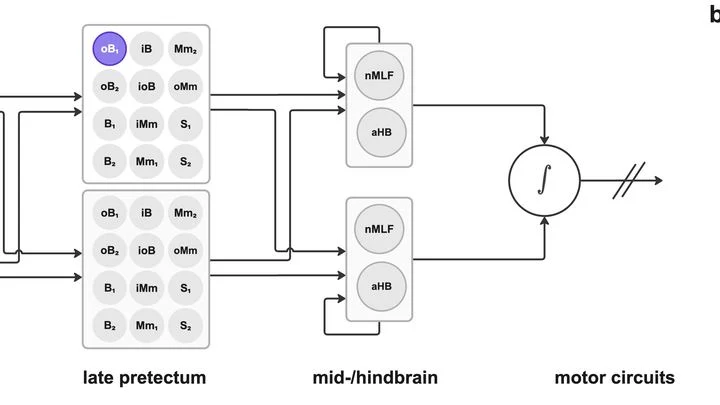
Личинка рыбки данио-рерио почти прозрачна, и её мозг можно разглядеть под микроскопом. Но даже у такого крошечного существа нейронные связи запутаны так, что разобраться в них вручную почти невозможно. Учёные сделали хитрый ход: создали точную компьютерную копию этой личинки, где каждая связь известна. Получился виртуальный полигон для проверки методов.
Химик, который ищет новое лекарство, похож на повара без рецепта: у него есть список желаемых свойств, но миллионы возможных ингредиентов. Каждая проба стоит дорого и занимает время, поэтому пробовать нужно с умом.
Новая программа SEISMO действует как повар, который пробует блюдо после каждого шага и сразу решает, что добавить дальше.
Каждое движение мысли оставляет след — слабый электрический всплеск на коже головы. Прибор с десятками проводов, похожий на шапочку для плавания, ловит эти следы и превращает их в волнистые линии. По ним можно догадаться, что человек чувствует, даже если он молчит. В новой работе три компьютерные программы соревновались, кто точнее прочитает такие линии и определит: настроение плохое, спокойное или хорошее.
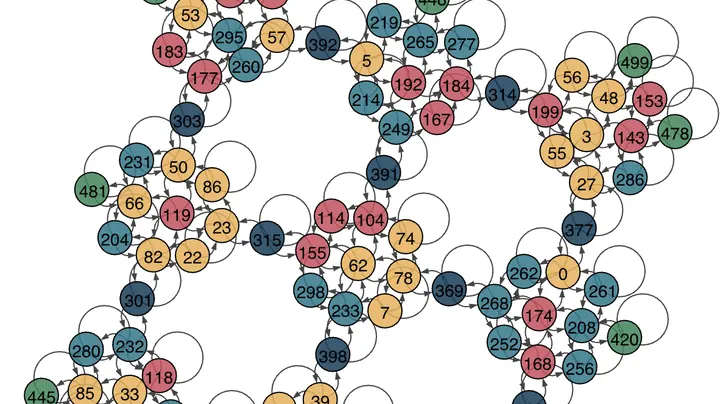
Переезжая в новую квартиру, человек не учится заново открывать двери и включать свет. Опыт из старого дома переносится сам собой: кухня — это место с плитой и мойкой, спальня — с кроватью. Мозг хранит не точную карту, а гибкую схему, которую накладывает на незнакомое пространство.
Учёные построили компьютерную модель такого переноса. В ней два этажа.
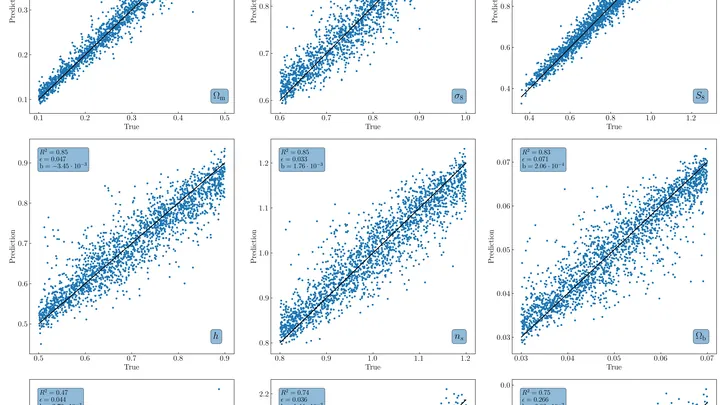
Тысячи вселенных родились в компьютере, чтобы однажды рассказать о нашей. Каждая — со своими скоплениями галактик, расставленными по законам гравитации, как горошины в банке, которую встряхнули с разной силой. По тому, как легли горошины, можно понять, что за рука трясла банку.