Как отличить опасную мутацию от безобидной экспресс
В огромной библиотеке, где каждая книга — это ген, нужно найти одну опечатку. Ошибка может быть безобидной, а может полностью изменить смысл фразы. Примерно так генетики ищут вредные мутации среди миллионов безвредных отличий.
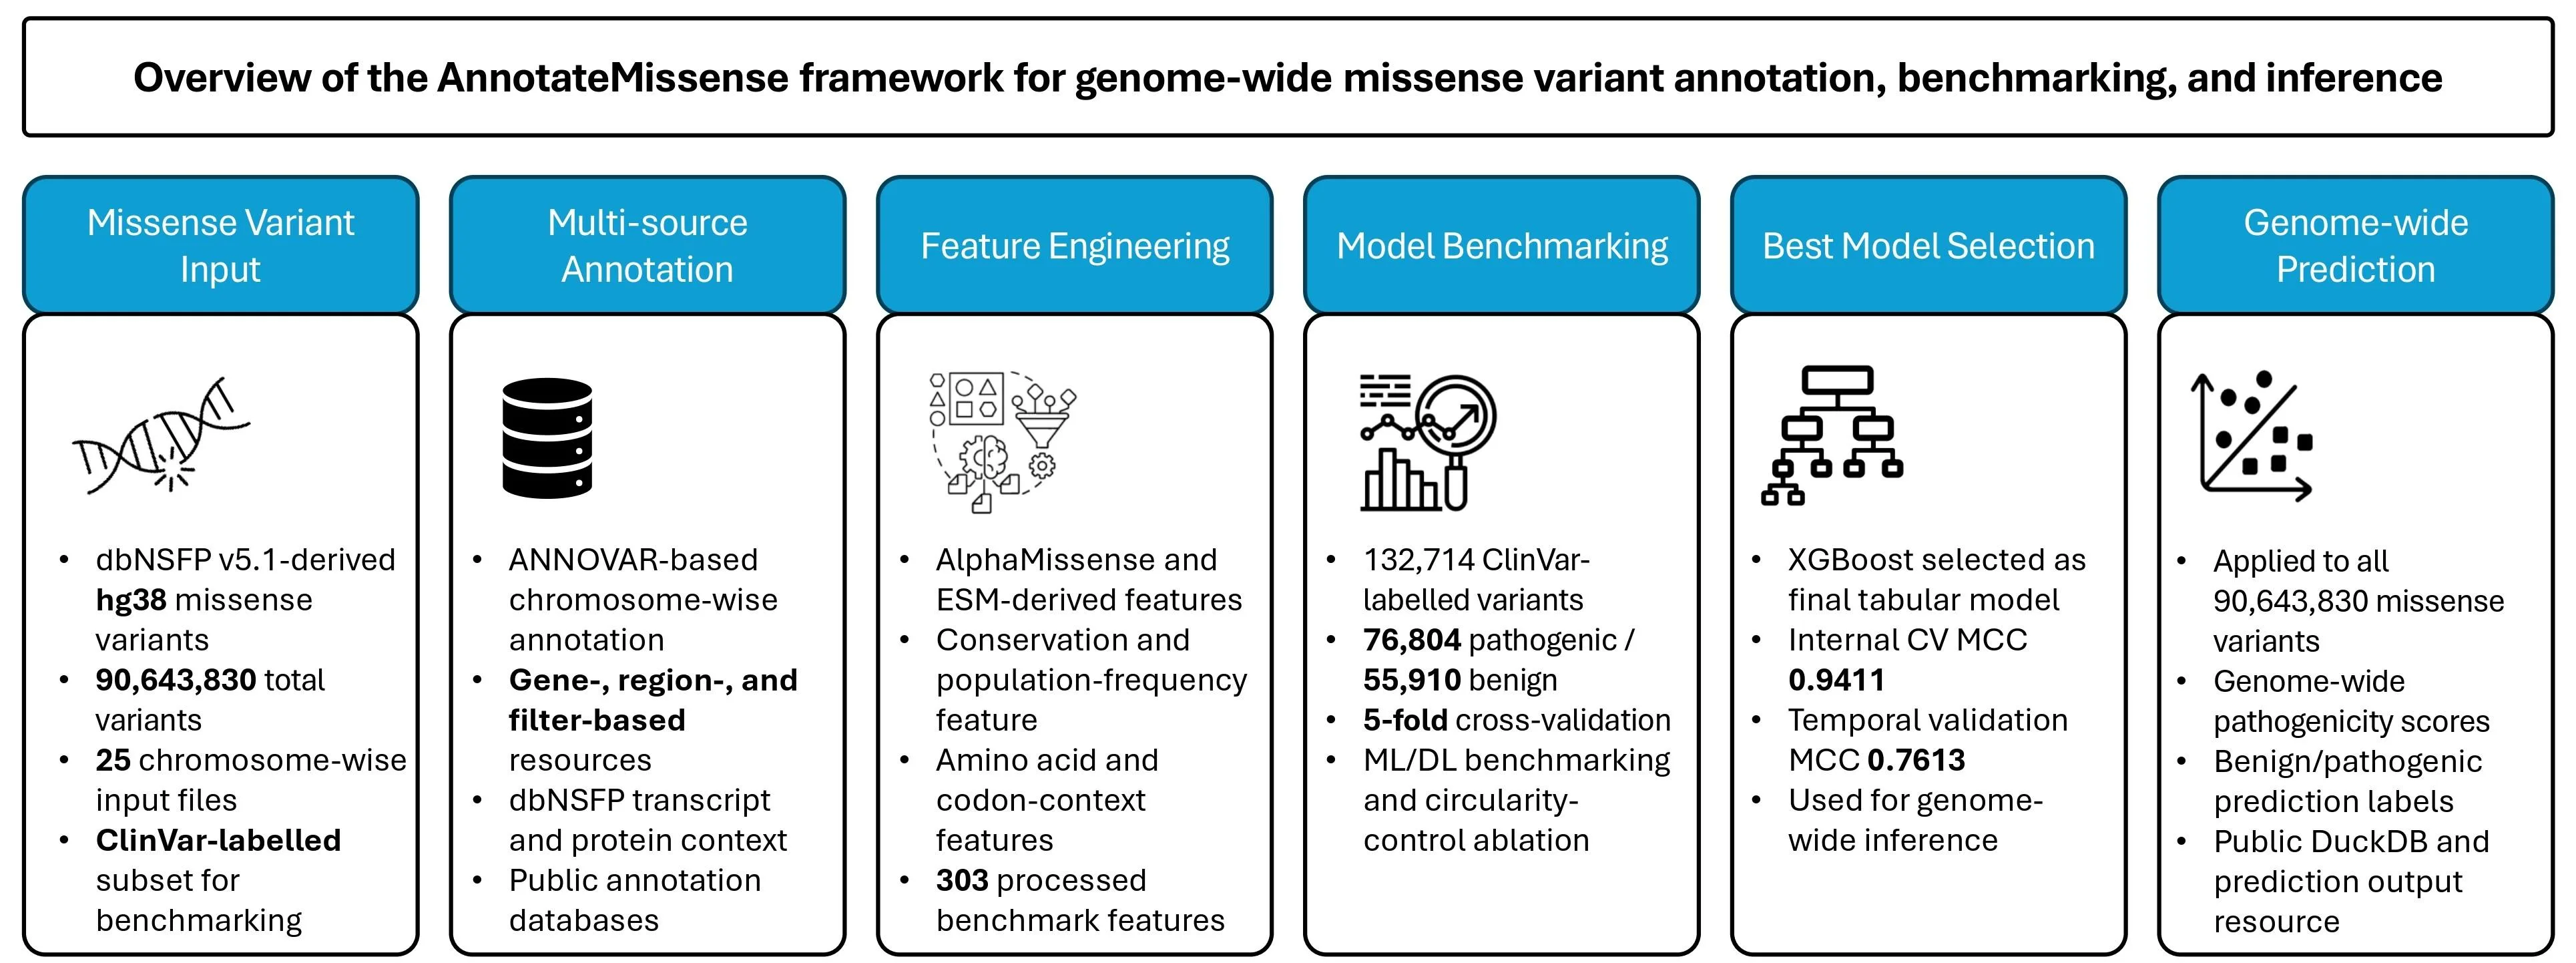
Программа, которую назвали AnnotateMissense, действует как дотошный корректор. Она не просто смотрит на саму букву-замену, но и собирает все возможные подсказки: насколько часто такая замена встречается у здоровых людей, как сильно меняется форма белка, что говорят другие программы-предсказатели и даже как выглядит «почерк» эволюции — сохранялся ли этот участок неизменным у разных видов. Всего таких подсказок набралось 303.
Самое интересное случилось, когда у программы стали отбирать подсказки. Без данных о частоте мутации в популяции и без подсказок от других предсказателей точность резко падала — как если бы корректор потерял словарь и справочник по грамматике. А вот удаление модных оценок от белковых языковых моделей почти не повлияло на результат. Финальную версию проверили на свежих данных, которые появились уже после обучения: точность осталась на высоте — 88%. После этого программа просканировала весь геном человека и выставила оценки опасности для 90 миллионов мутаций.
Оригинальная аннотация
как её написали авторы, на английском arXiv:2605.24520
Missense variant interpretation remains challenging because pathogenicity depends on heterogeneous evidence from population frequency, evolutionary conservation, transcript context, amino acid substitution severity, prior pathogenicity predictors and protein-language-model-derived features. We present AnnotateMissense, a scalable annotation, benchmarking and genome-wide prediction framework for missense variant interpretation. AnnotateMissense integrates hg38 missense variants derived from dbNSFP v5.1 with ANNOVAR annotations, dbNSFP transcript/protein descriptors, AlphaMissense scores, ESM-derived features, conservation metrics, population-frequency variables, established pathogenicity predictors and engineered amino acid/codon-context features. Using 132,714 ClinVar-labelled missense variants, we benchmarked machine-learning and deep-learning models under controlled feature configurations. The full 303-feature benchmark set achieved the strongest performance with XGBoost, reaching mean MCC = 0.9411 and ROC-AUC = 0.9950 across stratified five-fold cross-validation. Restricted naive and location-oriented feature sets achieved lower best MCC values of 0.4989 and 0.5113, respectively. Circularity-controlled ablations showed that removing prior-predictor, population-frequency and clinically overlapping evidence reduced performance, whereas excluding AlphaMissense and ESM-derived features alone had minimal effect. Temporal ClinVar validation on newly observed pathogenic/benign variants achieved MCC = 0.7613, accuracy = 0.8798 and F1-score = 0.8750. The final model was applied to 90,643,830 hg38 missense variants to generate AnnotateMissense pathogenicity scores and binary prediction labels. Code and outputs are available at https://github.com/MuhammadMuneeb007/CAGI7_Annotate_All_Missense and https://doi.org/10.5281/zenodo.19981867.
Слово «миссенс» в названии означает, что мутация меняет всего одну аминокислоту в белке — как замена одной буквы в слове. Но даже такая мелочь может превратить «дом» в «дым».
В фильме «Гаттака» общество делили на «годных» и «негодных» по генетическому прогнозу — подобные программы делают такой сценарий чуть ближе к реальности.