Cómo encontrar en el océano la «perilla» para pronosticar lluvias ✛
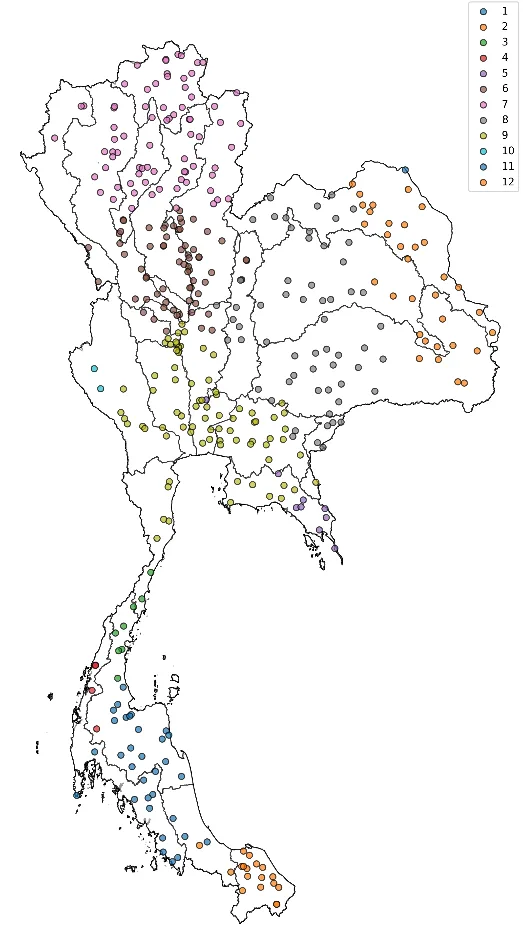
Imagina que estás ajustando una radio y giras lentamente la perilla para sintonizar la estación deseada. Un agente con aprendizaje por refuerzo hace lo mismo, solo que en lugar de una perilla tiene dos rectángulos en el océano que puede mover y estirar. Su objetivo es encontrar un par de zonas tal que la diferencia de temperatura del agua entre ellas prediga mejor las lluvias en Tailandia.
Inicialmente, las regiones se eligieron con datos antiguos y la relación con las lluvias era débil. El agente probó miles de combinaciones y la relación se fortaleció varias veces. Las zonas encontradas se desplazaron cientos de kilómetros respecto a las originales. Cuando se añadió esta nueva señal a una red neuronal con memoria, el error del pronóstico a un año vista se redujo en casi todos los grupos de estaciones meteorológicas. Solo en una región no hubo mejora.
Ahora los pronosticadores pueden usar este índice para planificar mejor el agua para la agricultura y los embalses. Antes no estaba claro a qué partes del océano prestar atención, pero ahora el agente ha encontrado la frecuencia adecuada y la señal es más clara.
El agente de aprendizaje por refuerzo exploró miles de combinaciones de rectángulos en el océano para encontrar un par de regiones cuya diferencia de temperatura predice mejor las lluvias. Las regiones óptimas resultaron desplazadas cientos de kilómetros respecto a las propuestas en estudios anteriores.