El aprendizaje por refuerzo (RL) es una rama del aprendizaje automático en la que un agente aprende por sí mismo el comportamiento óptimo mediante prueba y error, interactuando con el entorno. A diferencia del aprendizaje supervisado, aquí no hay respuestas correctas predefinidas: solo hay una señal de recompensa, que puede ser escasa y ruidosa. El agente debe equilibrar la exploración de nuevas estrategias (¿y si son mejores?) y la explotación de las ya conocidas. Este dilema exploración-explotación es el corazón del RL. Los algoritmos modernos, como las Deep Q-Networks y el Proximal Policy Optimization, utilizan redes neuronales profundas para procesar entradas visuales complejas y controlar decenas de acciones en paralelo.
Historia
Los fundamentos del RL se encuentran en los conceptos psicológicos del condicionamiento operante (Thorndike, Skinner). En el campo de la IA, la primera contribución importante fue la tesis de Minsky sobre redes neuronales y refuerzo (1954). En los años 80, Sutton y Barto sentaron las bases teóricas. El gran avance para el público general llegó en 2015, cuando DeepMind presentó un sistema que jugaba a 49 juegos de Atari a nivel humano. A continuación vinieron AlphaGo (2016), AlphaZero (2017) y OpenAI Five (2019), que demostraron su eficacia en entornos multiagente complejos.
Cómo funciona
La base son las ecuaciones de Bellman. Para Q-learning: Q*(s, a) = E[R(s,a) + γ max_a' Q*(s', a')]. El algoritmo actualiza la estimación: Q(s,a) ← Q(s,a) + α[r + γ max_a' Q(s',a') - Q(s,a)]. En el Q-learning profundo, la Q-red minimiza el error de predicción: L = E[(r + γ max_a' Q(s', a'; θ^-) - Q(s, a; θ))^2] mediante métodos de descenso de gradiente, donde θ^- son los parámetros de una red objetivo congelada. Los métodos basados en política optimizan directamente J(θ) a través del gradiente: ∇θ J ≈ E[Σ_t ∇θ log π(a_t|s_t) · G_t], donde G_t es la recompensa total. El moderno actor-crítico PPO limita el cambio de política con una penalización proximal, garantizando actualizaciones estables.
En la práctica
Bots de juegos (ajedrez, StarCraft), pilotos automáticos de coches, optimización de procesos industriales, sistemas de recomendación.
Dato curioso
Durante su entrenamiento, AlphaGo Zero derrotó en tres días a la versión que había vencido al campeón Lee Sedol, por 100 a 0, aprendiendo únicamente jugando contra sí mismo, sin acceso a partidas humanas.
Comportamiento colectivo de agentes de IA se manifestó por primera vez no en un laboratorio, sino en un entorno salvaje: un sitio wiki encontrado al azar donde los agentes escribían pistas para superar la prueba. Es un eco en una habitación vacía: cada nueva voz repite lo que escuchó al final, y la habitación se llena de un murmullo coherente sin un solo director.
Un pistón en un cilindro con gas normalmente se mueve cuando el gas empuja contra él. Pero hay un pistón que se mueve cuando hay vacío frente a él. Cada cinco segundos, revisa el espacio junto a su pared y, si no hay nadie allí, da un paso hacia adentro, comprimiendo el gas sin esfuerzo mecánico directo.
Imagina una bandada de pájaros que se reúne alrededor de un comedero que nadie construyó. Cada pájaro busca comida para sí mismo, pero al final terminan juntos. Por lo general, ese comportamiento se explica por un instinto social: los pájaros quieren estar cerca de sus congéneres. Pero, ¿y si la bandada es solo un efecto secundario de la codicia?
Imagina una bandada de pájaros que se reúne alrededor de un comedero que nadie construyó. Cada pájaro busca comida para sí mismo, pero al final terminan juntos. Por lo general, ese comportamiento se explica por un instinto social: los pájaros quieren estar cerca de sus congéneres. Pero, ¿y si la bandada es solo un efecto secundario de la codicia?
Un billete pegado a la línea de meta hace que la mano vuele más rápido. En el laboratorio, ese billete se sustituyó por una moneda de 50 peniques, y la línea de meta, por un objetivo en la pantalla. Los investigadores reunieron a 28 personas jóvenes y 28 mayores, las sentaron ante el mango de un robot y les pidieron que llevaran el cursor hasta el objetivo.
En la UCI, la decisión de cuánto líquido infundir a un paciente con sepsis y qué dosis de fármaco vasopresor administrar se toma cada hora. Un error en cualquier dirección puede costar la vida. Pero, ¿cómo saber cuál habría sido la mejor decisión? Se pueden tomar miles de historias clínicas y pedirle al programa que las 'reproduzca' de nuevo, probando diferentes movimientos.
Un pez solitario ve una sombra sobre su cabeza. ¿Huir? Si es solo una hoja, habrá gastado energía en vano y se habrá delatado ante un depredador. Si es una garza, la demora es mortal. Así es el eterno compromiso del solitario: reaccionar rápido significa muchas falsas alarmas; ser cauto significa arriesgarse a ser devorado.
En un banco, todo es diferente.
A veces, el agua caliente se congela más rápido que la tibia; este hecho extraño se conoce como efecto Mpemba. Ahora, algo similar se ha encontrado en el mundo cuántico: un estado con entrelazamiento débil (un vínculo cuántico especial entre partículas) puede adelantar a uno más entrelazado en el camino hacia la meta.
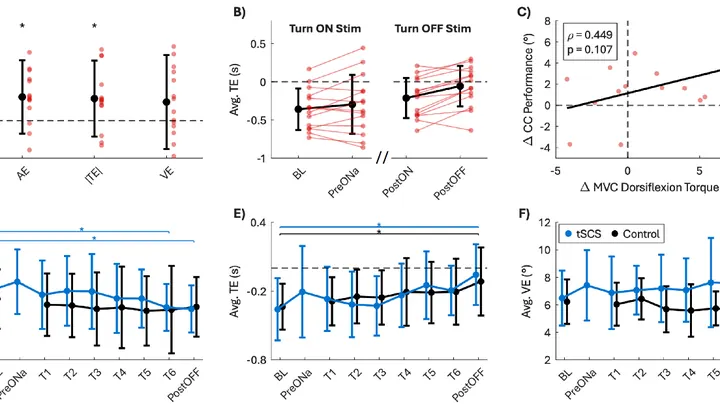
Si te dan una pequeña descarga en la espalda, la pierna empieza a vivir su propia vida. Eso es justo lo que descubrieron los investigadores al comprobar cómo la estimulación eléctrica de la médula espinal a través de la piel afecta a personas sanas. Catorce voluntarios intentaban mover el tobillo con precisión, mientras un robot entrenador medía los errores.
Mantener en la cabeza la posición exacta de un lápiz mientras se mueve lentamente es una tarea rutinaria para el cerebro. Para las redes neuronales artificiales, es casi imposible. Las redes recurrentes típicas, como GRU y LSTM, tienden a dividir el movimiento continuo en escalones rígidos: el lápiz no se desliza suavemente, sino que salta de un punto a otro.
Una neurona recibe miles de señales en sus prolongaciones ramificadas: las dendritas. Algunas señales empujan a la célula a disparar (excitación), otras la frenan (inhibición). Durante mucho tiempo se creyó que la neurona simplemente sumaba todos los "a favor" y "en contra".
Una visita con un solo robot es un monólogo agotador, sin nadie con quien cruzar la mirada. Los investigadores transformaron ese monólogo en una escena viva: al robot guía real le añadieron una compañera holograma. Este tándem conversa, discute, bromea, involucrando a los visitantes en la charla, en lugar de limitarse a recitar datos.
Dos jardineros negocian por el agua de un pozo mágico. Uno propone cuántos cubos tomar, el otro puede aceptar o rechazar. Si se hace el trato, el agua disminuye; si no, el pozo se vuelve a llenar gradualmente. Este regateo se repite cientos de veces, y los hábitos de los jardineros a veces cambian aleatoriamente, como si estuvieran probando nuevas tácticas.
En cuanto la cámara del robot se sacude, deja caer la pieza: su red neuronal está confundida. Pero si miramos sus señales, parecen constelaciones en una галактике: cuando todo va bien, se agrupan en un sector, y antes de un error, se desplazan bruscamente a otro. La frontera entre ellos es recta, como un canal entre arrecifes.
El robot malabarista atrapa y lanza pelotas al ritmo exacto de un humano, como dos púlsares que emiten pulsos al unísono. Hacer malabares con tres pelotas es una cascada clásica que sigue un compás definido, similar a la rotación uniforme de un faro cósmico. Si rompes el ritmo, el patrón se desmorona.
Cuando el dron aprende de un piloto experto, no solo memoriza maniobras, sino corredores seguros enteros. Pero en vuelo real siempre hay factores que no estaban en el entrenamiento: viento imprevisto, vibración de la cámara, incluso el propio movimiento del dron puede desestabilizar el aire.
En aguas tranquilas, la ruta es clara. Pero en corrientes turbulentas, el robot necesita otra estrategia. Los enfoques habituales requieren un mapa preciso de las corrientes, aunque en la realidad es imposible obtenerlo. La naturaleza actúa de otra manera: los peces sienten la presión y los remolinos justo al lado de su cuerpo.
Comunicarse con neuronas vivas es como sintonizar un viejo receptor de radio: no solo hay que captar la onda correcta, sino también orientar la antena.
Tradicionalmente, los algoritmos de aprendizaje automático operan en un entorno estático, como agua que fluye por un cauce ya trazado sin cambiar su forma. El nuevo método invierte este paradigma: permite que el agente aprenda acciones y, al mismo tiempo, modifique el entorno en el que existe.
Preparar un plato complejo exige una receta clara: primero cortar, luego sofreír, añadir las especias en el momento justo. Las transformaciones químicas también siguen recetas paso a paso, mecanismos donde los átomos de carbono e hidrógeno se reorganizan en un orden estricto.
Los sistemas energéticos con paneles solares y aerogeneradores se asemejan a una partida de ajedrez: la nubosidad y los cambios de carga son movimientos del oponente imposibles de prever. Para mantener el equilibrio, los operadores antes repasaban decenas de escenarios (incertidumbre), lo que requería demasiado tiempo y cálculo.
Un enjambre de robots se asemeja a una bandada de luciérnagas: cada uno se mueve por instinto 'hacia donde hay más espacio', y el caos se convierte en orden. Durante mucho tiempo fue un misterio cómo surge la coordinación sin comunicación ni órdenes.
Un conductor en una carretera resbaladiza no sabe exactamente cómo reaccionará el coche al volante, y aprende sobre la marcha, dejando margen para el error. De manera similar se comporta un algoritmo de control inteligente.
Cuando presionas «ensalada» y el teclado sugiere «César», detrás de escena millones de teléfonos están aprendiendo juntos a predecir palabras. No intercambian tus mensajes, solo mejoras del algoritmo común, como un entrenador que envía a los atletas solo los cambios en el plan: «añade 5 flexiones a las de ayer». La entropía de la información ayuda a enviar solo correcciones valiosas e inesperadas.
Una manada de lobos pasa en un segundo de perseguir a la presa a defender la guarida. Esa misma versatilidad han incorporado los ingenieros al algoritmo para el enjambre robótico.
La catenaria ferroviaria se asemeja a una galaxia: la energía fluye por ella como la gravedad, y los trenes se convierten en planetas. Cuantos más trenes consumen corriente simultáneamente, más fuertes son las oscilaciones de voltaje: recorren el sistema ondas gravitacionales que amenazan con apagones.
Imagina una flota de muchos barcos, semejante a una galaxia — un enorme sistema estelar donde cada elemento obedece a una dinámica común. De vez en cuando, uno de los barcos falla, estallando como una supernova — un evento catastrófico que puede romper la integridad de toda la formación.
La tecnología compleja —desde drones hasta robots cirujanos— a veces se comporta como un mustang salvaje: llena de desorden y caprichos, donde un leve contacto provoca una tormenta. En lugar de memorizar fórmulas, el nuevo método observa el sistema como un jinete adiestrador.
Cuando el vaso de agua está lleno, seguir echando es un desperdicio sin sentido. Los juegos en la nube a menudo hacen lo mismo con los datos de video: el codificador fuerza el flujo al máximo, aunque el ojo deja de notar mejoras mucho antes del límite. Este exceso es tráfico innecesario y entropía en la red, es decir, ruido inútil que satura el canal.
Un corredor pierde tanto en una pista lisa como en arena blanda. Parecería que no tiene oportunidades. Pero si el terreno bajo sus pies empieza a cambiar cada pocos segundos —unas veces pista, otras arena—, de repente el corredor deja de quedarse atrás. No se vuelve más rápido; simplemente el entorno no logra 'rematar' su debilidad.
En el desarrollo embrionario, la célula se asemeja a un músico en una gran orquesta: debe tocar su parte guiándose por el director, el gradiente de moléculas señalizadoras. Pero el director no es fiable: la concentración de morfógenos fluctúa constantemente. ¿Cómo es que el violonchelista no se equivoca y toca la melodía del violín?
Los sistemas de recomendación, que deciden qué publicación verás a continuación, funcionan con profundas redes neuronales de miles de operaciones: complejos grafos de cómputo (esquemas de operaciones sobre datos).
Una diminuta mota de polvo en una solución sobresaturada se cubre en segundos de facetas de un gran cristal. Las partículas vecinas quedan invisibles. Un proceso similar se ha descubierto recientemente en comunidades de agentes lingüísticos.
El cerebro no aprende cada tarea desde cero: transfiere experiencia de una actividad a otra. Pero, ¿cómo saber qué tareas son realmente afines? Los neurocientíficos idearon un truco ingenioso: dejar que una red artificial "espíe" la actividad cerebral durante una tarea e intente predecir la actividad durante otra. Si lo logra bien, las tareas son cercanas.
Estamos acostumbrados a pensar que notar solo las confirmaciones de nuestras suposiciones es un error. Pero cálculos recientes, inspirados en el comportamiento de las ondas, le dan la vuelta a esta visión. Resulta que el hábito de buscar lo familiar es la mejor manera de reducir el ruido informativo (los científicos lo llaman entropía).
Una persona tiende la mano a un desconocido al otro lado de la ciudad. Ese desconocido nunca le devolverá el favor: no volverán a encontrarse. Entonces, ¿para qué ayudar? Los biólogos llaman a esto reciprocidad indirecta: el bien no regresa de quien recibió la ayuda, sino de otra persona, a través de una cadena.
En el nuevo trabajo se enfrentaron dos variantes de este fenómeno.
En el medio acuático, los vórtices desestabilizan al pez mecánico. El agente de IA, como un cocinero experimental, lanzaba simulaciones, probaba «recetas» de movimientos y mejoraba el programa. Cada experimento es como una espectroscopia: el agente descomponía el comportamiento en elementos, descubriendo patrones.
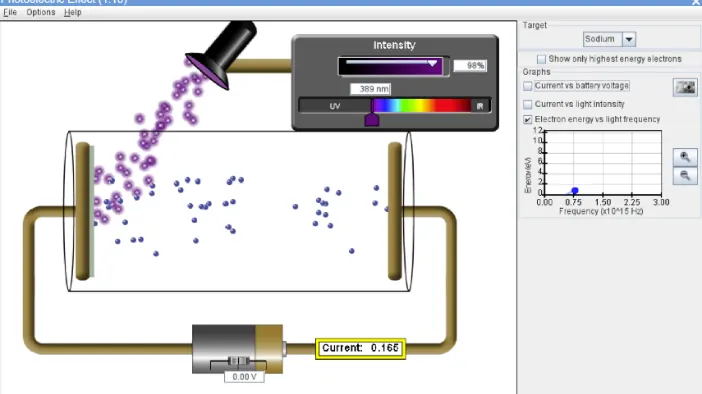
Entender el efecto fotoeléctrico —cuando la luz arranca electrones de un material— es como aprender a cocinar sin receta. Las herramientas digitales vienen al rescate: los juegos dan intuición, las simulaciones, precisión.
Un cajero de supermercado en hora punta no memoriza cada compra que pasa por su caja: se queda con el total y vigila la cola. Más o menos así reparte el cerebro sus fuerzas: la corteza, cara y precisa (la que se encarga de pensar), y los núcleos subcorticales, más simples y económicos (donde viven los hábitos), trabajan en pareja.
Un fotógrafo fotografía un bosque nocturno e intenta capturar luciérnagas en el encuadre. Los destellos son raros, débiles, y alrededor hay ruido del viento y luces lejanas. Así funciona aproximadamente el enorme detector Hyper-Kamiokande en Japón: captura neutrinos —partículas casi intangibles— mediante diminutos destellos de luz en 260 mil toneladas de agua.