Un examen para un científico de IA exprés
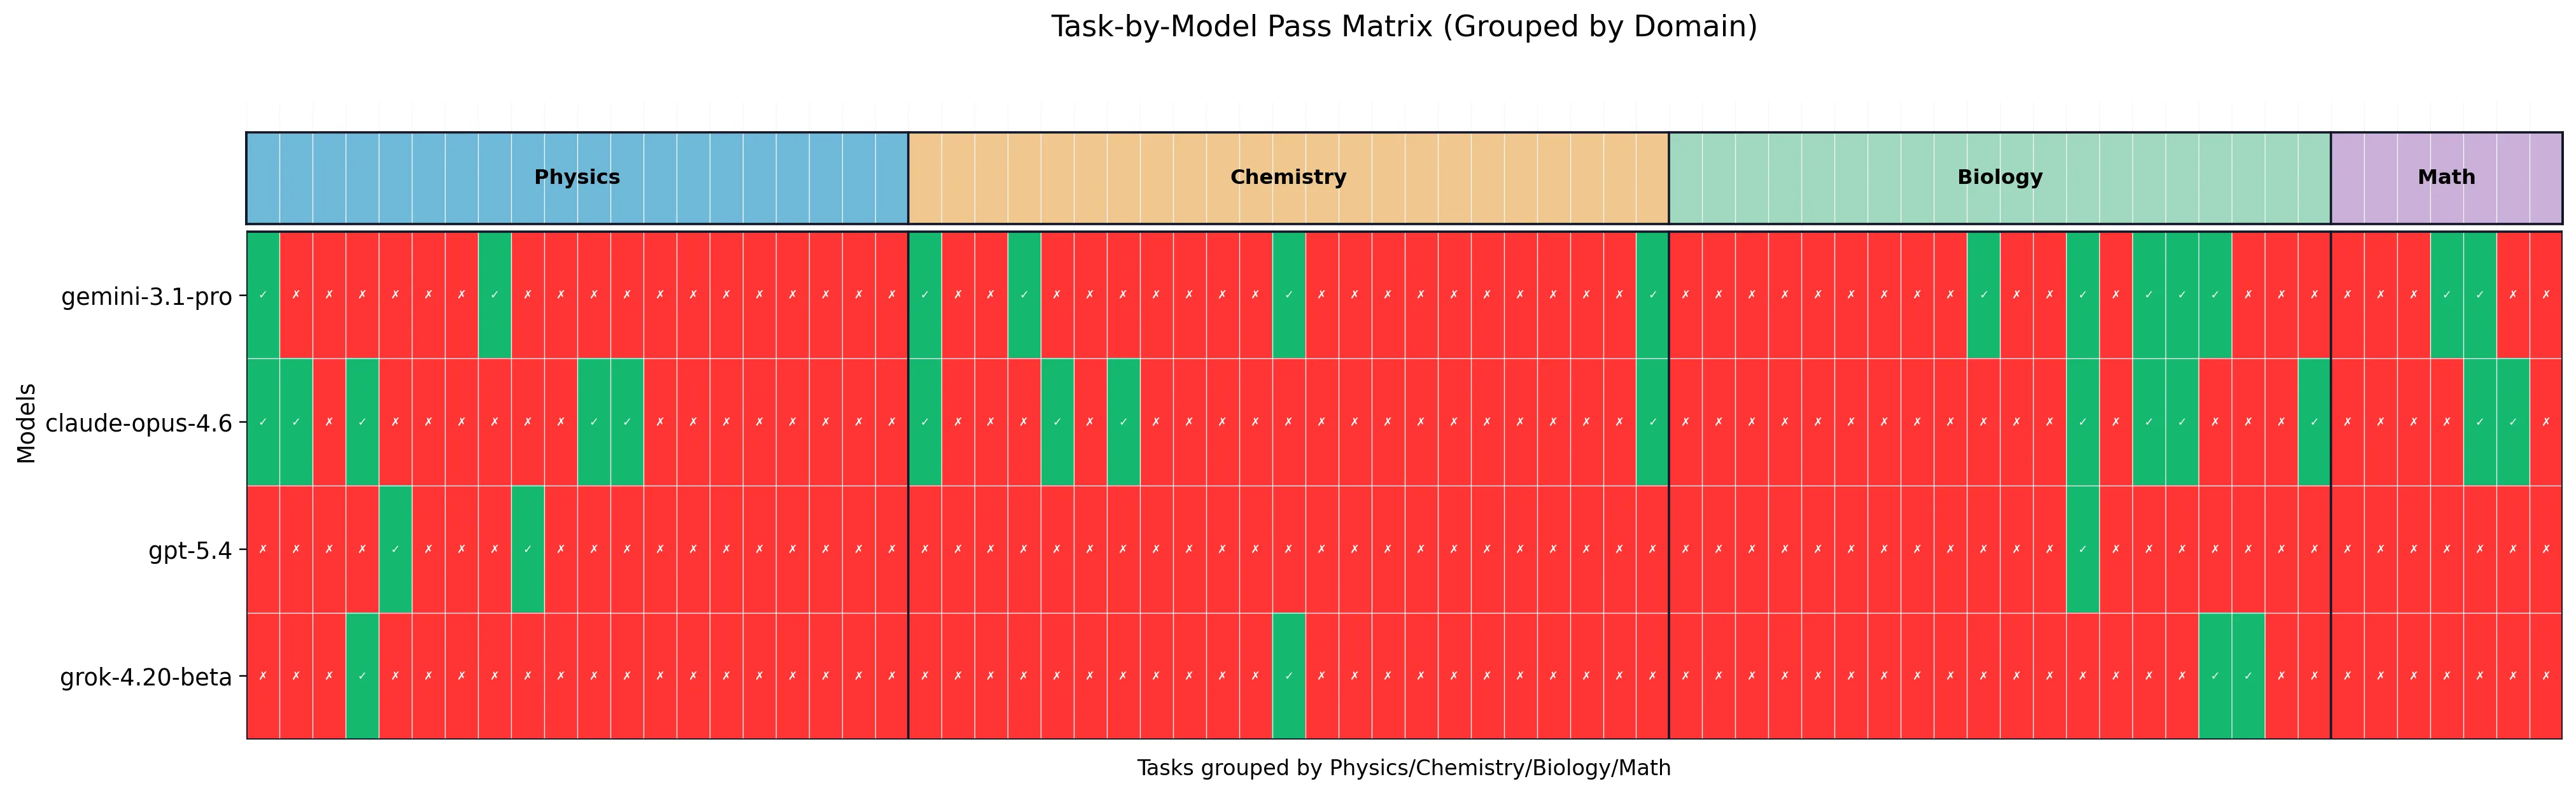
El mejor asistente de IA para científicos ha salido peor en el examen que un estudiante mediocre en un control. Solo un 21% de respuestas correctas, y eso es el techo para los cuatro modelos más potentes. Los problemas de la nueva prueba no los escribieron programadores, sino estudiantes de posgrado: personas que lidian a diario con la ciencia real.
La prueba se llama COMPOSITE-STEM. Contiene 70 problemas de física, biología, química y matemáticas. A diferencia de los ejercicios escolares, aquí no hay una única respuesta correcta: se evalúa el proceso de razonamiento. Por ejemplo, no basta con calcular un número, sino que hay que explicar por qué se eligió ese método. La evaluación se hace de dos maneras: comparación exacta de respuestas y juicio de otro modelo de lenguaje.
El resultado es aleccionador: incluso el mejor modelo resuelve solo uno de cada cinco problemas. Eso significa que la IA todavía está lejos de ser un verdadero asistente científico. Pero la prueba está abierta a todos: cualquier desarrollador puede probar su modelo e intentar mejorar el resultado.
Resumen original
tal como lo escribieron los autores, en inglés arXiv:2604.09836
AI agents hold growing promise for accelerating scientific discovery; yet, a lack of frontier evaluations hinders adoption into real workflows. Expert-written benchmarks have proven effective at measuring AI reasoning, but most at this stage have become saturated and only measure performance on constrained outputs. To help address this gap, we introduce COMPOSITE-STEM, a benchmark of 70 expert-written tasks in physics, biology, chemistry, and mathematics, curated by doctoral-level researchers. Our benchmark combines exact-match grading and criterion-based rubrics with an LLM-as-a-jury grading protocol, allowing more flexible assessment of scientifically meaningful outputs. Using an adapted multimodal Terminus-2 agent harness within the Harbor agentic evaluation framework, we evaluate four frontier models. The top-performing model achieves 21%, demonstrating that COMPOSITE-STEM captures capabilities beyond current agent reach. All tasks are open-sourced with contributor permission to support reproducibility and to promote additional research towards AI's acceleration of scientific progress in these domains.
Los problemas de la prueba se recopilaron entre estudiantes de posgrado, aquellos que aún recuerdan lo que es pasar la noche frente a una ecuación y dudar de cada paso.