Caza de genes con una sola palabra exprés
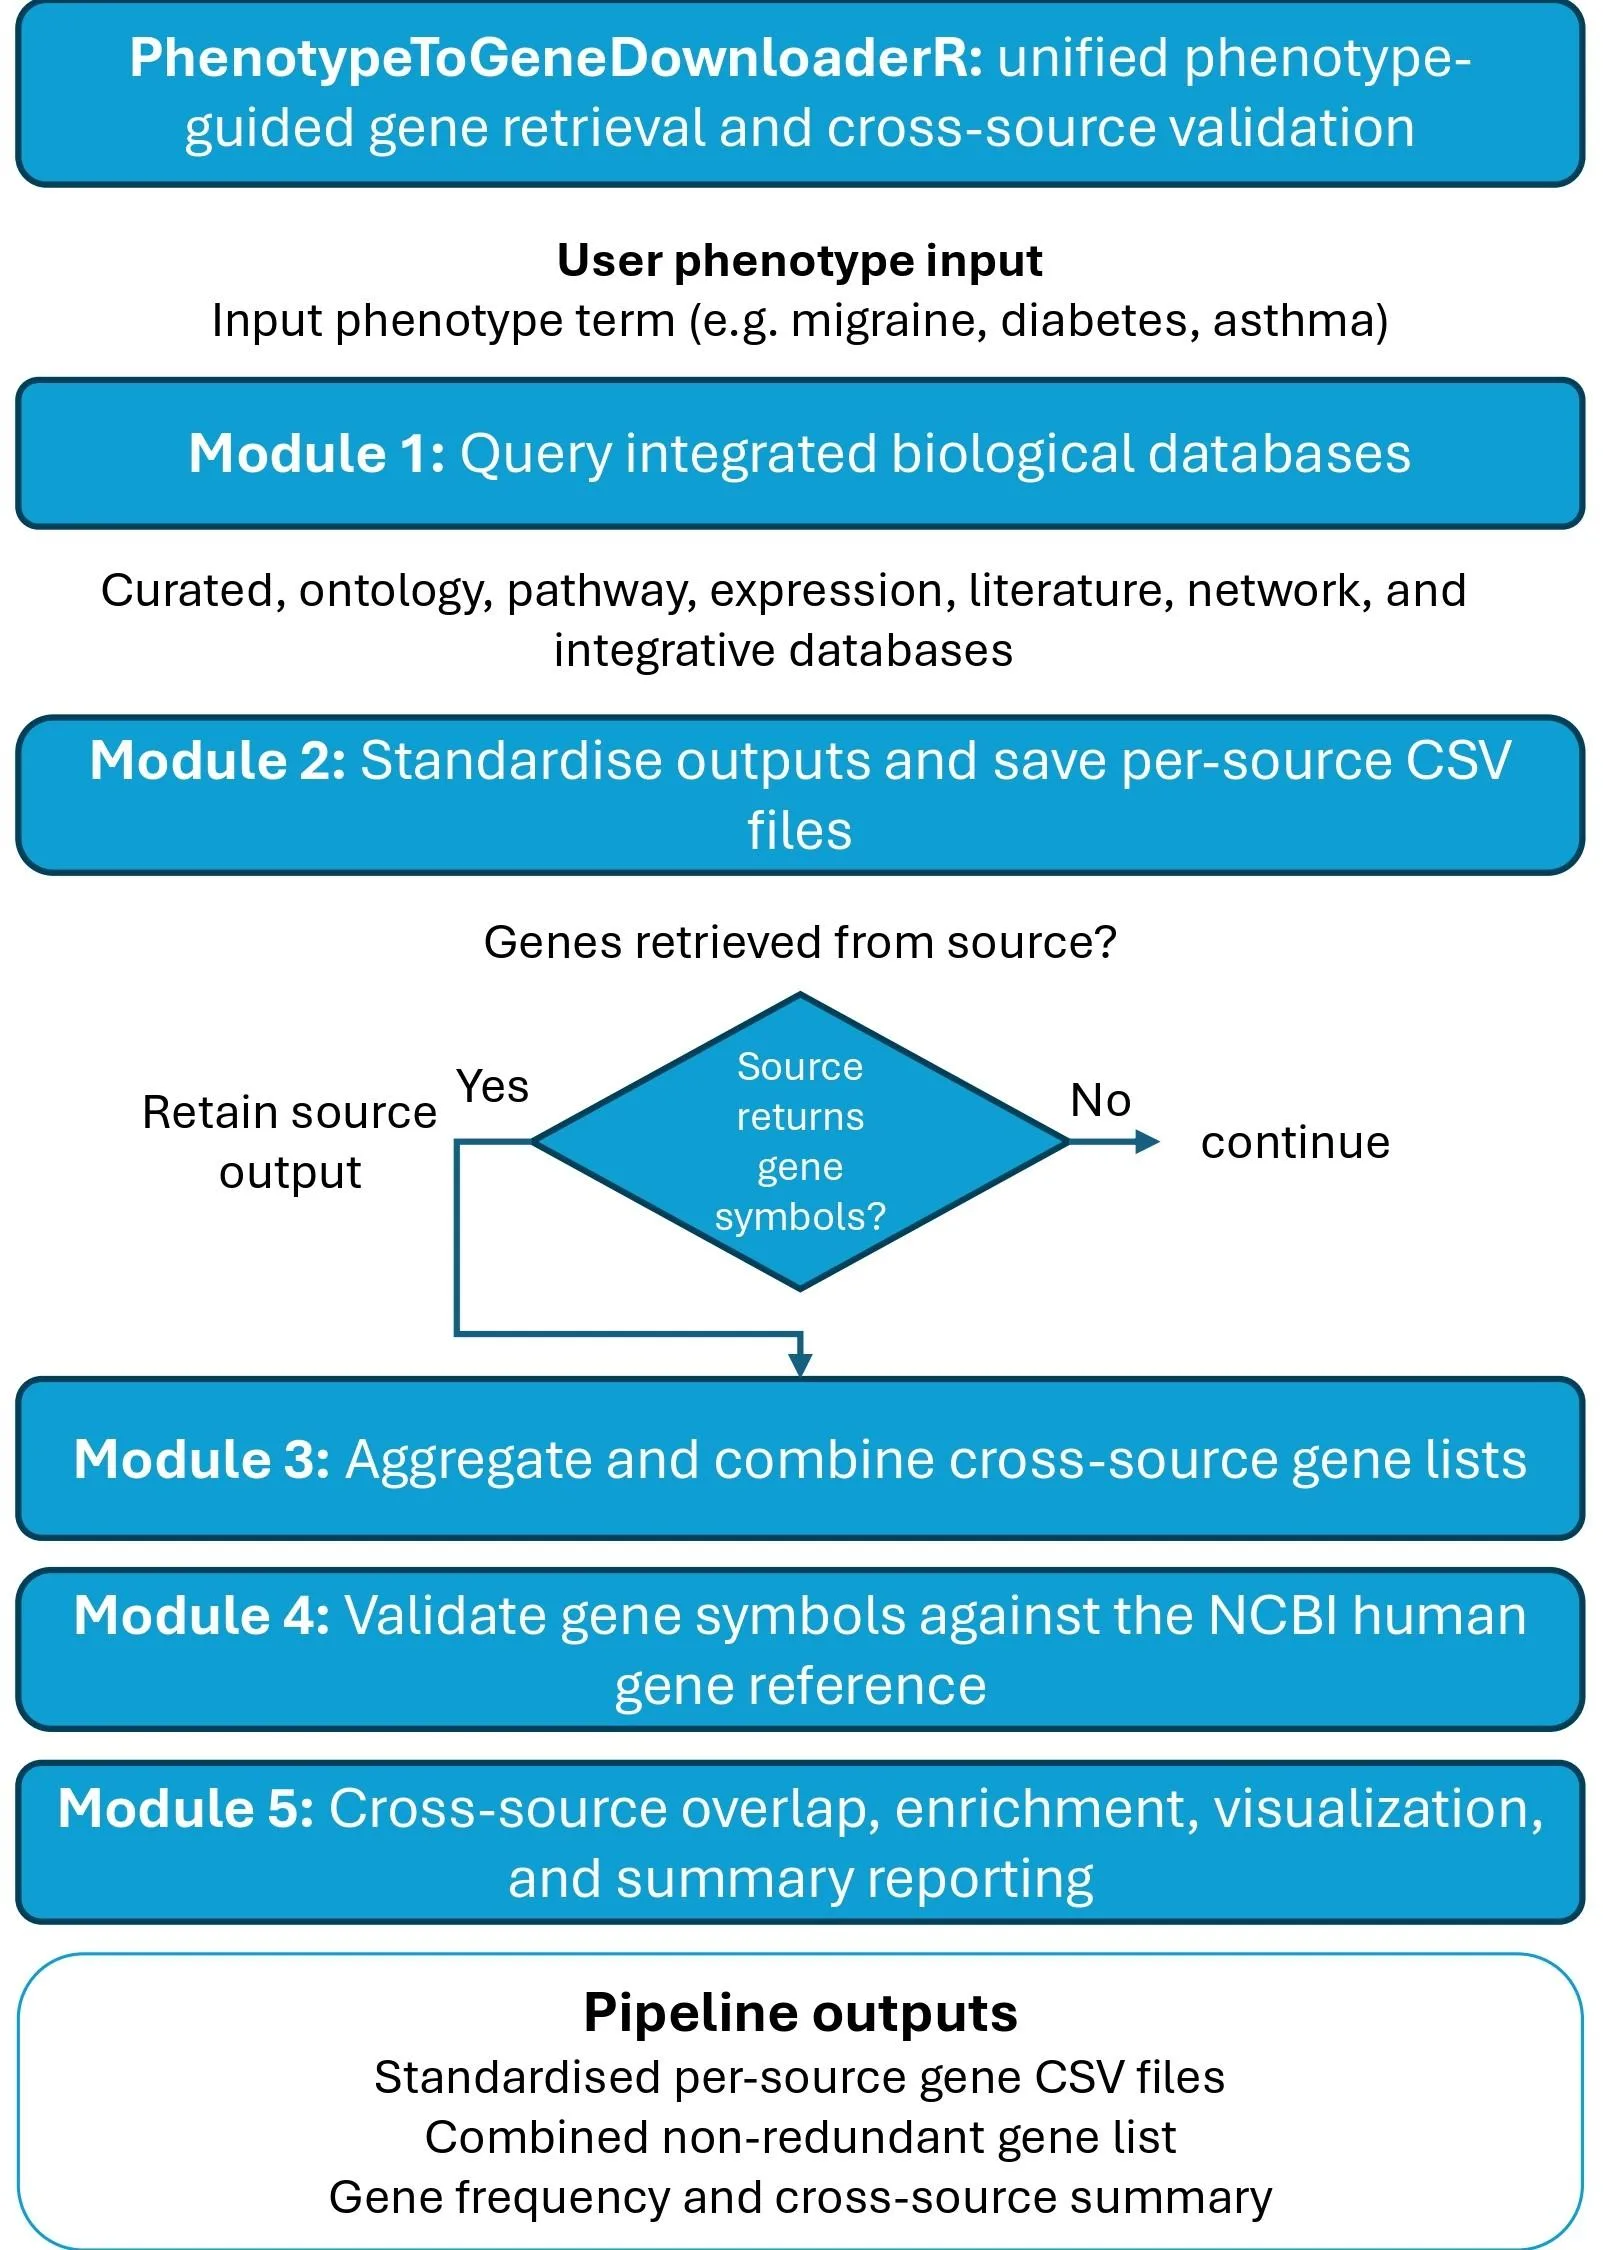
Armar un rompecabezas cuando las piezas están repartidas en 13 cajas con sistemas de numeración distintos: así se parece la búsqueda de genes asociados a una enfermedad concreta. Los datos existen, pero están escondidos en bases con sus propias interfaces, formatos e incluso lenguaje de descripción. El nuevo programa PhenotypeToGeneDownloaderR asume el papel de traductor y clasificador: le das el nombre de una enfermedad y él recorre todos los repositorios, extrae las listas de genes y las unifica bajo un mismo criterio.
Las listas recopiladas a menudo no coinciden entre sí: cada base ve el problema desde su propio ángulo, y ahí reside la fuerza del enfoque: al combinarlas, obtenemos un panorama más completo. Cuando el programa se puso a prueba contra el «estándar de oro» de tres fuentes autorizadas (HPO, ClinVar y OMIM), encontró 1039 de los 1056 genes conocidos, es decir, el 98,4%. Esto significa que casi nada se pierde y que el exceso es mínimo. Una herramienta así ahorra semanas de trabajo manual y reduce el riesgo de error cuando un médico o investigador traslada nombres de un sistema a otro a mano.
Resumen original
tal como lo escribieron los autores, en inglés arXiv:2605.01378
Identifying phenotype-associated genes is a common first step in polygenic risk score construction, enrichment testing, target prioritisation and variant interpretation, but relevant evidence is distributed across heterogeneous databases with different interfaces, formats and evidence models. Here, we present PhenotypeToGeneDownloaderR, a phenotype-guided R/Python pipeline for automated gene retrieval, harmonisation, symbol validation and cross-source summary analysis. Given a phenotype term, the pipeline queries integrated biological databases, standardises per-source outputs, combines gene lists, validates retrieved symbols against the NCBI human gene reference and generates summary tables and visualisations. Across 13 clinically relevant phenotypes and 13 databases, PhenotypeToGeneDownloaderR generated 136,487 raw gene retrievals, with at least one source returning genes for every phenotype. Across all 13 phenotypes, 100,175 of 114,345 combined input symbols were retained after direct or synonym-based validation, corresponding to an 87.6\% validation rate. Cross-source overlap was low, supporting the complementarity of integrated evidence sources. Against an HPO/ClinVar/OMIM-derived gold standard, the pipeline recovered 1,039 of 1,056 known phenotype-associated genes, corresponding to 98.4\% recall. PhenotypeToGeneDownloaderR provides a lightweight, reproducible upstream framework for generating candidate gene sets for downstream prioritisation and interpretation. The pipeline is implemented in R and Python, released under the MIT licence, and available at https://github.com/MuhammadMuneeb007/PhenotypeToGeneDownloaderR.
Los nombres de los genes a veces cambian, como las direcciones de las calles cuando se renombra una ciudad, y sin contrastar con un catálogo actualizado se puede terminar citando durante años la «casa vieja» que ya no figura en los mapas oficiales.