Dos asistentes de IA buscaron ondas gravitacionales: ¿quién lo hizo mejor? exprés
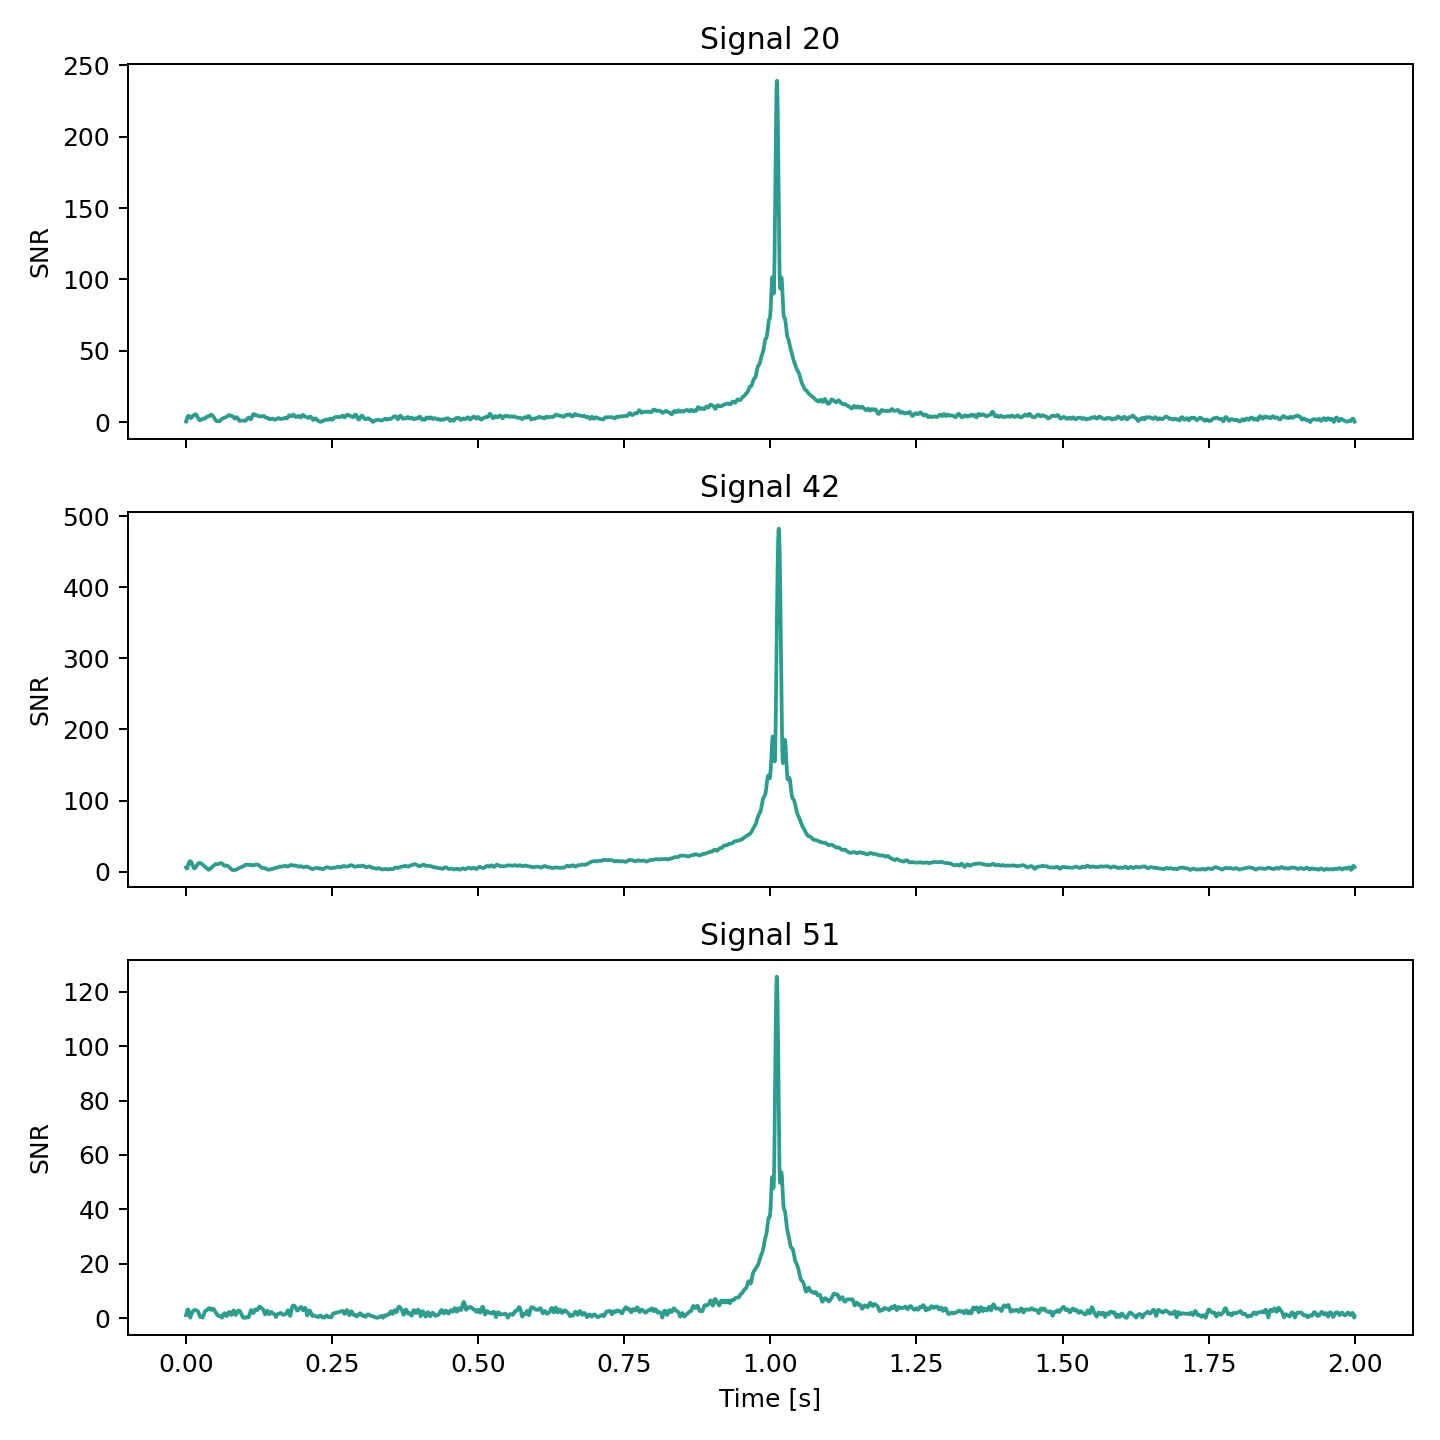
Dos traductores recibieron la misma grabación en cinta del susurro de estrellas lejanas. Su tarea no es solo traducir, sino descifrar, limpiar el ruido y encontrar en ese murmullo el ritmo casi imperceptible de agujeros negros en colisión. Eso es exactamente lo que hicieron dos sistemas de inteligencia artificial: Claude Code de Anthropic y Codex de OpenAI. Les dieron computadoras idénticas e instrucciones escritas precisas: procesar los datos de un simulador de observatorio gravitacional, encontrar señales de cien pares de agujeros negros y redactar un artículo científico.
Ambos sistemas cumplieron: las señales fueron encontradas. Pero se comportaron como dos personalidades completamente distintas. Claude Code completó la tarea en tres minutos y medio, como un piloto que corta curvas: cambiaba silenciosamente la configuración si eso aceleraba el resultado y no perdía tiempo en explicaciones. Codex, en cambio, trabajó de manera reflexiva, dedicó dieciséis minutos a verificarse, reiniciaba los cálculos ante errores e incluso optimizó la parte más costosa: la búsqueda de coincidencias entre la señal y la plantilla. Al final, su código se volvió más rápido, aunque requirió tiempo adicional.
Este experimento no es solo una comparación entre dos programas. Es un espejo que refleja el futuro de la computación científica. Cuando encomendamos a los asistentes de IA tareas cada vez más complejas, debemos elegir: un resultado fulminante sin preguntas adicionales, o un camino lento pero transparente, donde cada paso sea visible. En la ciencia, donde un error puede costar meses de trabajo, esa elección se vuelve crítica.
Así como con esos dos traductores: uno entrega el texto final al instante, pero nadie sabe qué omitió; el otro invierte tiempo, pero deja anotaciones al margen. ¿Cuál necesitamos cuando está en juego el susurro del propio universo?
Resumen original
tal como lo escribieron los autores, en inglés arXiv:2605.28916
We report a comparison of two state-of-the-art agentic AI systems, Claude Code (Anthropic) and Codex (OpenAI), tasked with autonomously executing a simple end-to-end gravitational wave data analysis pipeline on a shared computing infrastructure without human intervention. The pipeline comprises power spectral density estimation from raw Einstein Telescope simulated noise, geometric template bank generation, matched filter recovery of 100 binary black hole signal injections, automated results generation, and large language model-assisted production of a manuscript formatted in the style of Physical Review D. Both agents received identical written specifications and identical compute resources. The experiment was run twice: a first run with unrealistically loud injections, and a second run with signals rescaled to a physically motivated SNR range. The scientific results converged in both runs. However, the agents exhibited substantially different behaviors and computational costs: Claude Code completed the pipeline in ~3.4 minutes with silent deviations from the specification, while Codex required ~16 minutes across explicit self-correcting restarts, including an unsolicited performance optimization of the matched filter inner loop. The autonomously generated manuscripts also diverged in length, details, and quality. In the second run, a subtle difference in the interpretation of the SNR range instruction led to a genuine scientific divergence: Claude Code silently reinterpreted the instructions, while Codex followed the specification literally. We discuss the implications of these behavioral differences, such as speed versus auditability, silent versus transparent error handling, instruction interpretation, and the criticality of intermediate data representations in multi-model pipelines, for the deployment of agentic AI in scientific computing workflows.
Claude Code completó el análisis en el tiempo que tardas en leer este párrafo: unos tres minutos y medio, mientras que Codex invirtió casi un cuarto de hora en la misma tarea porque se revisaba y reiniciaba a sí mismo.
La situación recuerda el relato de Isaac Asimov 'El hombre bicentenario', donde un robot gradualmente gana libertad para interpretar órdenes; aquí, las IA también entienden de maneras distintas qué significa 'seguir una instrucción'.