Un escáner médico 3D que aprende a verlo todo de una vez exprés
Para transmitir la forma de una estatua con el más mínimo detalle, se puede dividir en millones de cubos diminutos y describir cada uno: es lento, pesado y la memoria de la computadora se resiente. Así es como normalmente se trabaja con imágenes médicas tridimensionales: una tomografía o una resonancia es una enorme matriz de esos cubos (vóxeles), y para crear o mejorar la imagen, la máquina tiene que procesarlos todos.
El nuevo enfoque recuerda al trabajo de un escultor que no modela pieza por pieza, sino que define las curvas suaves con una única línea matemática. Los autores crearon un sistema donde todo el volumen —hígado, cerebro o pulmones— se describe como una función continua de las coordenadas. Basta con introducir tres números (x, y, z) en la fórmula y el modelo indica la densidad del tejido en ese punto. El corazón del método es un autoencoder compacto: primero comprime la imagen en un pequeño conjunto de características clave (como un resumen de la lección) y luego la reconstruye, pero ya como un objeto continuo. Este truco evita la segmentación en parches superpuestos que antes era inevitable.
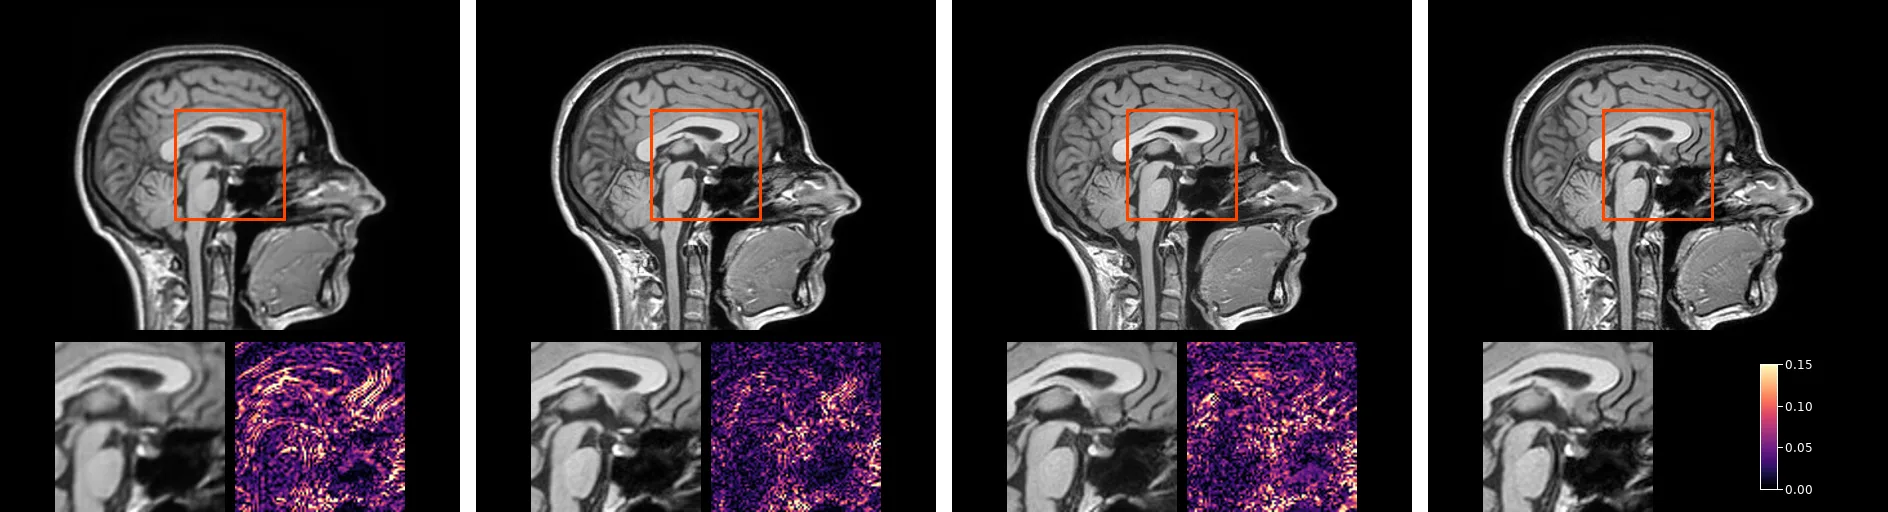
La utilidad práctica se ve de inmediato en dos escenarios. El primero es la creación de imágenes 3D sintéticas pero anatómicamente plausibles para entrenar a médicos o algoritmos. El segundo es la reconstrucción de imágenes de calidad a partir de datos incompletos. Por ejemplo, en una resonancia acelerada, el equipo realiza menos mediciones para que el paciente pase menos tiempo dentro del tubo, y el modelo completa lo que falta basándose en la anatomía "continua" aprendida. Y todo esto, en una sola tarjeta gráfica convencional, sin ensamblar la imagen a partir de retazos con costuras visibles.
Por supuesto, la reconstrucción directa píxel a píxel sigue siendo un poco más precisa en los detalles. Pero la ganancia en velocidad e integridad de la imagen es un compromiso que abre el camino al procesamiento de imágenes 3D de alta resolución en la práctica clínica rutinaria, sin esperar a los supercomputadores. Y entonces la estatua, que alguna vez se ensambló cubo a cubo, por fin adquirirá contornos suaves y vivos.
Resumen original
tal como lo escribieron los autores, en inglés arXiv:2607.16491
High-resolution three-dimensional (3-D) medical diffusion models remain constrained by the cost of processing full volumes, even when denoising is performed in a compact latent space. We introduce a continuous 3-D latent diffusion model (LDM) framework for computed tomography (CT) and magnetic resonance imaging (MRI) generation and measurement-guided reconstruction. Its central component is a compact autoencoder (AE) with a coordinate-conditioned local implicit image function (LIIF) decoder that represents a volume as a continuous function of spatial coordinates. By evaluating the convolutional decoder once on the latent grid and restricting repeated computation to a lightweight implicit head, the proposed design avoids overlapping sub-volume decoding while remaining differentiable for inverse-problem optimization. We evaluate the framework on CT volumes of 512^3 voxels and MRI volumes of 256^3 voxels. On high-resolution CT, the proposed AE is approximately x12-32 faster than the evaluated reference autoencoders, achieves the lowest peak graphics processing unit (GPU) memory use, and retains comparable structural fidelity despite a moderate reduction in voxel-level accuracy. The resulting frozen 3-D latent prior generates coherent full volumes without visible patch seams and can be applied, without task-specific retraining, to sparse-view CT and accelerated MRI reconstruction through hard data consistency. Although direct pixel-domain reconstruction remains more accurate, the results demonstrate that a single volumetric latent prior can support both unconditional generation and measurement-conditioned reconstruction on one GPU. Overall, the framework provides a practical trade-off between continuous volumetric decoding, computational efficiency, and fine-detail preservation. Our code will be made available at https://github.com/mellak/.
El tamaño de una tomografía típica de alta resolución (512×512×512 vóxeles) es comparable a 134 millones de píxeles, aproximadamente como 17 fotogramas en formato 4K empaquetados en un solo cubo.
En la película "Desafío total", el personaje de Arnold Schwarzenegger pasa por un escáner que crea al instante una copia holográfica tridimensional de su cuerpo; el nuevo modelo da un paso para que esa reconstrucción se convierta en rutina, no en ciencia ficción.