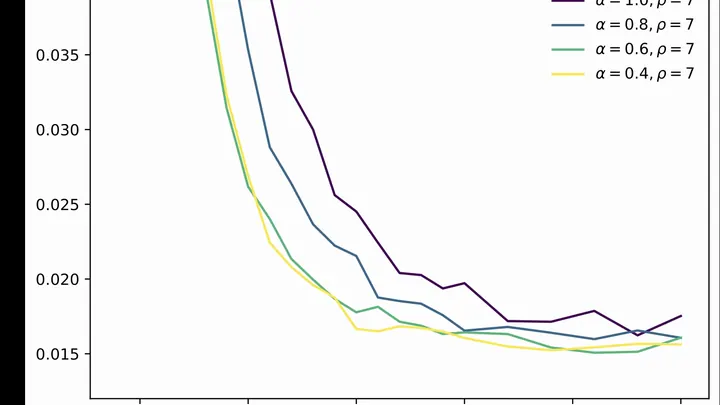
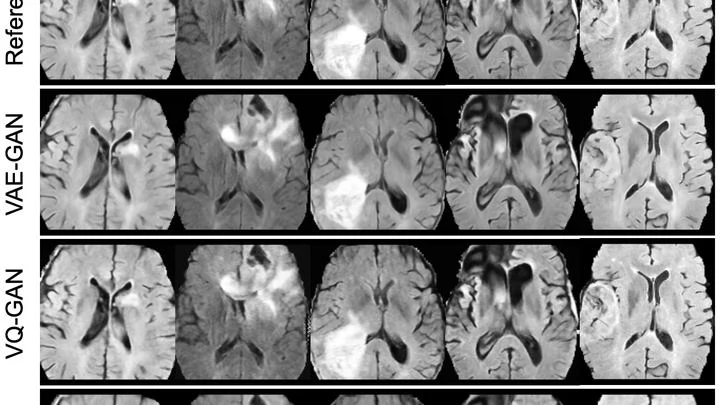
Los modelos de difusión son un enfoque generativo que transforma el ruido gaussiano en datos ordenados, como una fotografía de un gato. El proceso recuerda a la reconstrucción de un mosaico a partir de la memoria: solo se tiene un esquema aproximado, pero se recuerda cómo eran trabajos similares, y poco a poco se recrea el patrón, desde manchas borrosas hasta líneas finas. El modelo contiene una «representación» del mundo, aprendida a partir de millones de ejemplos, y por eso puede generar nuevas imágenes verosímiles. La diferencia clave frente a otras redes generativas es la iteratividad: la imagen no nace de inmediato, sino mediante una cadena de pequeñas mejoras.
Historia
Las raíces del método se remontan a trabajos de termodinámica y físicaestadística (por ejemplo, en los trabajos de Langevin), pero la versión moderna fue propuesta en 2015 por Jascha Sohl-Dickstein como un modelo generativo estocástico basado en la termodinámica del no equilibrio. El avance se produjo tras la publicación en 2020 del artículo «Denoising Diffusion Probabilistic Models», que mostró resultados sobresalientes en tareas de síntesis de imágenes. Perfeccionamientos posteriores (muestreo acelerado, control condicional) condujeron a la creación de sistemas como DALL-E 2, Imagen y Stable Diffusion, que revolucionaron el campo de la creatividad con IA.
Cómo funciona
Proceso directo: a la imagen original x0 se le añaden pequeñas cantidades de ruido gaussiano durante T pasos, obteniendo la secuencia x1, x2, ..., xT, donde xT es prácticamente indistinguible del ruido blanco. La transición en cada paso: q(xt|xt-1) = N(xt; sqrt(1-βt)·xt-1, βtI), donde βt es el programa de varianza. Proceso inverso: la red neuronal εθ(xt, t) aprende a predecir el ruido añadido en el paso t, minimizando E[||ε - εθ(xt, t)||²]. Durante la generación, se parte de xT ~ N(0, I) y se aplica iterativamente xt-1 = (1/√(αt))·(xt - (1-αt)/√(1-ᾱt)·εθ(xt, t)) + σt·z, donde z es ruido. Para acelerar el muestreo se utilizan los DDIM (Modelos Implícitos de Difusión con Eliminación de Ruido) saltándose pasos. Los modelos condicionales complementan la entrada con información de texto, clase, etc., guiando el proceso inverso.
En la práctica
Generación de fotografías a partir de descripciones textuales, mejora de imágenes en telescopios, diseño de nuevos materiales.
Dato curioso
Aunque parece que la difusión funciona lentamente, las versiones modernas generan una imagen en solo medio segundo en un potente chip gráfico.
La luz que no llega a la cámara deja igualmente su huella en ella. Así funciona el nuevo método de fotografía: se ilumina el objeto con un color y la imagen se compone a partir de otro. En el cristal, las ondas de luz se mezclan y la información sobre lo invisible se transfiere al rayo visible.
En el experimento se utilizó un cristal de tiogalato de plata.
Bajo el microscopio electrónico, una proteína se ve como una serie de sombras borrosas: cientos de miles de imágenes de la misma molécula, pero desde ángulos distintos y con un fuerte ruido. Antes, a partir de esas sombras se armaba primero una 'neblina' tridimensional: un mapa de cómo se distribuye la carga eléctrica dentro de la proteína.
Capturar la luz partícula a partícula es como oír un susurro en una fábrica atronadora. Una cámara con multiplicación electrónica (EMCCD) hace precisamente eso: convierte un solo fotón que llega a un píxel en una avalancha de electrones que ya se puede medir.
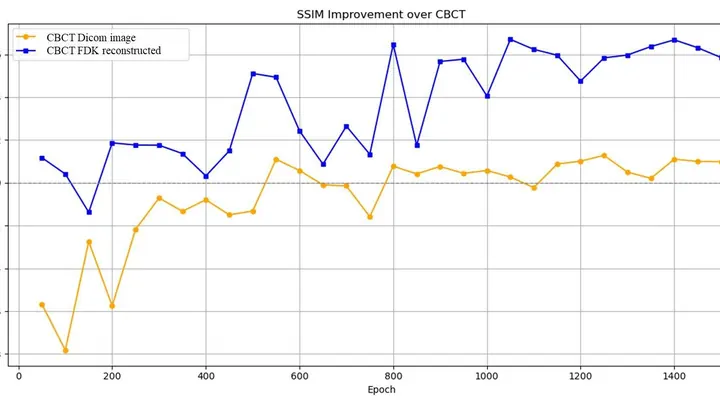
Una imagen obtenida con una dosis baja de rayos X se parece a mirar a través de un vidrio empañado: los contornos están, pero los detalles se ahogan en una neblina turbia. Los médicos necesitan este tipo de imágenes durante la radioterapia para apuntar el haz con precisión al tumor y no dañar los tejidos sanos.
Un coágulo crece como una bola de nieve que rueda montaña abajo: al principio es pequeño, va atrapando capas nuevas, y cuándo se convertirá en una avalancha es difícil de adivinar. En la sangre se desencadena una larga cadena de reacciones —la cascada de coagulación—, donde una sustancia despierta a otra y el coágulo gana masa.
La red neuronal predice el futuro de un sistema, por ejemplo, cómo se arremolina el plasma en un campo magnético o cómo cambia un rostro en un video. Los errores son inevitables, y cuanto más lejos mira hacia adelante, más se acumulan. En el momento de la operación es imposible contrastar con la respuesta correcta: simplemente no existe.
El cerebro no solo reacciona al mundo: constantemente está adivinando qué ocurrirá en el instante siguiente. Este principio se conoce como codificación predictiva: las neuronas comparan las expectativas con la realidad y actualizan su imagen interna cuando ocurre un error.
Una piscina con arena mojada. Presionas en una esquina, y el agua comienza a moverse. ¿Pero cómo exactamente? En lugar de un círculo uniforme, puede extenderse en lenguas, quedarse atrapada en algunas zonas durante mucho tiempo y atravesar otras rápidamente.
El cosmos se asemeja a una tela de seda con hilos de una red oscura que sobresalen. Las verdaderas telas las vemos solo como pequeños retazos — a través de telescopios, en catálogos reales de galaxias.
Un río nocturno salpicado de diminutas chispas. No es plancton: es polen funcional, un sensor de milímetros que flota solo y mide por sí mismo la química del agua.
Cada partícula es un pequeño laboratorio. En su interior se encuentran dos reactivos: uno provoca el brillo al contacto con el contaminante, y el segundo, un filtro de color, elimina las interferencias.
Para transmitir la forma de una estatua con el más mínimo detalle, se puede dividir en millones de cubos diminutos y describir cada uno: es lento, pesado y la memoria de la computadora se resiente.
WanSong crea música como un escultor talla una estatua: comienza con ruido, similar al rugido de una cascada, y poco a poco elimina todo lo superfluo hasta que emergen notas y voces puras. Este método — difusión — transforma el caos en orden, como la tinta que se dispersa en el agua, pero al revés. El modelo no pega sonidos a partir de fragmentos, sino que da a luz una canción terminada de una vez.
A diferencia de las cámaras comunes, las cámaras de eventos solo registran los momentos en que la luz se vuelve más brillante o más tenue. No generan instantáneas, sino un flujo interminable de destellos. Los científicos transformaron este flujo en una imagen nítida de la Tierra mientras volaban sobre ella en un satélite.
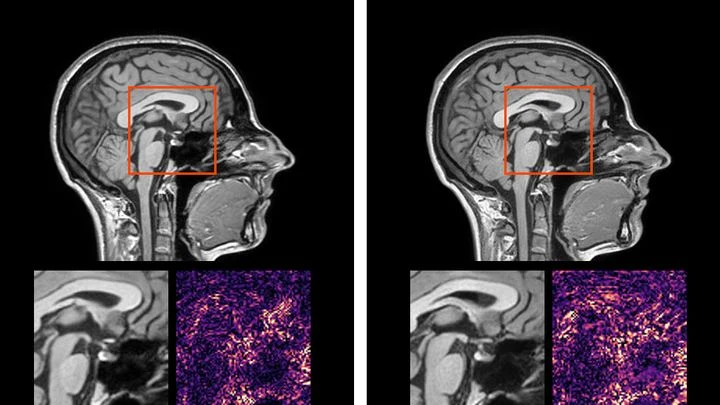
El volumen de datos de una sola tomografía computarizada es comparable a varias películas de larga duración. TCAM-Diff evita este cuello de botella: el programa comprime la imagen tridimensional en tres proyecciones de sombra, como un escultor reconstruye una estatua tridimensional a partir de siluetas en tres paredes.
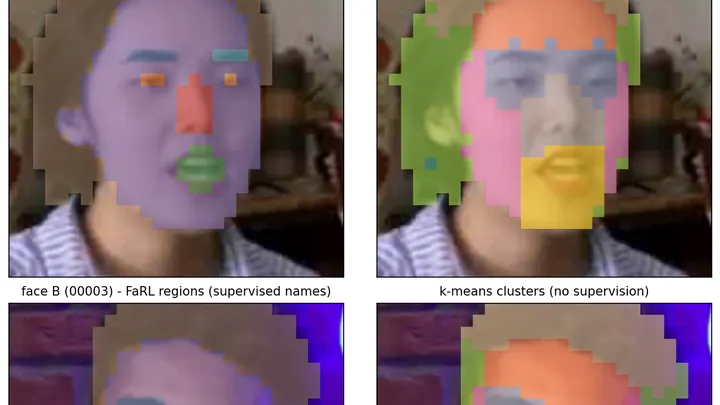
Entrenado con imágenes cotidianas, el modelo DINOv3 comenzó inesperadamente a ver rostros como un espectro: por sí mismo, sin pistas, resalta las zonas de los ojos, la nariz, la boca.
En una habitación ruidosa, una persona distingue la voz deseada gracias a los dos oídos, que captan la diferencia en la llegada del sonido. Una computadora con varios micrófonos actúa de la misma manera: recibe pistas espaciales, de dónde habla cada uno.
Antes, estas pistas se usaban para enfocarse en una sola dirección, como el haz de una linterna.
La red neuronal que genera sonidos a partir de texto se parece a una cocina donde cada «plato» lo preparan decenas de cocineros. Muchos solo estorban: envían señales falsas y malgastan recursos.
El microlente gravitacional es un asombroso efecto cósmico, predicho por Einstein y desarrollado por Zwicky. Un cuerpo masivo que pasa entre nosotros y una estrella lejana curva su luz como una lente, creando amplificaciones y distorsiones características.
Una proteína en la célula no es una escultura congelada. Se mueve constantemente: se dobla, respira, tiembla. Este movimiento, llamado dinámica, determina cómo funciona la proteína. Pero observar directamente esa danza es difícil, y la simulación por computadora a menudo requiere enormes recursos computacionales.
La luz de galaxias lejanas galaxias viaja miles de millones de años hacia nosotros, pero en el camino la invisible telaraña de materia oscura la dobla y distorsiona. Este efecto, predicho por Einstein en el marco de la relatividad general, se conoce como lente gravitacional.
Un estudiante que durante años resolvió problemas de libros ajenos recibe de repente tres cuadernos con observaciones reales del océano. Hay pocos problemas, pero ya ha visto cientos de similares, y ahora le bastan un par de ejemplos para captar el estilo del nuevo maestro.
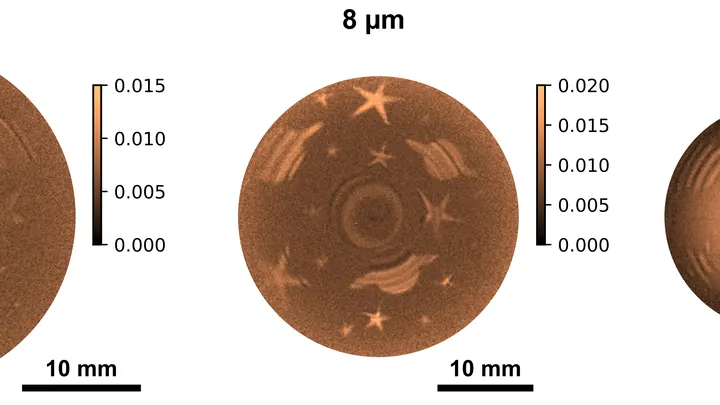
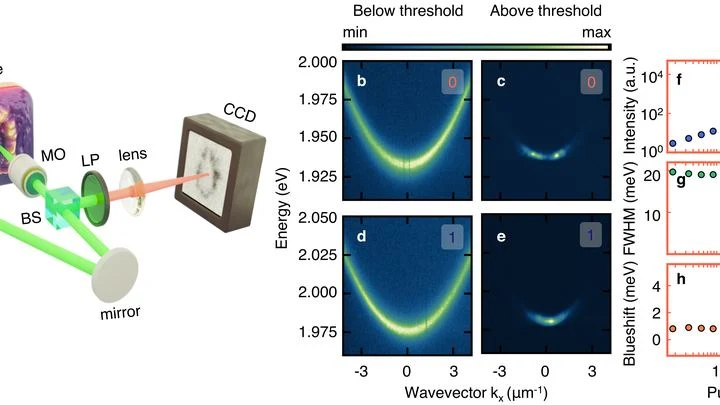
Las redes neuronales generativas que crean imágenes suelen depender de la aleatoriedad digital. Pero un grupo de investigadores construyó un sistema donde la aleatoriedad no nace en el código, sino en una diminuta cavidad óptica con un colorante orgánico.
Un fotocatalizador es un polvo que, al estar en agua bajo la luz, la descompone en burbujas de hidrógeno y oxígeno. El material más popular para esto es el dióxido de titanio, el pigmento blanco de pinturas y pastas de dientes.
A través de las ondulaciones del agua, las piedras en el fondo de la piscina parecen desplazadas y distorsionadas. De manera similar, la gravedad de la materia oscura invisible curva la luz de las galaxias lejanas: este fenómeno se conoce como lente gravitacional débil.
En una gran sala de tribunal se celebra una reunión. Cientos de intérpretes neuronales escuchan a la vez fragmentos de frases y deben reconstruir con ellos una imagen unificada. Así es como las grandes redes cerebrales convierten las señales dispersas de los ojos en la imagen completa de un objeto.
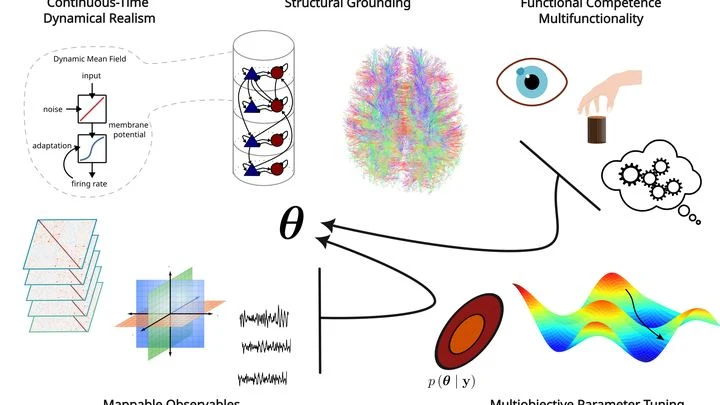
Los ingenieros construyen un automóvil. Unos ensamblan una réplica exacta del motor, con cada pistón y cada bujía, pero el coche no avanza: le faltan el volante y las ruedas. Otros crean un kart rápido y autónomo, pero su motor de plastilina no se parece al real. Algo parecido ocurre en la ciencia del cerebro.
Un artista pinta un retrato pincelada a pincelada, y luego le ofrecen una cámara con flash: un clic y listo. Así se podría describir la transición de los modelos de múltiples pasos a los de un solo paso en la creación de imágenes de galaxias.
Un mosaico de grandes baldosas de colores. Cada baldosa es la cantidad media de precipitación durante un mes entero en un territorio del tamaño de un pequeño país. Para una idea general, la imagen sirve, pero si necesitas saber si ayer llovió sobre una ciudad concreta, es inútil.
Toda medición de luz se enfrenta a una limitación fundamental: los fotones llegan al sensor de la cámara de forma desigual. Esta ondulación natural (ruido de disparo) difumina los detalles finos, como si intentaras escuchar un instrumento suave en una orquesta a través del ruido de la sala.
Una gota de tinta en un vaso de agua se dispersa rápida y uniformemente. Pero si el agua está aprisionada entre esferas densamente empaquetadas, la nube de tinta avanza lentamente y de forma caprichosa: rodea obstáculos, se atasca en cuellos estrechos. Así más o menos se mueven las moléculas de agua en el tejido vivo.
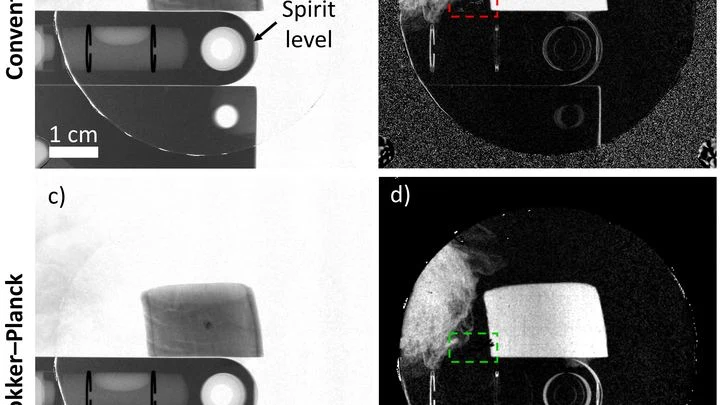
Un aparato de rayos X con rejillas no toma una, sino tres imágenes a la vez: una radiografía normal, un mapa de las curvaturas invisibles del haz y una imagen de las microestructuras que dispersan la luz. Juntas permiten detectar, por ejemplo, enfisema o fibrosis pulmonar. Pero hay un inconveniente: para separar esas tres capas se necesita un truco matemático.
Un río que no fluye en un cauce abierto, sino dentro de una esponja, y cuya corriente cambia de un lugar a otro, puede compararse con el sistema glinfático del cerebro. Se trata de una red de canales finísimos alrededor de los vasos sanguíneos, por los que el líquido cefalorraquídeo se filtra hacia el interior del tejido y arrastra los desechos acumulados durante el día.
Un batido de frutas se prueba con dos pajitas diferentes. Una deja pasar solo los trozos grandes, la otra solo el líquido. Por separado, las sensaciones engañan, pero juntas dan la clave: aquí parece plátano, y aquí, fresa.
La luz, al atravesar un medio turbio como la leche o el tejido vivo, se dispersa en todas direcciones. Reconstruir dónde se absorbió la luz con mayor intensidad es como adivinar la forma de un objeto caído a partir del charco en el asfalto.
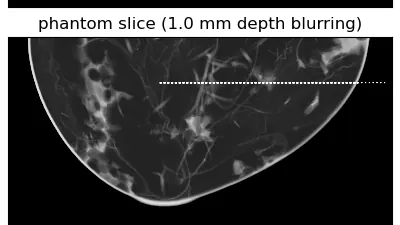
El equipo de rayos X recorre el seno en un arco y toma varias imágenes desde diferentes ángulos. A partir de estos fotogramas planos, la computadora construye una imagen tridimensional, como si se ensamblara un mosaico a partir de sus piezas. Pero si las piezas del mosaico están arrugadas o manchadas, la imagen sale borrosa.
Entrenar un modelo aerodinámico preciso se asemeja al arte culinario: primero el chef domina cientos de recetas para captar los principios generales, y luego perfecciona fácilmente un plato concreto. Los ingenieros crearon AeroTransformer y le «alimentaron» con 30 mil formas diferentes de alas: toda una galaxia de ideas culinarias galaxia.
Una cámara normal capta la luz reflejada por los objetos y con ella forma una imagen. Pero si el objeto está oculto tras un obstáculo o no refleja la luz, las ondas de radio vienen al rescate: atraviesan paredes y niebla, y una computadora reconstruye la imagen a partir de las señales dispersas.
Un láser que normalmente emite un haz uniforme, cerca del umbral de emisión comienza a temblar, como una cuerda justo antes de sonar. Estas vibraciones no son un defecto, sino ruido cuántico: los átomos dentro del láser emiten luz de manera aleatoria, sin ninguna causa externa.
El agua de un río rodea las piedras, el aire se desvía alrededor del ala de un avión: estos movimientos se describen con ecuaciones que son difíciles de resolver incluso con una computadora potente. Las redes neuronales pueden aproximar estas soluciones, pero a menudo se equivocan cuando los datos se recogen solo en unos pocos puntos o están contaminados por ruido.