Un lazarillo electrónico para la visión artificial exprés
Una prótesis ocular no transmite al cerebro una fotografía, sino un punteado escaso de puntos brillantes: los fosfenos. Para distinguir en ese parpadeo una taza o unas llaves, la persona debe mover la cabeza como una linterna en la oscuridad e ir juntando poco a poco los contornos del objeto. Es un proceso lento, parecido a armar un rompecabezas al que le faltan la mayoría de las piezas.
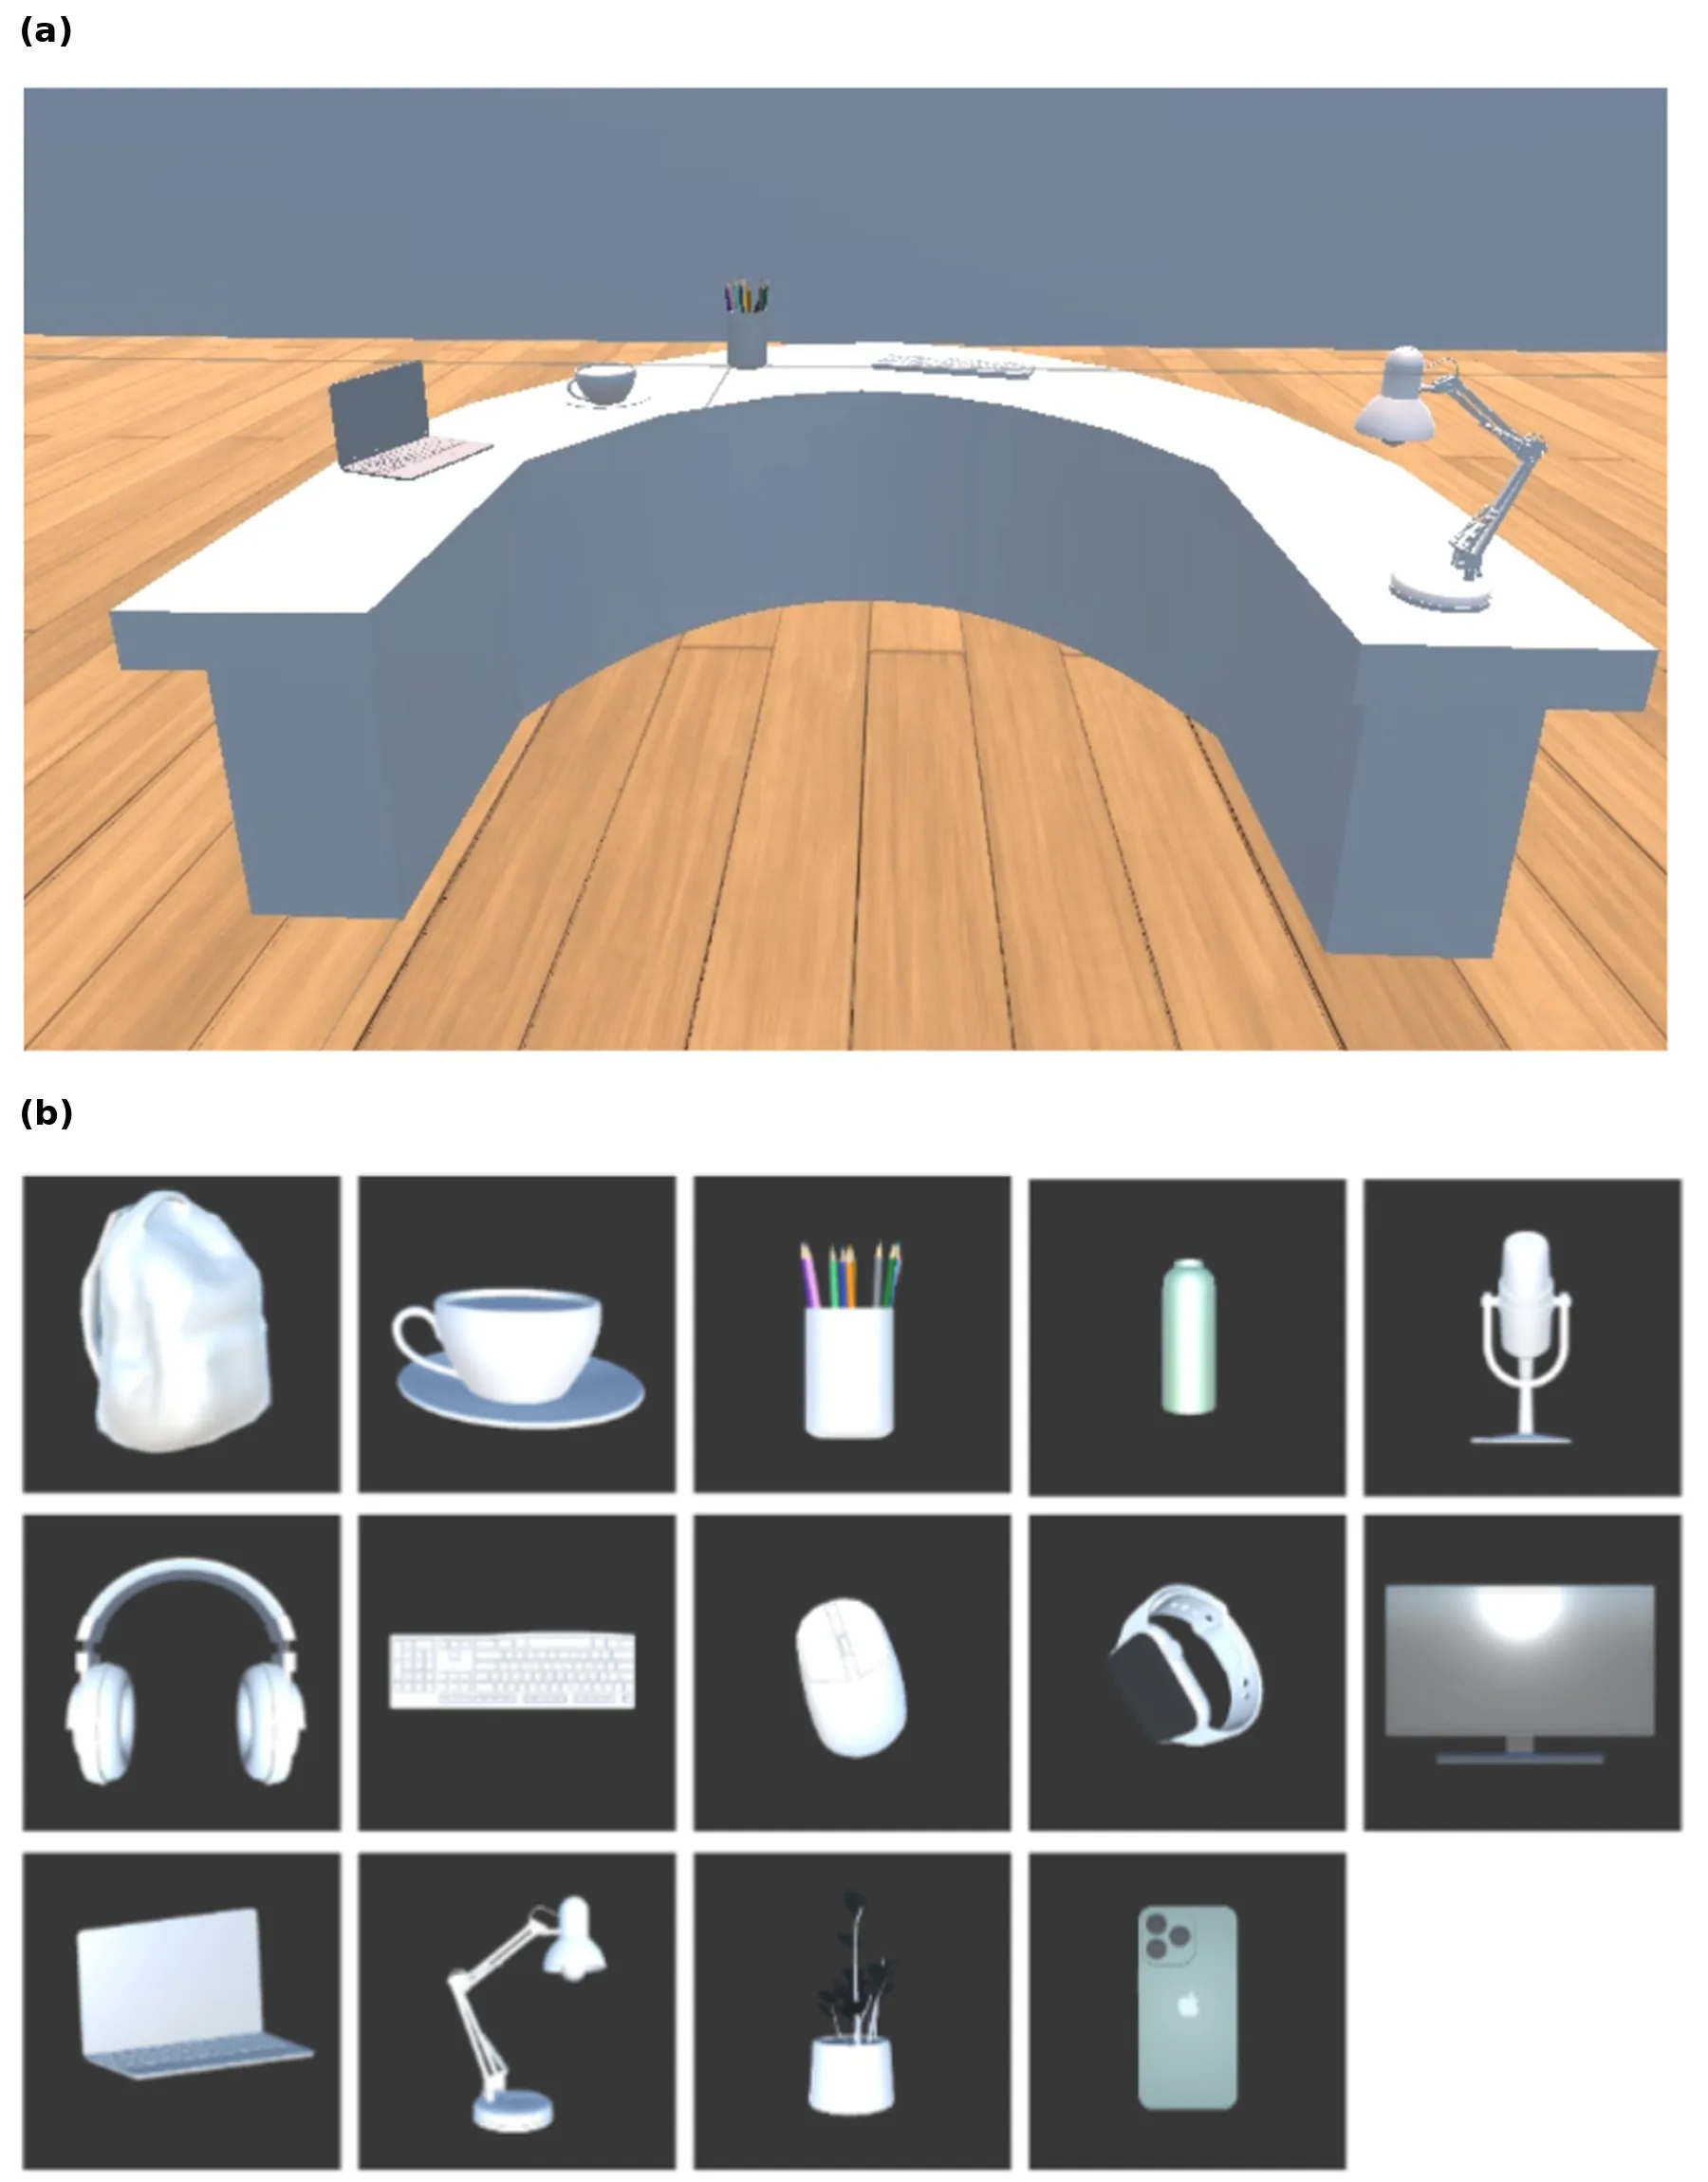
Un grupo de investigadores intentó avisar al cerebro cuándo está realmente concentrado en la búsqueda. Veintidós participantes se pusieron un casco de realidad virtual con electrodos secos que registraban la actividad eléctrica del cerebro (EEG). Frente a ellos aparecía una mesa virtual dibujada con una dispersión escasa de puntos luminosos. La tarea: encontrar el objeto indicado lo más rápido posible. Tras cada intento, aparecía en la pantalla una marca de color: una lucecita verde si el índice especial de compromiso —la relación entre las ondas beta rápidas y la suma de las ondas alfa y theta lentas— era alto, y roja si era bajo. El segundo grupo veía marcas iguales, pero aleatorias, sin relación con su cerebro.
La mejora se dio en todos: al final de la sesión, las personas encontraban los objetos más rápido y con más precisión. Pero la pista "inteligente" no dio ventaja alguna: ni en velocidad, ni en errores, ni en la carga percibida. El cerebro aprendía por sí solo, simplemente acostumbrándose al mosaico de fosfenos y desarrollando sus propias estrategias de exploración. La variabilidad entre participantes fue enorme: en algunos, el compromiso crecía en sincronía con el éxito; en otros, no.
Los autores no renuncian a la idea de un asistente neuroadaptativo. Demostraron que se puede combinar EEG y visión protésica en un mismo sistema portátil. Pero una sola sesión de entrenamiento y un índice de compromiso tosco no bastan. Quizás el futuro asistente deba ajustar un ritmo personal para cada usuario, como se afina un instrumento musical antes del concierto.
Resumen original
tal como lo escribieron los autores, en inglés arXiv:2607.23889
Visual prostheses require users to interpret sparse and distorted artificial percepts through active visual search. We developed an EEG-guided neuroadaptive training platform for simulated prosthetic vision in immersive virtual reality and evaluated its feasibility in a sham-controlled object-localization task. Twenty-two sighted participants searched a virtual desk scene rendered through a low-resolution phosphene simulation while EEG was recorded using a dry-electrode headset integrated with a head-mounted display. During training, participants received post-trial visual feedback based either on a commonly used EEG engagement index, $$\beta/(\alpha+\theta)$$, or on visually matched non-contingent sham values. Both groups showed comparable within-session improvements in localization performance, consistent with practice, increasing familiarity with the simulated percepts, or refinement of search strategies. EEG-contingent feedback did not produce reliable group-level benefits in localization accuracy, completion time, workload, or modulation of the targeted index. Exploratory analyses showed substantial individual variability, but did not establish a feedback-specific relationship between the engagement index and behavioral performance. These findings demonstrate the feasibility of integrating EEG-contingent feedback with immersive simulated prosthetic vision, while identifying important limitations of the EEG measure, single-session training protocol, and post-trial feedback design.
Los fosfenos son esas "estrellitas" que vemos si presionamos con fuerza los ojos cerrados. Precisamente de esos destellos se compone la imagen en la mayoría de las prótesis visuales modernas.