Comment choisir les meilleurs prédicteurs d'El Niño dans un ensemble de modèles ✛
Contexte
La prévision d'El Niño – Oscillation australe (ENSO) à plus d'un an est considérée comme l'un des problèmes les plus tenaces de la climatologie. Le phénomène naît de l'interaction non linéaire entre l'océan et l'atmosphère, est sensible aux conditions initiales et est enveloppé dans un réseau de téléconnexions. Les centres opérationnels font généralement la moyenne de toutes les prévisions d'ensemble, supposant implicitement que chaque membre est également utile. En réalité, c'est rarement le cas : dans tout ensemble suffisamment grand, il y a des membres systématiquement forts et d'autres systématiquement faibles. Ce travail se situe à côté des recherches qui améliorent les prévisions grâce aux réseaux de neurones, aux schémas hybrides statistiques-dynamiques et à l'analyse de la prévisibilité saisonnière, mais il s'en distingue par son focus sur la sélection de prévisions déjà existantes plutôt que sur la création de nouveaux modèles.
Méthodes
Nous avons utilisé un ensemble de 40 prévisions ENSO généré par un modèle moderne à haute résolution. La dispersion entre les membres provient de perturbations des conditions initiales, de processus stochastiques et de légères modifications des paramétrisations. Les prévisions ont été vérifiées par rapport à l'indice Niño-3.4, c'est-à-dire l'anomalie moyenne de la température de surface de la mer dans la région 5°S–5°N, 170°W–120°W. Les données d'observation proviennent de l'ensemble ERSST. Pour chaque paire « délai de prévision – saison cible », les membres ont été classés selon deux métriques : le RMSE (erreur quadratique moyenne, reflétant la précision de l'amplitude) et la corrélation de Pearson (reflétant la concordance des phases). Ensuite, les cinq meilleurs selon chaque métrique ont été sélectionnés, combinés avec des poids proportionnels à leur présence dans les deux listes, et comparés à la moyenne équipondérée des 40 membres.
Résultats
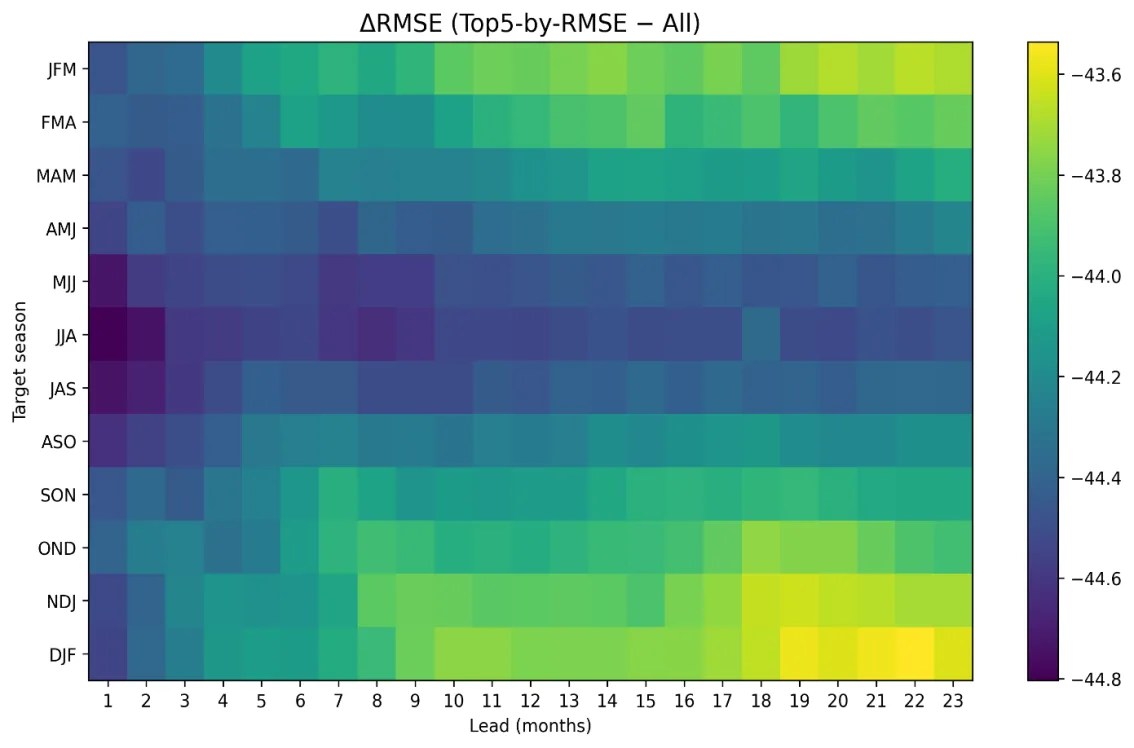
Le sous-groupe sélectionné surpasse systématiquement l'ensemble complet selon les deux métriques à tous les délais de 1 à 23 mois. Aux délais courts, le gain est modeste : la corrélation augmente de +0.02 et l'erreur diminue de 0.14 °C. À 23 mois, l'écart devient dramatique : la corrélation augmente de +0.43 (soit une hausse de 172 %) et l'erreur diminue de 0.18 °C (soit 22.5 %). Les améliorations maximales se produisent pendant les saisons de transition SON (septembre–novembre) et DJF (décembre–février), lorsqu'il est important de prédire avec précision le début et la maturité de l'événement. L'erreur diminue particulièrement fortement au milieu de l'année, pendant les saisons JJA (juin–août) et MJJ (mai–juillet). Les tests statistiques confirment : aux délais supérieurs à 12 mois, plus de 85 % des paires « délai–saison » montrent une amélioration significative de la corrélation, et près de 80 % une réduction significative de l'erreur.
Implications
Ce travail démontre qu'il existe, au sein des ensembles existants, une ressource cachée de précision qui peut être extraite par une simple sélection des membres. Contrairement aux recherches voisines qui construisent de nouveaux prédicteurs neuronaux ou hybrides, ici ni le modèle ni le coût de calcul ne changent, seulement la manière de combiner des prévisions déjà prêtes. C'est la première évaluation quantitative rigoureuse de l'ampleur du gain apporté par la sélection des membres, spécifiquement pour la prévision à long terme de l'ENSO, toutes saisons et tous délais confondus.
Développements futurs
La prochaine étape consiste à apprendre à reconnaître les membres forts en temps réel, lorsque les observations futures sont encore inconnues. Pour cela, il faut des méthodes fiables d'estimation de l'erreur de prévision sans accès à la vérification, ainsi que des schémas adaptatifs qui mettent à jour les poids des membres au fur et à mesure que de nouvelles données arrivent. Si de tels outils peuvent être créés, le gain rétrospectif se transformera en avantage opérationnel pour les centres de prévision.
Impact
La méthode peut être transposée à la prévision d'autres phénomènes climatiques, comme le dipôle de l'océan Indien ou l'oscillation nord-atlantique. Elle est également applicable aux ensembles multimodèles, où les membres sont des modèles entiers.
Prochaines étapes
Développer des procédures d'estimation de l'erreur de prévision en temps réel et les tester sur des données historiques. Ensuite, vérifier si le gain persiste lors du passage à des ensembles multimodèles et sous différents scénarios de changement climatique.
Problèmes ouverts clés
Ce travail touche directement au problème de la « barrière de prévisibilité printanière », c'est-à-dire la chute brutale de la précision des prévisions ENSO lors du passage du printemps. Il est montré que la sélection des membres de l'ensemble peut atténuer cette barrière et étendre l'horizon utile de prévision jusqu'à deux ans, ce qui reste l'un des principaux défis non résolus de la prévisibilité climatique.
Le regard de la machine du savoir
Cette section s'adresse à l'auteur du travail et à ses collègues. Les travaux voisins ont été trouvés par une recherche sémantique dans notre archive, et non par correspondance de mots. Nous n'évaluons pas : nous montrons le champ autour.
Ce que fait ce travail
Les auteurs ont utilisé un ensemble de 40 prévisions ENSO, ont classé les participants selon le RMSE et la corrélation pour chaque paire « échéance–saison », ont sélectionné les cinq meilleurs selon chaque métrique et les ont combinés avec des poids. La comparaison avec la moyenne équipondérée a montré une augmentation de la corrélation jusqu'à +0.43 et une réduction de l'erreur à 0.18 °C à l'horizon de 23 mois, en particulier pendant les saisons de transition.
Où est sa force
Il est démontré qu'une simple sélection des membres de l'ensemble, sans modifier les modèles, apporte un gain substantiel en précision pour les prévisions ENSO à long terme, surtout au-delà d'un an, là où les méthodes traditionnelles sont faibles.
Vers où avancer
- Il pourrait être intéressant d'examiner comment la méthode de sélection des membres se combine avec des approches hybrides statistico-dynamiques qui tiennent compte des composantes cycliques de la prévisibilité.appui : Une prévision qui se souvient du cycle arXiv:2602.18949
- À proximité se trouve un travail où la prévision est améliorée en tenant compte de la prévisibilité saisonnière ; une adaptation de la sélection à des saisons spécifiques pourrait apporter un gain supplémentaire.appui : La météo spatiale a ses saisons arXiv:2605.27057
- Dans nos archives, il y a un exemple d'utilisation de réseaux de neurones pour la prévision de l'ENSO ; combiner la sélection avec un apprentissage sur les membres sélectionnés pourrait ouvrir de nouvelles possibilités.appui : El Niño se laisse prédire dix-huit mois à l'avance arXiv:2601.12251
À essayer
- Vérifier si le gain de la sélection persiste lorsqu'on utilise d'autres métriques, comme la corrélation de rang ou l'erreur sur des phases spécifiques de l'ENSO.
- Étudier comment la composition des meilleurs membres varie d'une année à l'autre et s'il est possible de prédire leur apparition à l'avance.
- Appliquer la sélection non pas à des membres individuels mais à des grappes de prévisions, afin de réduire le bruit dû aux valeurs aberrantes individuelles.
Pourquoi cela peut compter
Si la sélection améliore de manière stable les prévisions à des échéances supérieures à un an, cela pourrait renforcer la valeur pratique des alertes à long terme sur El Niño pour l'agriculture, l'énergie et la gestion des risques.
Travaux voisins dans notre archive
- El Niño se laisse prédire dix-huit mois à l'avanceproximité 0.56
- La météo spatiale a ses saisonsproximité 0.53
- Prévisions météo sur une seule carte graphiqueproximité 0.50
- Cycles solaires : comment la balançoire magnétique fait osciller l'avenirproximité 0.48
- Une prévision qui se souvient du cycleproximité 0.48
- Éruptions solaires : des prévisions fiables et honnêtesproximité 0.47
L'archive est vide autour de ce travail : l'analyse la plus proche n'est qu'à 0.56, contre 0,64 d'ordinaire. Il semble qu'on ait peu foré à côté.
À l'horizon de 23 mois, les cinq membres sélectionnés donnent une corrélation supérieure de 0.43 à la moyenne de l'ensemble, comme si la prévision devenait presque une fois et demie plus « synchrone » avec la réalité. Et le coût de calcul n'augmente pas d'un centime.
Chiffres clés
- augmentation de corrélation à 23 mois: +0.43
- réduction du RMSE à 23 mois: 0.18 °C
- nombre de membres de l'ensemble: 40
- délai maximal de prévision: 23 mois
- proportion d'améliorations significatives aux longs délais: >85%