Comment trouver dans l'océan la « manette » pour prévoir la pluie ✛
Imaginez que vous réglez un récepteur radio et que vous tournez lentement le bouton pour capter la bonne station. Un agent par apprentissage par renforcement fait la même chose, sauf qu'au lieu d'un bouton, il dispose de deux rectangles dans l'océan qu'il peut déplacer et étirer. Son objectif est de trouver une paire de zones telle que la différence de température de l'eau entre elles prédise le mieux les pluies en Thaïlande.
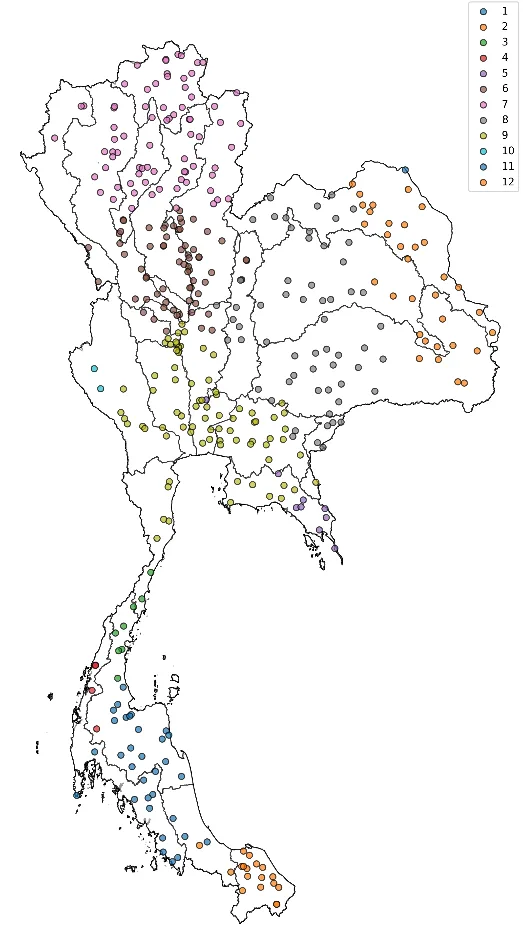
Au départ, les régions étaient choisies selon des données anciennes, et la corrélation avec les pluies était faible. L'agent a testé des milliers de combinaisons, et la corrélation s'est renforcée de plusieurs fois. Les zones trouvées se sont déplacées de centaines de kilomètres par rapport aux zones initiales. Lorsque ce nouveau signal a été ajouté à un réseau de neurones avec mémoire, l'erreur de prévision à un an a diminué dans presque tous les groupes de stations météorologiques. Seule une région n'a pas montré d'amélioration.
Désormais, les prévisionnistes peuvent utiliser cet indice pour mieux planifier l'eau pour l'agriculture et les réservoirs. Auparavant, on ne savait pas quelles parties de l'océan écouter ; maintenant, l'agent a trouvé la bonne fréquence, et le signal est plus clair.
L'agent d'apprentissage par renforcement a exploré des milliers de combinaisons de rectangles dans l'océan pour trouver une paire de régions dont la différence de température prédit le mieux les pluies. Les régions optimales se sont avérées déplacées de centaines de kilomètres par rapport à celles initialement proposées dans les études précédentes.