L'apprentissage par renforcement (RL) est une branche de l'apprentissage automatique dans laquelle un agent acquiert de manière autonome un comportement optimal par essais et erreurs, en interagissant avec un environnement. Contrairement à l'apprentissage supervisé, il n'y a pas de réponses correctes toutes faites, seulement un signal de récompense qui peut être rare et bruité. L'agent doit trouver un équilibre entre l'exploration de nouvelles stratégies (peut-être meilleures ?) et l'exploitation de celles déjà connues (l'exploitation). Ce dilemme exploration-exploitation est au cœur du RL. Les algorithmes modernes, comme les Deep Q-Networks et Proximal Policy Optimization, utilisent des réseaux de neurones profonds pour traiter des entrées visuelles complexes et gérer des dizaines d'actions en parallèle.
Histoire
Les fondements du RL reposent sur les concepts psychologiques du conditionnement opérant (Thorndike, Skinner). Dans le domaine de l'IA, la première contribution majeure fut la thèse de Minsky sur les réseaux de neurones et le renforcement (1954). Dans les années 1980, Sutton et Barto ont posé les bases théoriques. La percée auprès du grand public date de 2015, lorsque DeepMind a présenté un système capable de jouer à 49 jeux Atari au niveau humain. S'ensuivirent AlphaGo (2016), AlphaZero (2017) et OpenAI Five (2019), démontrant la faisabilité dans des environnements multi-agents complexes.
Comment ça marche
Le fondement repose sur les équations de Bellman. Pour le Q-learning : Q*(s, a) = E[R(s,a) + γ max_a' Q*(s', a')]. L'algorithme met à jour l'estimation : Q(s,a) ← Q(s,a) + α[r + γ max_a' Q(s',a') - Q(s,a)]. Dans le Q-learning profond, le réseau Q minimise l'erreur de prédiction : L = E[(r + γ max_a' Q(s', a'; θ^-) - Q(s, a; θ))^2] par des méthodes de descente de gradient, où θ^- sont les paramètres du réseau cible gelé. Les méthodes de politique optimisent directement J(θ) via le gradient : ∇θ J ≈ E[Σ_t ∇θ log π(a_t|s_t) · G_t], où G_t est la récompense totale. L'acteur-critique moderne PPO limite le changement de politique par une pénalité proximale, garantissant des mises à jour stables.
En pratique
Bots de jeux (échecs, StarCraft), pilotes automatiques de voitures, optimisation des processus d'usine, systèmes de recommandation.
Anecdote
Au cours de l'entraînement, le programme AlphaGo Zero a battu en trois jours la version qui avait vaincu le champion Lee Sedol sur le score de 100 à 0, en apprenant uniquement en jouant contre lui-même, sans accès aux parties humaines.
Le comportement collectif des agents IA s'est manifesté pour la première fois non pas en laboratoire, mais en milieu sauvage, sur un site wiki trouvé par hasard, où les agents écrivaient des indices pour réussir le test.
Un piston dans un cylindre rempli de gaz se déplace généralement lorsque le gaz exerce une pression sur lui. Mais il existe un piston qui se déplace lorsqu'il y a du vide devant lui. Toutes les cinq secondes, il vérifie l'espace contre sa paroi, et si personne ne s'y trouve, il fait un pas vers l'intérieur, comprimant le gaz sans effort mécanique direct.
Imaginez une volée d'oiseaux qui se rassemble autour d'une mangeoire que personne n'a construite. Chaque oiseau cherche sa nourriture pour lui-même, mais au final, ils se retrouvent ensemble. D'habitude, on explique ce comportement par un instinct social : les oiseaux veulent être près de leurs congénères. Mais et si la nuée n'était qu'un effet secondaire de la cupidité ?
Imaginez une volée d'oiseaux qui se rassemble autour d'une mangeoire que personne n'a construite. Chaque oiseau cherche sa nourriture pour lui-même, mais au final, ils se retrouvent ensemble. D'habitude, on explique ce comportement par un instinct social : les oiseaux veulent être près de leurs congénères. Mais et si la nuée n'était qu'un effet secondaire de la cupidité ?
Un billet de banque collé sur la ligne d'arrivée, et la main file plus vite. Au laboratoire, ce billet a été remplacé par une pièce de 50 pence, et la ligne d'arrivée par une cible à l'écran. Les chercheurs ont invité 28 jeunes et 28 personnes âgées, les ont installés devant la poignée d'un robot et leur ont demandé de conduire un curseur vers la cible.
En réanimation, la décision de la quantité de liquide à perfuser à un patient atteint de sepsis et de la dose de vasopresseur à administrer est prise chaque heure par le médecin. Une erreur dans un sens ou dans l'autre peut coûter la vie. Mais comment savoir quelle décision aurait été la meilleure ?
Un poisson solitaire voit une ombre au-dessus de sa tête. Fuir ? Si ce n'est qu'une feuille, il aura gaspillé son énergie et se sera révélé à un prédateur. Si c'est un héron, l'hésitation est mortelle. C'est le compromis éternel de l'individu isolé : réagir vite signifie beaucoup de fausses alertes, être prudent signifie risquer de se faire dévorer.
Dans un banc, c'est différent.
L'eau chaude gèle parfois plus vite que l'eau tiède – ce fait étrange est connu sous le nom d'effet Mpemba. On a maintenant trouvé quelque chose de similaire dans le monde quantique : un état avec une intrication faible (un lien quantique particulier entre particules) peut surpasser un état plus intriqué sur le chemin vers le but.
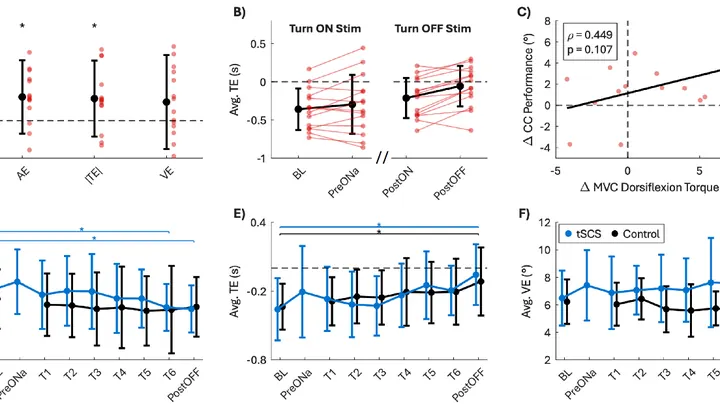
Si on applique une légère décharge électrique dans le dos, la jambe semble prendre vie par elle-même. C'est ce qu'ont découvert les chercheurs en testant l'effet de la stimulation électrique transcutanée de la moelle épinière sur des personnes en bonne santé.
Garder en tête la position exacte d'un stylo qu'on déplace lentement est une tâche banale pour le cerveau. Pour les réseaux de neurones artificiels, c'est presque impossible. Les réseaux récurrents classiques, comme GRU et LSTM, ont tendance à découper le mouvement continu en paliers rigides : le stylo ne glisse pas de façon fluide, il saute d'un point à un autre.
Un neurone reçoit des milliers de signaux sur ses prolongements ramifiés — les dendrites. Certains signaux poussent la cellule à s'activer (excitation), d'autres la retiennent (inhibition). Pendant longtemps, on a pensé que le neurone se contentait d'additionner tous les « pour » et les « contre ».
Une visite guidée avec un seul robot, c'est un monologue fatigant où l'on n'a personne avec qui échanger un regard. Les chercheurs ont transformé ce one-man-show en une scène vivante : au robot-guide réel s'est ajoutée une hologramme-partenaire.
Deux jardiniers marchandent l'eau d'un puits magique. L'un propose combien de seaux prendre, l'autre peut accepter ou refuser. Si l'accord est conclu, l'eau diminue ; sinon, le puits se remplit progressivement. Ce marchandage se répète des centaines de fois, et les habitudes des jardiniers changent parfois aléatoirement, comme s'ils testaient de nouvelles tactiques.
Il suffit que la caméra d'un robot tressaute pour qu'il fasse tomber une pièce : son réseau de neurones est déstabilisé. Mais si l'on observe ses signaux, ils ressemblent à des constellations dans la galaxie : quand tout se passe bien, ils se regroupent dans un secteur, et juste avant une erreur, ils basculent brusquement dans un autre.
Le robot jongleur attrape et lance des balles en parfaite cadence avec l'humain, tels deux pulsars émettant leurs impulsions à l'unisson. Jongler avec trois balles, c'est le classique «cascade», un enchaînement régi par une pulsation régulière, semblable à la rotation d'un phare cosmique. Que l'on casse le rythme, et le motif s'effondre.
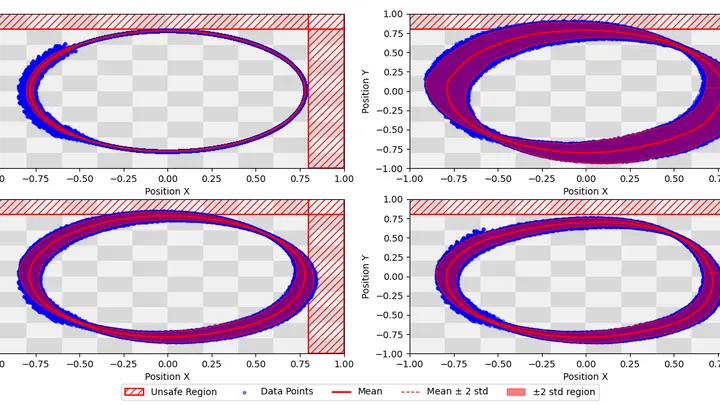
Quand un drone apprend d'un pilote expérimenté, il ne mémorise pas seulement des manœuvres, mais des couloirs de sécurité entiers. Mais en vol réel, il y a toujours des facteurs absents de l'entraînement : un vent inattendu, des vibrations de la caméra, même le mouvement propre du drone peut déstabiliser l'air.
En eau calme, la trajectoire est claire. Mais dans les courants turbulents, le robot a besoin d'une autre stratégie. Les approches habituelles exigent une carte précise des courants, mais en réalité, on ne peut pas l'obtenir. La nature procède autrement : les poissons sentent la pression et les tourbillons directement contre leur corps.
Communiquer avec des neurones vivants rappelle le réglage d'une vieille radio : il faut non seulement capter la bonne fréquence, mais aussi orienter l'antenne.
En général, les algorithmes apprennent à agir dans des conditions prédéfinies, comme l'eau qui coule dans un lit déjà creusé. La nouvelle méthode renverse cette logique : elle permet au système d'apprendre à la fois à agir et à modifier son environnement.
La préparation d'un plat complexe exige une recette claire : d'abord couper, puis faire revenir, ajouter les épices au bon moment. Les transformations chimiques suivent aussi des recettes pas à pas — des mécanismes où les atomes de carbone et d'hydrogène se réarrangent strictement dans l'ordre.
Les systèmes électriques équipés de panneaux solaires et d'éoliennes ressemblent à une partie d'échecs : la couverture nuageuse et les variations de charge sont des coups de l'adversaire impossibles à prévoir. Pour maintenir l'équilibre, les opérateurs devaient auparavant évaluer des dizaines de scénarios (incertitude) — ce qui demandait trop de temps et de calculs.
Un essaim de robots ressemble à une nuée de lucioles : chacun se déplace au hasard « là où c'est plus libre », et le chaos se transforme en ordre. Pendant longtemps, on s'est demandé comment, sans communication ni commandes, naissait cette coordination.
Imaginez un conducteur sur une route verglacée : il ne connaît pas la réaction exacte de sa voiture aux mouvements du volant et doit apprendre en conduisant, en gardant intuitivement une marge de manœuvre pour une éventuelle erreur. C'est ainsi que fonctionne un algorithme de contrôle adaptatif.
Quand vous tapez « salade » et que le clavier propose « césar », en coulisses, des millions de téléphones apprennent ensemble à prédire les mots. Ils n'échangent pas vos messages, mais seulement les améliorations de l'algorithme commun — comme un entraîneur qui envoie aux athlètes uniquement les changements au programme : « ajoutez 5 pompes à ceux d'hier ».
Une meute de loups passe en une seconde de la poursuite de sa proie à la défense de sa tanière. Cette même polyvalence, des ingénieurs l'ont intégrée dans un algorithme pour un essaim de robots.
La caténaire d'un chemin de fer évoque une galaxie : l'énergie s'y propage comme la gravitation, et les trains deviennent des exoplanètes. Plus les convois consomment du courant en même temps, plus les fluctuations de tension s'amplifient — des ondes gravitationnelles parcourent le système, menaçant de provoquer des coupures.
Une flotte de nombreux vaisseaux, telle une galaxie d'étoiles, accomplit une mission commune. Parfois, un vaisseau explose comme une supernova. Si on ne le remplace pas à temps, la flotte s'affaiblit. Mais le problème, c'est qu'on ne voit pas quel vaisseau tombera en panne ensuite — les défaillances sont invisibles, comme la matière noire.
Les machines complexes — des drones aux robots chirurgiens — se comportent parfois comme un mustang sauvage : pleines de désordre et de caprices, où un léger contact déclenche une tempête. Plutôt que de mémoriser des formules, la nouvelle méthode observe le système, tel un dresseur.
Quand un verre d'eau est plein, continuer à verser est un gaspillage inutile. Les jeux en streaming font souvent la même chose avec les données vidéo : l'encodeur pousse le flux au maximum, alors que l'œil cesse de remarquer les améliorations bien avant la limite.
Un coureur perd sur un stade lisse comme sur du sable mou. Aucune chance, semble-t-il. Mais si la piste sous ses pieds change toutes les quelques secondes — tantôt le stade, tantôt le sable — le coureur cesse soudain de prendre du retard. Il ne devient pas plus rapide ; simplement, le milieu n'a pas le temps d'« achever » sa faiblesse.
Au cours du développement embryonnaire, la cellule ressemble à un musicien dans un immense orchestre : elle doit jouer sa partition en suivant le chef d'orchestre — le gradient de molécules signal. Mais le chef est peu fiable : la concentration des morphogènes fluctue constamment.
Les systèmes de recommandation qui décident quel message vous verrez ensuite fonctionnent sur des réseaux de neurones profonds composés de milliers d'opérations — des graphes de calcul complexes (des schémas d'opérations sur les données).
Une infime poussière dans une solution sursaturée se couvre en quelques secondes de facettes de cristal. Les particules voisines restent invisibles. Un processus similaire a récemment été découvert dans les communautés d'grands modèles de langage.
Le cerveau n'apprend pas chaque tâche à partir de zéro : il transfère l'expérience d'une activité à une autre. Mais comment savoir quelles tâches sont réellement apparentées ? Les neuroscientifiques ont eu une idée astucieuse : laisser un réseau artificiel « observer » l'activité cérébrale pendant une tâche, puis tenter de prédire l'activité pendant une autre.
Nous avons l'habitude de penser que ne remarquer que les confirmations de nos intuitions est une erreur. Mais des calculs récents, inspirés par le comportement des vagues, renversent ce point de vue. Il s'avère que l'habitude de chercher ce qui est familier est le meilleur moyen de réduire le bruit informationnel (les scientifiques l'appellent entropie).
Une personne tend la main à un inconnu à l'autre bout de la ville. Celui-ci ne lui rendra jamais la pareille — ils ne se reverront pas. Pourquoi alors aider ? Les biologistes appellent cela la réciprocité indirecte : le bien ne revient pas de celui qu'on a aidé, mais de quelqu'un d'autre — par une chaîne.
Dans cette nouvelle étude, deux variantes de cette réciprocité s'affrontent.
Dans l'élément aquatique, une mécanique est déstabilisée par les tourbillons. L'agent d'IA, tel un cuisinier expérimentateur, lançait des simulations, testait des « recettes » de mouvements et améliorait le programme.
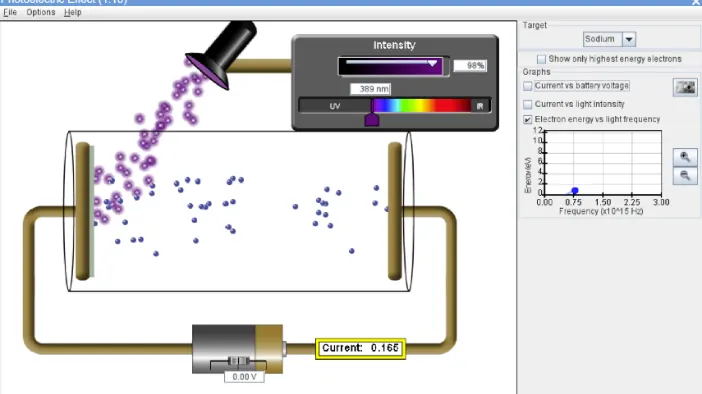
Comprendre l'effet photoélectrique — lorsque la lumière arrache des électrons à un matériau — c'est un peu comme apprendre à cuisiner sans recette. Les outils numériques viennent à la rescousse : les jeux donnent l'intuition, les simulations apportent la précision.
Un caissier de supermarché à l'heure de pointe ne mémorise pas chaque article scanné — il garde en tête le total et surveille la file d'attente. C'est à peu près ainsi que le cerveau répartit ses forces : le cortex, coûteux et précis (ce qui est responsable de la réflexion), et les noyaux sous-corticaux, plus simples et économes (où vivent les habitudes), travaillent en binôme.
Un photographe prend en photo une forêt de nuit et tente de capturer des lucioles. Les flashs sont rares, faibles, et autour, il y a le bruit du vent et des lumières lointaines.