Une forêt aléatoire est une méthode d'apprentissage automatique qui construit une « forêt » de nombreux arbres de décision et combine leurs prédictions. Chaque arbre est entraîné sur un sous-ensemble aléatoire des données et considère un sous-ensemble aléatoire de caractéristiques à chaque division, ce qui rend les arbres différents les uns des autres. La prédiction finale est la moyenne (pour la régression) ou le vote majoritaire (pour la classification) de tous les arbres. Cette approche d'ensemble réduit le risque de surapprentissage dont souffre souvent un arbre de décision unique, rendant le modèle robuste et précis sur de nouvelles données.
Histoire
Introduite par Leo Breiman en 2001, en s'appuyant sur des travaux antérieurs sur l'agrégation bootstrap et les méthodes de sous-espaces aléatoires.
Comment ça marche
La méthode crée de nombreux arbres de décision, chacun entraîné sur un échantillon bootstrap (échantillon aléatoire avec remise) des données originales. À chaque nœud d'un arbre, seul un sous-ensemble aléatoire de caractéristiques est considéré pour la meilleure division, et non toutes les caractéristiques. Cela décorrèle les arbres—ils commettent des erreurs différentes. Lors de la prédiction, chaque arbre donne sa sortie, et la forêt les agrège. Le caractère aléatoire garantit qu'aucun arbre ne domine, et la moyenne lisse le bruit individuel des arbres.
En pratique
Utilisée en finance pour le scoring de crédit, en bioinformatique pour la sélection de gènes, et en télédétection pour la classification de l'occupation des sols.
Anecdote
Les forêts aléatoires peuvent estimer quelles caractéristiques sont les plus importantes pour la prédiction sans calcul supplémentaire, en mesurant combien chaque caractéristique réduit l'impureté à travers tous les arbres.
Imaginez une volée d'oiseaux qui se rassemble autour d'une mangeoire que personne n'a construite. Chaque oiseau cherche sa nourriture pour lui-même, mais au final, ils se retrouvent ensemble. D'habitude, on explique ce comportement par un instinct social : les oiseaux veulent être près de leurs congénères. Mais et si la nuée n'était qu'un effet secondaire de la cupidité ?
La recherche d'un nouveau matériau ressemble à la cuisine sans recette : on essaie, on essaie, et souvent on jette. Avant, les scientifiques feuilletaient les articles à la main et testaient les compositions une par une. Maintenant, un « robot-cuisinier » est apparu, qui lit lui-même la littérature, mélange les composants et regarde ce que ça donne.
Un poisson solitaire voit une ombre au-dessus de sa tête. Fuir ? Si ce n'est qu'une feuille, il aura gaspillé son énergie et se sera révélé à un prédateur. Si c'est un héron, l'hésitation est mortelle. C'est le compromis éternel de l'individu isolé : réagir vite signifie beaucoup de fausses alertes, être prudent signifie risquer de se faire dévorer.
Dans un banc, c'est différent.
Dans une grande communauté, les espèces rares ressemblent à de fines branches d'arbre : un coup de vent aléatoire suffit à les briser. Même si les conditions sont stables, une population peu nombreuse n'a tout simplement pas assez d'individus pour survivre à une mauvaise saison.
Deux cellules filles reçoivent chacune la moitié de la mère – c'est l'image habituelle de la division. Mais que se passerait-il si l'une d'elles recevait presque tout, et l'autre des miettes ? La modélisation stochastique montre que parfois, un partage inégal est plus avantageux.
Chaque cellule stocke une réserve protectrice qui l'aide à surmonter les difficultés.
Un ordinateur quantique ressemble à un orchestre où chaque musicien — un qubit — joue sa partition, mais se trompe de temps en temps. Pour éviter que la musique ne devienne une cacophonie, il faut un chef qui entend instantanément les fausses notes et les corrige.
Dans une casserole d'eau flottent des billes microscopiques — des particules colloïdales. Chaque bille est recouverte de longs filaments polymères, semblables à une brosse, et porte une charge électrique. Si l'on choisit correctement la température et la composition de la solution, les billes commencent d'elles-mêmes à s'organiser en motifs ordonnés — des cristaux.
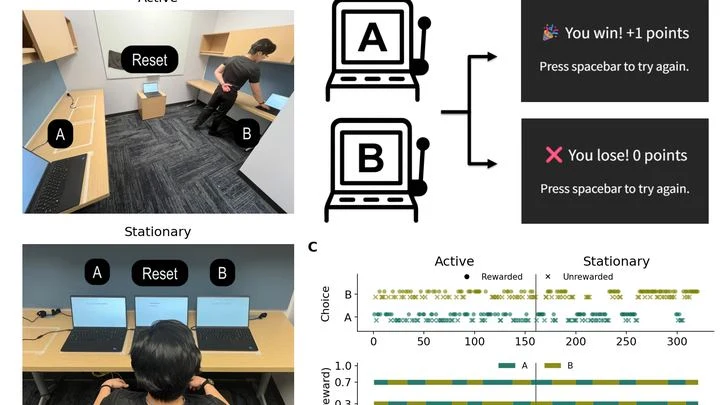
On lance une pièce pour prendre une décision. On reste immobile — la pièce tombe sur pile. On fait quelques pas — et on relance. On pourrait penser que la marche n'influence pas la pièce. Mais que se passerait-il si la promenade elle-même modifiait la fréquence à laquelle on décide de simplement répéter le lancer précédent ?
C'est exactement ce que les chercheurs ont testé.
Garder en tête la position exacte d'un stylo qu'on déplace lentement est une tâche banale pour le cerveau. Pour les réseaux de neurones artificiels, c'est presque impossible. Les réseaux récurrents classiques, comme GRU et LSTM, ont tendance à découper le mouvement continu en paliers rigides : le stylo ne glisse pas de façon fluide, il saute d'un point à un autre.
Un réseau où les lions mangent les zèbres et où les hyènes finissent les restes, ce n'est pas qu'une liste de repas. C'est une carte de survie pour toute une région. Quand le climat change, les animaux se déplacent et la carte se déchire. Pour comprendre où elle se déchirera et où elle tiendra, il faut trouver son « squelette » immuable – ces connexions qui se répètent d'un endroit à l'autre.
L'esprit humain ressemble à un jeu de construction qui s'auto-construit. Les nouvelles idées ne meurent pas avec leur créateur : elles se transmettent, se mélangent et sont sélectionnées. Ce processus est appelé évolution culturelle : les inventions utiles se consolident, les inutiles tombent dans l'oubli. C'est le principe du cliquet, ce mécanisme qui ne tourne que dans un sens.
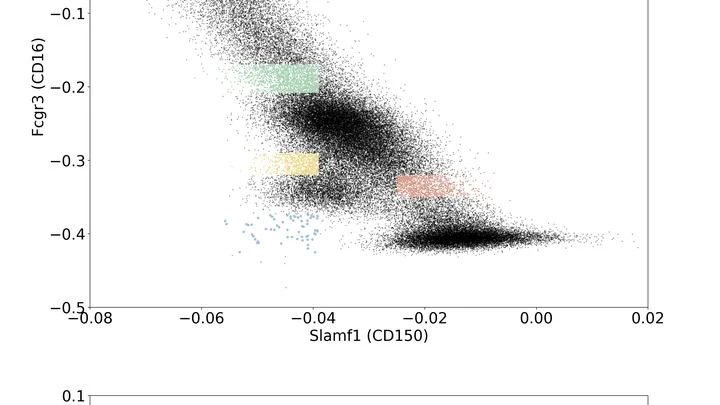
Deux cent quarante-deux mille trois cent vingt-sept galaxies — comme des grains de sable sur une plage. Mais les astronomes ont transformé ce chaos en carte : l'algorithme UMAP a pris de chaque galaxie onze paramètres — sept couleurs de l'optique au moyen infrarouge (c'est la…
Une protéine glisse le long du brin d'ADN comme une clé sur un trousseau, cherchant sa serrure. Un mauvais tournant, et le gène reste éteint. Pour savoir où la protéine s'agrippera solidement, il faut mesurer la force de cette prise, c'est-à-dire l'énergie de liaison.
En plein combat, un pilote doit comprendre instantanément ce qu'est un objet et quelles sont ses intentions. Les systèmes conventionnels attendent des données radar complètes – c'est comme un gardien qui ne réagit qu'après le tir. Le nouvel algorithme, lui, agit comme un gardien chevronné : dès les premiers mouvements de l'attaquant, il anticipe la manœuvre de la cible.
Le livre de recettes se réécrit de génération en génération, mais un jour, la recette du bortsch reçoit un ingrédient secret d'un pâtissier. Dès lors, le goût ne se souvient plus seulement des ancêtres, mais aussi du voisin. Dans le modèle standard de l'évolution, les gènes se comportent de la même manière.
Deux jardiniers marchandent l'eau d'un puits magique. L'un propose combien de seaux prendre, l'autre peut accepter ou refuser. Si l'accord est conclu, l'eau diminue ; sinon, le puits se remplit progressivement. Ce marchandage se répète des centaines de fois, et les habitudes des jardiniers changent parfois aléatoirement, comme s'ils testaient de nouvelles tactiques.
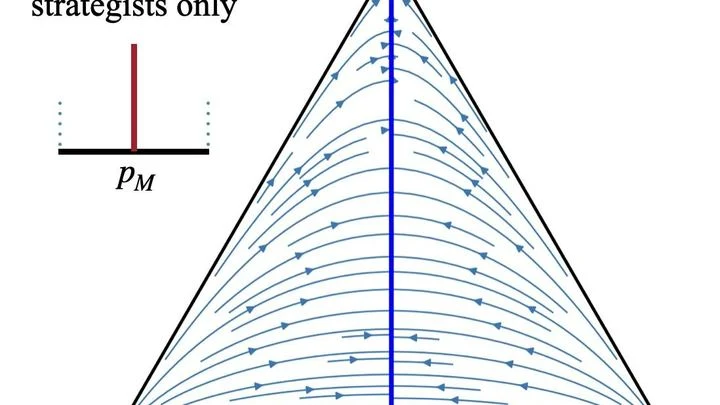
Longtemps, les biologistes se sont demandé : si un groupe d'animaux maintient stablement un mélange d'individus agressifs et pacifiques, chaque individu alterne-t-il son comportement, ou certains se battent-ils toujours tandis que d'autres cèdent toujours ? Dans les équations classiques, ces deux scénarios sont indistinguables.
L'intelligence artificielle qui prédit l'acoustique d'une salle fait penser à un étudiant qui triche à l'examen avec une antisèche. Si les points de validation sont les mêmes que ceux de l'entraînement, le modèle se contente de mémoriser l'« empreinte » sonore de chaque position, comme un étudiant qui reconnaît un sujet grâce à un coin de page plié.
Dans une soupe bouillonnante, les molécules entrent en collision de manière chaotique et réagissent. Mais si l'on mesure comment leurs concentrations varient, des régularités apparaissent.
En général, les algorithmes apprennent à agir dans des conditions prédéfinies, comme l'eau qui coule dans un lit déjà creusé. La nouvelle méthode renverse cette logique : elle permet au système d'apprendre à la fois à agir et à modifier son environnement.
Un essaim de robots ressemble à une nuée de lucioles : chacun se déplace au hasard « là où c'est plus libre », et le chaos se transforme en ordre. Pendant longtemps, on s'est demandé comment, sans communication ni commandes, naissait cette coordination.
L'évolution ne ressemble pas seulement à un arbre aux branches divergentes, mais à une toile tissée. Les fils des lignées se croisent lorsque les espèces échangent des gènes — par exemple, les bactéries se transmettent des résistances aux médicaments, et les plantes s'hybrident.
L'arbre généalogique se transforme en écheveau si l'on tient compte des enfants adoptés et des remariages. L'évolution ressemble souvent à un tel écheveau : bien que le modèle standard dessine un arbre des espèces bien propre, en réalité les gènes voyagent non seulement par héritage, mais aussi directement entre organismes non apparentés.
Un désert où chaque pas modifie le relief. Les dunes s'affaissent, de nouvelles pentes apparaissent — et le pas suivant est dicté par ce que vous venez de tracer. C'est à peu près ainsi que fonctionnent les « paysages de sable » (sandscapes) — un modèle mathématique inspiré des systèmes vivants.
Le microlentillage gravitationnel est un effet cosmique fascinant, prédit par Einstein et développé par Zwicky. Un corps massif, passant entre nous et une étoile lointaine, courbe sa lumière comme une lentille, créant des amplifications et distorsions caractéristiques.
Un coureur perd sur un stade lisse comme sur du sable mou. Aucune chance, semble-t-il. Mais si la piste sous ses pieds change toutes les quelques secondes — tantôt le stade, tantôt le sable — le coureur cesse soudain de prendre du retard. Il ne devient pas plus rapide ; simplement, le milieu n'a pas le temps d'« achever » sa faiblesse.
Sur une station météo du comté de Brazos, au Texas, la pluie est enregistrée sur une bande magnétique — chaque jour, pendant quatre ans d'affilée. Neuf cents millimètres les bonnes saisons, cent les mauvaises. Puis la bande se tait. La sécheresse s'installe en silence — c'est l'extinction lente du pouls de la terre.
60 souris, 1980 échantillons, 234 patients atteints d'un cancer du poumon. Derrière chaque chiffre se cachent des milliers de gènes. Leur activité est mesurée pour comprendre la maladie.
Le système immunitaire ressemble à un éditeur infatigable qui corrige le brouillon des anticorps, les rendant de plus en plus accrocheurs aux virus et aux bactéries.
Vue de l'extérieur, la croissance d'une population ressemble à un train qui prend de la vitesse : d'abord il avance péniblement, puis il accélère. Mais dès qu'on plonge dans les données, l'image se brouille. Dans une mesure, on compte une dizaine d'individus ; dans une autre, une centaine d'un coup.
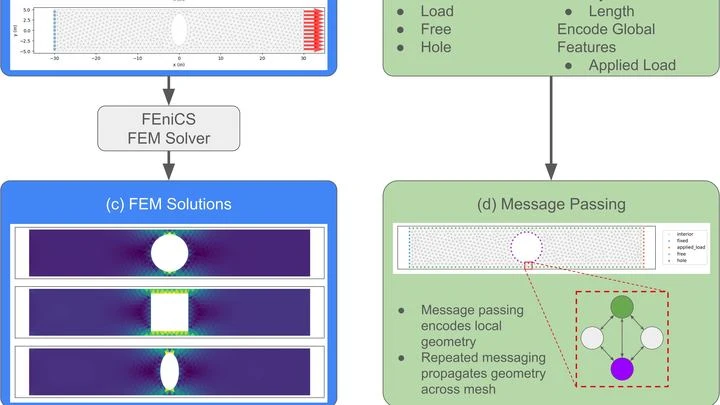
Concevoir des machines, c'est un peu comme faire de la pâtisserie : il faut savoir exactement où la pâte va se déchirer. Les anciens calculs informatiques vérifient chaque point de la pièce pendant des heures — comme si on mesurait toute la casserole pour être sûr que l'anse ne se détache pas.
Une bouilloire qui bout avec son couvercle fermé ne montre pas l'ébullition, mais le son et les vibrations trahissent la puissance de chauffe de l'eau.
Vous goûtez un plat au restaurant, mais vous n'avez pas vu le menu. Vous posez des questions au serveur — trop salé ? avec quelles épices ? — et à partir des réponses, vous essayez de deviner quel chef l'a préparé.
Après une partie de Scrabble, le plateau ressemble à une mosaïque : les lettres sont éparpillées mais forment un motif connecté — des îlots de mots au milieu d'une mer de cases vides. Un tel motif peut être décrit mathématiquement, mais cela nécessite généralement des règles complexes.
Étudier la naissance des galaxies nécessite de simuler des milliards d'années de croissance de la matière noire et de formation d'étoiles — même les superordinateurs s'y attellent lentement.
Les terres arides ressemblent à une peau qui se craquelle par déshydratation. Lorsque les pluies se raréfient, les plantes ne disparaissent pas immédiatement : elles se réorganisent, laissant entre elles des zones de sol nu. Ces motifs sont visibles même depuis l'espace.
Le noyau d'uranium ressemble à un portefeuille bien rempli, fermé par deux moitiés qui s'emboîtent. Pour qu'il éclate et libère de l'énergie — c'est-à-dire pour que le noyau se divise — il faut franchir une barrière d'énergie. La hauteur de ce seuil détermine si la matière est stable ou prête à se désintégrer à tout moment.
Les ingénieurs qui améliorent les réseaux de neurones agissent comme des sélectionneurs : ils essaient une variante, observent le résultat, conservent la meilleure. Ils ont rassemblé 935 de ces essais issus de 161 articles et mesuré à quelle fréquence une modification de code s'avère bénéfique, nuisible ou sans effet.
Un paysage découpé par des routes ou des rivières en morceaux isolés évoque un appartement communautaire après l'installation de cloisons : les habitants cessent de se croiser dans le couloir commun. Les espèces qui auparavant se disputaient la même nourriture ou le même territoire vivent désormais séparément.
Un modèle d'apprentissage automatique classique examine un objet à la fois : un cerveau, un patient, un moteur. Mais les biologistes cherchent le général : comment le cerveau d'une espèce est organisé, et pas seulement celui d'un poisson particulier.