La carte des maladies : comment relier les gènes et les affections express
À l'intérieur de chaque cellule, le travail ne s'arrête jamais : les protéines communiquent, les gènes s'activent et se désactivent, et les dysfonctionnements de ce système mènent à des maladies. Pour trouver le coupable d'une affection, les scientifiques devaient auparavant éplucher manuellement les articles scientifiques et les bases de données, comme un détective qui interroge les témoins un par un. Mais les connexions sont si nombreuses qu'on ne peut pas y arriver seul.
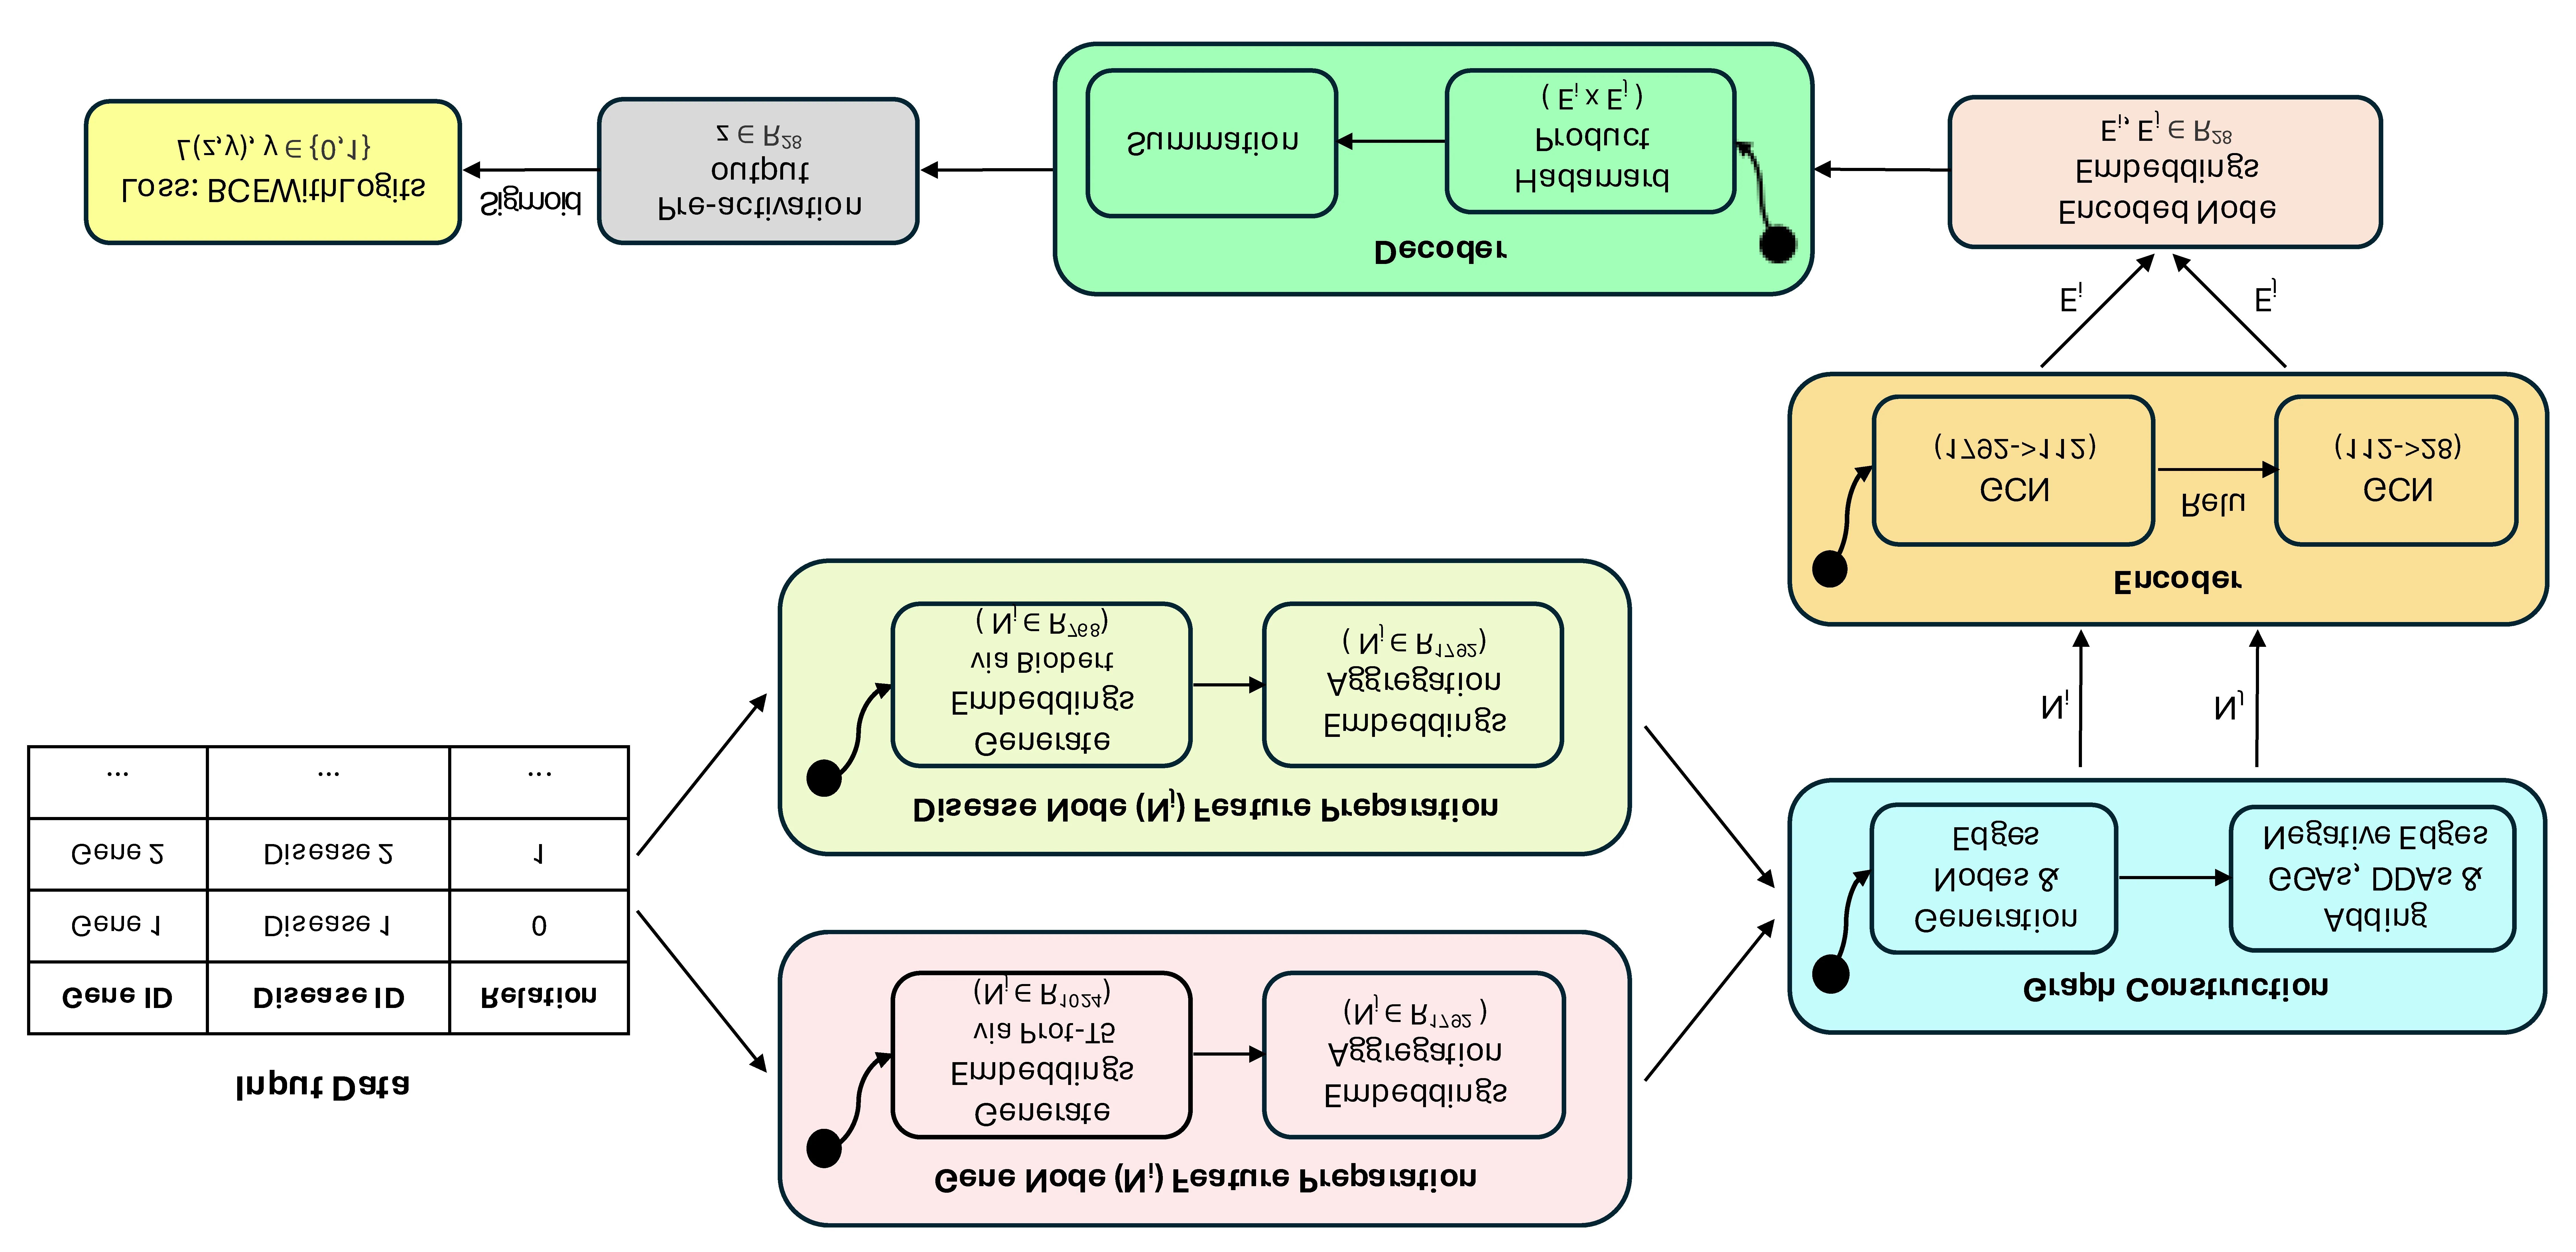
Le nouveau modèle GLaDiGAtor fonctionne comme un graphe intelligent : il construit une carte où les points représentent les gènes et les maladies, et les lignes entre eux, les interactions connues. Ensuite, il apprend de cette carte, comme à partir d'exemples, et prédit où devraient se trouver les lignes manquantes. La carte intègre également des indices textuels : les descriptions des maladies et les séquences de protéines, que le modèle lit comme des annotations sur les points. Grâce à cela, il voit non seulement les connexions directes, mais aussi les schémas cachés.
Cette approche accélère la recherche de gènes cibles pour les médicaments. Au lieu de mois de travail manuel, quelques heures de calcul suffisent. Et plus les données sont ajoutées à la carte, plus les prédictions deviennent précises. Peut-être qu'un jour nous pourrons voir à l'avance quel gène va défaillir dans telle ou telle maladie, et préparer un traitement avant l'apparition des symptômes.
Résumé original
tel que rédigé par les auteurs, en anglais arXiv:2602.18769
Understanding disease-gene associations is essential for unravelling disease mechanisms and advancing diagnostics and therapeutics. Traditional approaches based on manual curation and literature review are labour-intensive and not scalable, prompting the use of machine learning on large biomedical data. In particular, graph neural networks (GNNs) have shown promise for modelling complex biological relationships. To address limitations in existing models, we propose GLaDiGAtor (Graph Learning-bAsed DIsease-Gene AssociaTiOn pRediction), a novel GNN framework with an encoder-decoder architecture for disease-gene association prediction. GLaDiGAtor constructs a heterogeneous biological graph integrating gene-gene, disease-disease, and gene-disease interactions from curated databases, and enriches each node with contextual features from well-known language models (ProtT5 for protein sequences and BioBERT for disease text). In evaluations, our model achieves superior predictive accuracy and generalisation, outperforming 14 existing methods. Literature-supported case studies confirm the biological relevance of high-confidence novel predictions, highlighting GLaDiGAtor's potential to discover candidate disease genes. These results underscore the power of graph convolutional networks in biomedical informatics and may ultimately facilitate drug discovery by revealing new gene-disease links. The source code and processed datasets are publicly available at https://github.com/HUBioDataLab/GLaDiGAtor.
Le modèle utilise deux langages : l'un « lit » les séquences de protéines, l'autre les textes médicaux, et les combine en une carte unique.