Deux yeux valent mieux qu'un : quand le réseau de neurones apprend à voir la tumeur express
Le médecin scrute l'image du cerveau : quelque part dans l'enchevêtrement des tissus se cache une tumeur. Un regard saisit les petites taches et les contours, l'autre la forme générale et l'emplacement. L'humain combine les deux, mais sur des centaines d'images, c'est épuisant. Le nouveau programme fait la même chose automatiquement.
Une partie fonctionne comme une loupe : elle glisse sur l'image et collecte les petits détails — texture, bords, changements locaux. L'autre regarde de loin, comme d'en haut, et relie des zones éloignées : où se trouve la tumeur par rapport aux ventricules, comment elle s'inscrit dans l'ensemble. Avant, on combinait ces regards grossièrement — on mélangeait simplement les résultats. Maintenant, on a ajouté une « salle de négociation » : un bloc spécial décide combien prendre de chaque regard pour une image donnée et une zone donnée.
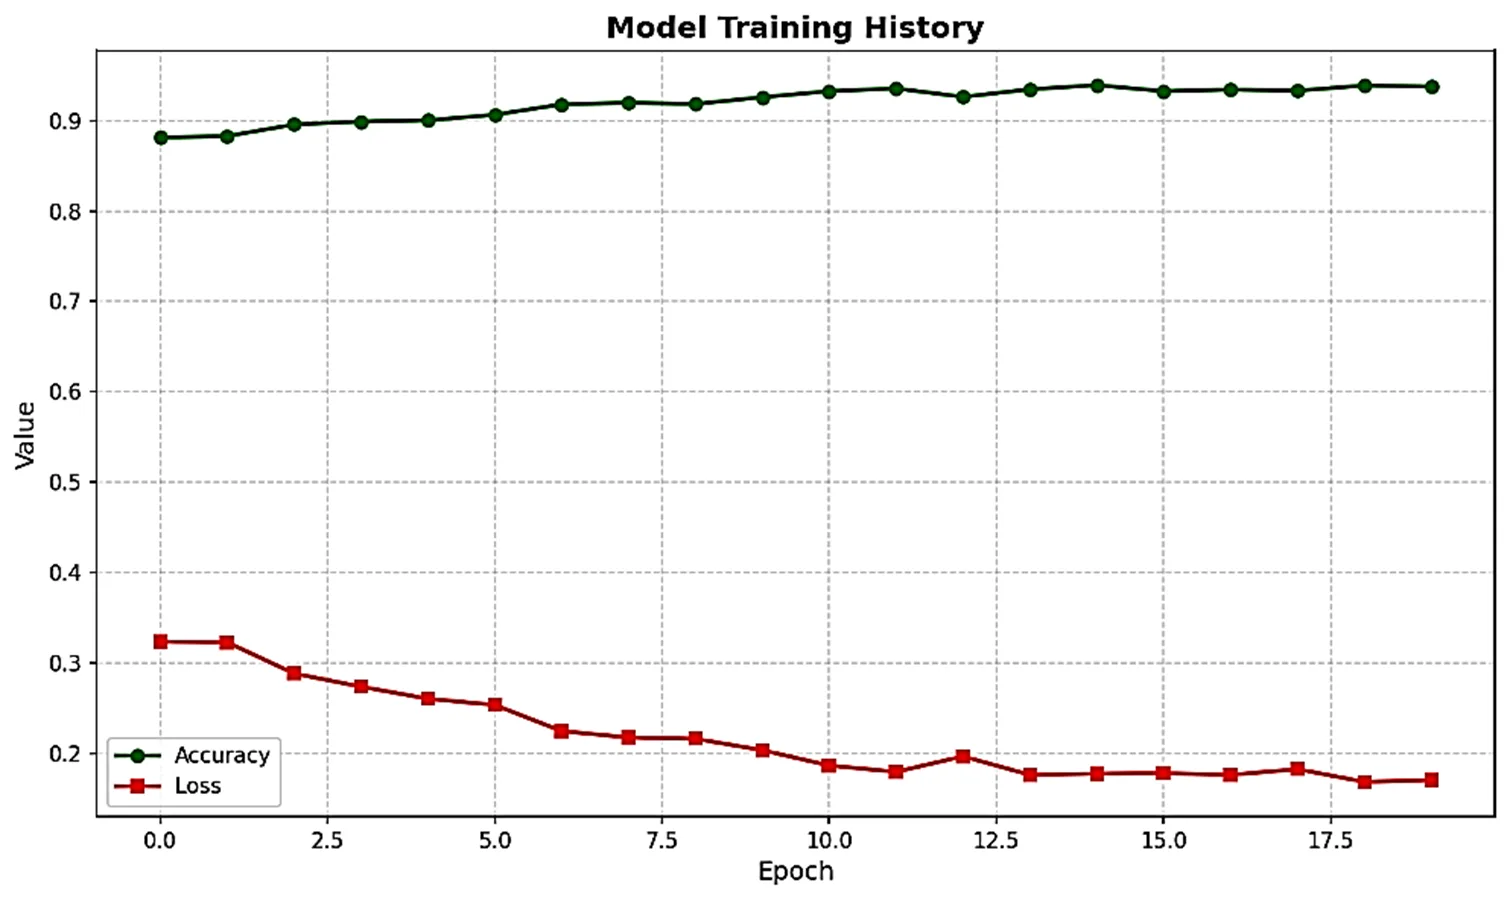
Le modèle a été entraîné sur un ensemble d'images avec et sans tumeur. Il a correctement identifié la tumeur dans 97,6 % des cas — c'est plus que chacune des parties séparément et que les méthodes de fusion précédentes. La précision, le rappel et la mesure globale de qualité — tout a augmenté. Cela signifie qu'une pondération flexible des deux regards aide à voir la maladie plus clairement.
Cette approche pourrait servir non seulement pour les tumeurs cérébrales : toute image médicale où comptent à la fois les petits détails et la vue d'ensemble bénéficierait de « deux yeux avec un chef d'orchestre ».
Résumé original
tel que rédigé par les auteurs, en anglais arXiv:2604.23137
Early detection and classifying brain tumors using Magnetic Resonance Imaging (MRI) images is highly important but difficult to extract in medical images. Convolutional Neural Networks (CNNs) are good at capturing both local texture and spatial information whereas Vision Transformers (ViTs) are good at capturing long-range global dependencies. We propose a new hybrid architecture that combines a SqueezeNet-style CNN branch with a MobileViT-style global transformer branch, through an Adaptive Attention Gate mechanism, in this paper. The gate learns dynamically per-sample, per-feature weights to weight the contribution of each branch, allowing context-sensitive merging of local and global representations. The proposed model has a test accuracy of 97.60, a precision of 97.30, a recall of 97.50, an F1-score of 97.40, and a macro-average area under the curve (AUC) of 0.9946 with a trained and evaluated on the Brain Tumor MRI Dataset (Kaggle). These scores are higher than single CNN and ViT baselines, and current competitive fusion methods, showing that dynamic feature weighting is an effective way to classify medical images.
L'indice AUC de 0,9946 signifie que si l'on prend une image aléatoire avec tumeur et une image aléatoire sans tumeur, le modèle attribuera presque toujours un score de « ressemblance à une tumeur » plus élevé à la première.