La vision par ordinateur repose sur les réseaux de neurones convolutifs (Convolutional Neural Networks, CNN). Leur architecture imite la structure du cortex visuel : les cellules simples réagissent aux lignes orientées selon un certain angle, les cellules complexes à leurs combinaisons. Une couche convolutive parcourt l’image avec une petite fenêtre, la multiplie avec un filtre et crée des cartes de caractéristiques. Plusieurs de ces couches assemblent successivement des représentations de plus en plus abstraites : des bords et textures jusqu’aux parties d’objets et aux visages entiers. Les systèmes modernes utilisent aussi des mécanismes d’attention et des transformers, en traitant l’image comme une séquence de patches.
Histoire
Le point de départ est le travail de Hubel et Wiesel (1959) sur l’organisation du cortex visuel, qui a inspiré les modèles hiérarchiques. En 1963, Larry Roberts a implémenté le programme « Blocks World », interprétant des photos de cubes. Dans les années 1970, les méthodes géométriques se sont activement développées. Dans les années 1990, les premiers détecteurs de contours efficaces sont apparus. Yann LeCun a proposé les réseaux convolutifs en 1989, en les appliquant à la reconnaissance de chiffres. La véritable révolution a eu lieu en 2012, lorsque Alex Krizhevsky et ses collègues ont publié AlexNet, utilisant des processeurs graphiques (GPU) : la précision sur ImageNet est passée d’environ 74 % à environ 84 %. Par la suite, les architectures sont devenues plus profondes : VGG, ResNet (2015), qui résolvait le problème de la disparition du gradient grâce aux connexions de saut. Depuis 2020, les Vision Transformers (Dosovitskiy et al.) ont transféré le mécanisme d’auto-attention aux images, et des modèles comme DALL·E 2 et Stable Diffusion ont appris à générer de nouvelles images à partir d’une description textuelle.
Comment ça marche
Le bloc de construction fondamental est la convolution : un noyau de taille k×k est multiplié élément par élément avec une région de l’image, et les résultats sont sommés. Une couche de pooling réduit la résolution en extrayant les informations principales. Les couches entièrement connectées prennent le vecteur de caractéristiques final et produisent une prédiction. L’apprentissage se fait par descente de gradient avec rétropropagation de l’erreur. Dans les systèmes modernes, on pré-entraîne souvent un grand modèle sur de vastes jeux de données (ImageNet-21k), puis on l’affine pour une tâche cible (transfer learning). Pour la génération d’images, on utilise des auto-encodeurs variationnels (VAE), des réseaux antagonistes génératifs (GAN) et, plus récemment, des modèles probabilistes de diffusion, qui éliminent progressivement le bruit d’un champ aléatoire initial jusqu’à obtenir une image nette.
En pratique
La voiture reconnaît les panneaux de signalisation et les piétons en temps réel pour freiner à temps ou avertir le conducteur.
Anecdote
Le système Google Translate peut traduire le texte sur une photo de menu en temps réel : vous pointez votre appareil photo sur un texte étranger, et à l’écran il apparaît déjà en français – tout cela grâce à la reconnaissance et à la compréhension de l’image.
Dans les années 1980, le concours DARPA de reconnaissance vocale a mis fin au débat entre les méthodes statistiques et les règles écrites à la main, établissant une norme unique pour tout le domaine.
Un radiologue regarde un scanner abdominal et voit non seulement des organes, mais aussi leur disposition mutuelle : quel rein est plus gros, où se trouve la tumeur par rapport au vaisseau. C'est comme lire une carte : il ne suffit pas de savoir où se trouve habituellement une ville, il faut aussi savoir mesurer la distance entre deux points sur le terrain.
Se perdre dans une salle des glaces est un jeu d'enfant : chaque mur reflète l'autre, et l'on croit être déjà passé par là. C'est à peu près ce qui se passe dans le cerveau lorsqu'il y a beaucoup d'endroits similaires autour de soi. Les neurones chargés de la carte spatiale peuvent envoyer le même signal pour deux coins différents d'une pièce.
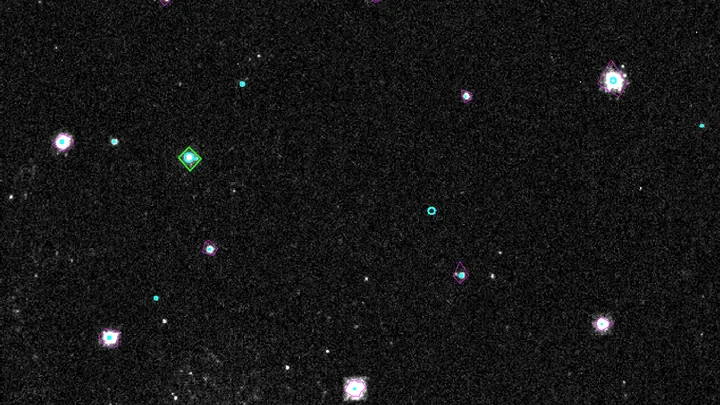
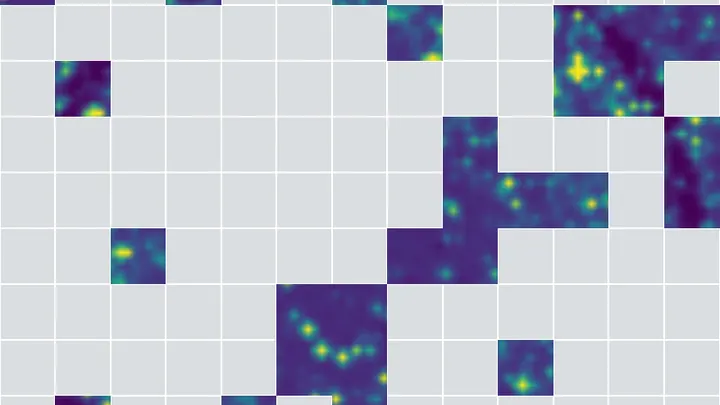
Vous cherchez des lucioles dans une forêt sombre. Au lieu de photographier toute la forêt chaque seconde et d'examiner ensuite les images, vous portez un petit appareil qui repère lui-même les éclairs et découpe dans l'image seulement un cercle autour de chacun. Le reste – l'obscurité – n'est pas enregistré. C'est exactement ce que fait le nouveau capteur pour caméras scientifiques.
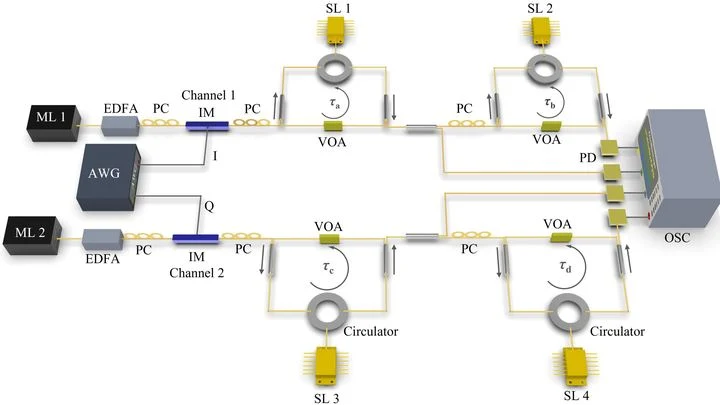
Dans la fibre optique, les données voyagent à la vitesse de la lumière, mais la route n'est pas idéale : le signal se brouille, comme une voix dans un long couloir. Plus la vitesse est élevée et la distance grande, plus les distorsions sont fortes. Habituellement, on les corrige avec de l'électronique, mais celle-ci ne suit pas le rythme de la lumière.
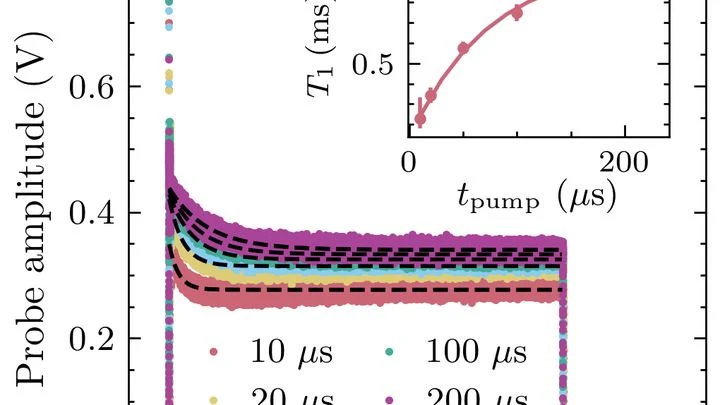
Un faisceau lumineux entre dans une cuve en verre contenant de la vapeur de césium et modifie l'état interne des atomes : c'est ainsi que l'information est enregistrée. Un instant plus tard, un autre faisceau la lit en observant comment les atomes absorbent la lumière. Ce n'est pas un disque dur, mais plutôt un carnet qui tourne les pages tout seul.
La caméra d'un smartphone capte la lumière avec de minuscules capteurs, mais ceux-ci ne distinguent pas les couleurs par eux-mêmes. C'est pourquoi on place devant eux des filtres colorés : rouge, vert, bleu — comme des vitraux dans une fenêtre. Chaque capteur ne voit que sa couleur, puis un logiciel assemble ces fragments pour former une image complète.
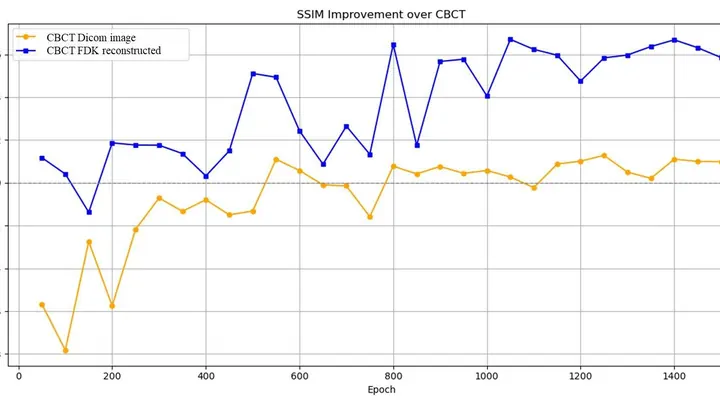
Une image obtenue avec une faible dose de rayons X ressemble à une vue à travers une vitre embuée : les contours sont là, mais les détails se noient dans un voile trouble. Les médecins ont besoin de ces clichés pendant la radiothérapie – pour viser précisément la tumeur et épargner les tissus sains.
Prédire le rendement d'une réaction chimique, c'est un peu comme essayer de deviner la récolte en ne connaissant que la composition du sol. Traditionnellement, les chimistes s'appuyaient sur de longues colonnes de nombres – les descripteurs quantiques – qui décrivent l'énergie des électrons mais restent muets sur la forme de la molécule.
Prédire le rendement d'une réaction chimique, c'est un peu comme essayer de deviner la récolte en ne connaissant que la composition du sol. Traditionnellement, les chimistes s'appuyaient sur de longues colonnes de nombres – les descripteurs quantiques – qui décrivent l'énergie des électrons mais restent muets sur la forme de la molécule.
Dans la galaxie spirale du Feu d'artifice, il y a 6410 pouponnières d'étoiles. C'est le nombre de régions où naissent actuellement des étoiles massives, révélé par un algorithme appliqué aux anciennes images ultraviolettes de Hubble.
Chaque matin, des dizaines de télescopes se braquent sur le Soleil. Leurs caméras capturent une fine bande de lumière rouge : la raie Hα, découverte par Johann Jakob Balmer. Sur les images, des filaments sombres et capricieusement incurvés apparaissent.
Une prothèse oculaire transmet au cerveau non pas une photographie, mais un pointillé clairsemé de points lumineux — les phosphènes. Pour distinguer une tasse ou des clés dans ce scintillement, la personne doit balayer la tête comme une lampe de poche dans l'obscurité et assembler petit à petit les contours de l'objet.
En assemblant le puzzle de l'Univers, les astronomes ont l'habitude que chaque nouvelle pièce s'emboîte parfaitement dans le tableau déjà constitué. Mais parfois, ils tombent sur des morceaux qui semblent découpés dans un autre jeu. Vingt mille noyau actif de galaxie — et onze pour cent d'entre eux, le réseau de neurones les rejette résolument comme étrangers.
Chaque fois qu'un enfant atteint de paralysie cérébrale s'apprête à bouger la jambe, une décharge électrique particulière se produit dans son cerveau — un lent déplacement de tension. Les scientifiques l'appellent un potentiel lié au mouvement.
Les caméras d'une voiture autonome captent la lumière, telles des télescopes pointés vers une lointaine galaxie. Chaque image est une observation fragmentaire ; ensemble, elles doivent former une carte du chemin.
Un radar ordinaire ne voit qu'un point. La nouvelle méthode transforme l'écho radio en une sculpture en volume : le signal dessine la forme, l'inclinaison et le mouvement.
Dans une scène tridimensionnelle, chaque point est comme un bonbon dont la couleur change selon l'angle de vue. Pour décrire ce jeu de nuances, on stocke pour chaque point des dizaines de nombres — une fonction mathématique spéciale, imaginée par Joseph Fourier. La mémoire se remplit en un instant.
Le cerveau d'un méditant, c'est un orchestre, et l'attention, son chef. Lorsque vous êtes concentré sur votre respiration, tous les instruments jouent en harmonie. Mais soudain, une pensée-violoncelle joue une fausse note : c'est la divagation de l'esprit.
Une IA classique regarde les images médicales comme des puzzles faits de pièces inconnues : elle considère que deux images non appariées sont complètement différentes. C'est comme essayer de distinguer des jumeaux sans connaître leur lien de parenté. Or, en médecine, les patients atteints d'une même maladie présentent des IRM presque identiques, et l'algorithme se trompe en confondant les « parents ».
La caméra à pixel unique évoque un artiste qui peint à travers un pochoir percé de nombreux trous. Chaque prise de vue ne laisse passer qu'une partie du flux lumineux, puis l'ordinateur assemble ces fragments pour reconstituer une image complète. Autrefois, l'ordre des masques était immuable, comme si l'artiste utilisait toujours le même pochoir sans jamais regarder son sujet.
De nombreux processus naturels sont décrits par des équations, mais nous n'en connaissons que des fragments. La nouvelle méthode agit comme un cartographe qui, à partir de quelques repères, reconstitue une carte complète du territoire.
Un programme de suivi ordinaire ressemble à un navigateur qui guide un navire à l'aide des étoiles. Mais dès que le ciel se couvre, les coordonnées dérivent et l'incertitude dans les données augmente — c'est ce qu'on appelle l'entropie. Le nouvel algorithme s'adjoint un « copilote » : un module qui surveille le niveau de confiance du navigateur principal.
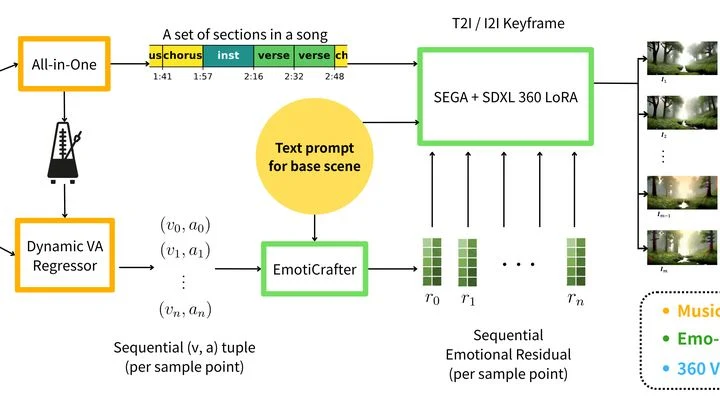
Le chef d'orchestre ne tient pas une baguette, mais un pinceau, et chaque mouvement fait naître couleur et forme. La nouvelle technologie fonctionne de la même manière : elle convertit l'ambiance d'une chanson en vidéo panoramique qui enveloppe l'auditeur.
D'abord, l'algorithme, à l'instar de l'analyse de la lumière par spectroscopie, décompose le morceau en émotions.
Les données sur l'activité des gènes ressemblent généralement à une longue rangée de chiffres, comme une bande arc-en-ciel (spectroscopie) sans liens visibles. Dans le modèle scVision, ces chiffres sont transformés en une image signifiante — non pas une liste d'ingrédients, mais une photo du plat fini.
L'approche standard actuelle de l'apprentissage de l'IA ressemble à un enfant enfermé dans une bibliothèque : il mémorise des millions de livres, mais ignore que le feu brûle et que la chute fait mal.
Communiquer avec des neurones vivants rappelle le réglage d'une vieille radio : il faut non seulement capter la bonne fréquence, mais aussi orienter l'antenne.
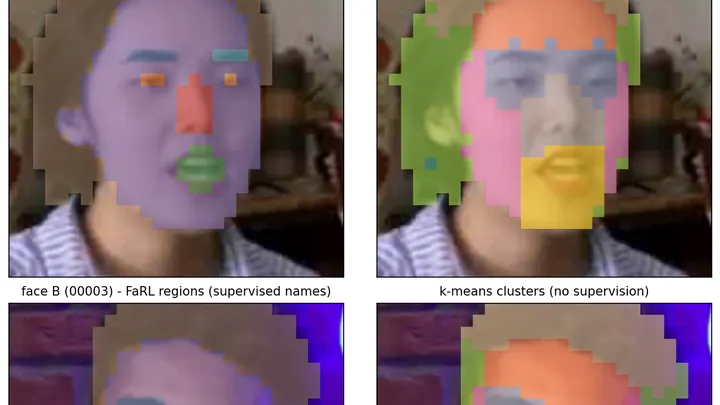
Entraîné sur des photos ordinaires, le modèle DINOv3 s'est mis à voir les visages comme un spectre : tout seul, sans indications, il distingue les zones des yeux, du nez, de la bouche.
Une personne dans une barque tourne en déplaçant le poids de son corps. Un navire autonome utilise la même astuce : la manœuvre est effectuée par une masse mobile à l'intérieur de la coque. Son mouvement est contrôlé par un réseau de neurones qui anticipe le chaos des vagues et les rafales de vent.
Les scanners ne produisent pas de clichés prêts à l'emploi. Ils collectent une multitude d'« ombres » — des projections de l'intérieur du corps, obtenues sous différents angles ou à l'aide de différents signaux — puis reconstruisent mathématiquement une image volumétrique.
Un enfant qui explore un appartement inconnu rampe d'un objet à l'autre et mémorise ce qu'il voit depuis chaque coin. C'est ainsi que le cerveau construit une carte mentale — un modèle interne de l'espace. L'algorithme gradCSCG fonctionne sur le même principe : il reçoit un flux vidéo d'une caméra et dessine lui-même le plan du lieu, en s'appuyant uniquement sur le changement des images.
Sur une cuisinière à gaz, chaque brûleur chauffe différemment. Si le cuisinier déplace les casseroles, la nourriture peut brûler. Il en va de même dans un réseau sans fil : les antennes-brûleurs et les utilisateurs-casseroles nécessitent un placement précis. Les réseaux de neurones classiques ne distinguent pas les positions, considérant tous les brûleurs comme identiques.
Un cuisinier qui apprend à cuisiner avec des images dessinées risque de rater chaque plat. Le même piège attend la vision par ordinateur : les modèles ont besoin de milliers d'images annotées, mais les collecter à la main est coûteux et fastidieux. Les images synthétiques résolvent le problème, à condition qu'elles ressemblent à de vraies.
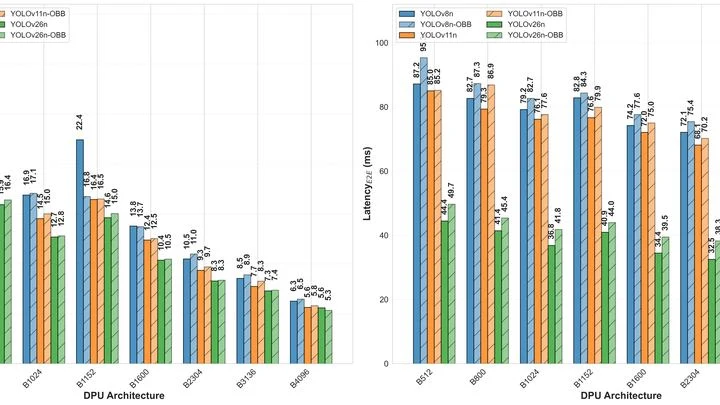
Les systèmes modernes de vision artificielle gagnent en autonomie : des ingénieurs ont réussi à implémenter un algorithme de reconnaissance des formes directement sur une puce miniature, évitant ainsi à la caméra de transmettre des données à un ordinateur encombrant.
Le flotteur dans la chasse d'eau est un contrôleur idéal : en sentant le niveau de l'eau, il ramène instantanément le système à l'équilibre sans se soucier du passé. Des ingénieurs ont appliqué ce principe aux réseaux de neurones.
Assembler une puce optique ressemble à un jeu où il faut faire passer un faisceau à travers un labyrinthe de minuscules miroirs et de séparateurs de faisceau. Chaque élément agit comme une aiguille sur une voie ferrée : il laisse passer la lumière tout droit ou la dirige vers une voie adjacente. Le but est d'obtenir en sortie un motif lumineux bien précis, en utilisant le moins d'« aiguillages » possible.
Le microscope électronique est un orgue géant : au lieu des tuyaux, des lentilles électromagnétiques ; au lieu de l'air, un flux d'électrons accélérés. Autrefois, il ne faisait que dessiner des fresques muettes du monde atomique, condamnant les scientifiques à un déchiffrage épuisant.
Plongez votre regard dans le ciel nocturne : ce n'est pas un semis d'étoiles, mais un manuscrit à plusieurs couches. Sous l'encre brillante des étoiles et des galaxies transparaît un texte pâle, presque effacé.
Le microlentillage gravitationnel est un effet cosmique fascinant, prédit par Einstein et développé par Zwicky. Un corps massif, passant entre nous et une étoile lointaine, courbe sa lumière comme une lentille, créant des amplifications et distorsions caractéristiques.
Dans l'Univers jeune, il y a environ dix milliards d'années, les galaxies ressemblaient à d'immenses champs après l'orage : partout, bouillonnantes, surgissaient d'énormes amas — de mille années-lumière — de formation stellaire, où de jeunes étoiles naissaient avec une énergie débridée.