Les neurones parlent un langage simple express
Un peintre compose son tableau en observant le spectateur dans la salle. Si le spectateur sourit, le peintre ajoute plus de rouge et de courbes ; s'il fronce les sourcils, il retire le bleu et casse les angles. C'est à peu près ainsi que les neuroscientifiques « interrogent » les neurones du cortex visuel, sauf qu'au lieu de couleurs, ils utilisent des centaines de milliers de photographies, et au lieu d'un sourire, une impulsion électrique.
Pour la toute première zone visuelle (V1), les scientifiques disposaient depuis longtemps d'un modèle commode : les neurones y réagissent à des caractéristiques simples — l'inclinaison d'une ligne, la fréquence des rayures. Mais dans la zone voisine V4, où se rassemblent des images plus complexes, un tel langage clair n'existait pas. Les auteurs de la nouvelle étude ont décidé que le langage universel pourrait être tout simplement le langage humain. Ils ont pris des copies numériques de zones du cerveau de macaque (V1 et V4), leur ont « montré » de nombreuses images et, pour chaque neurone, ont sélectionné celles qui provoquaient la réponse la plus forte et la plus faible. Ensuite, ces images ont été soumises à un modèle vision-langage qui a produit une courte légende — une hypothèse sur ce que ce neurone aime ou n'aime pas.
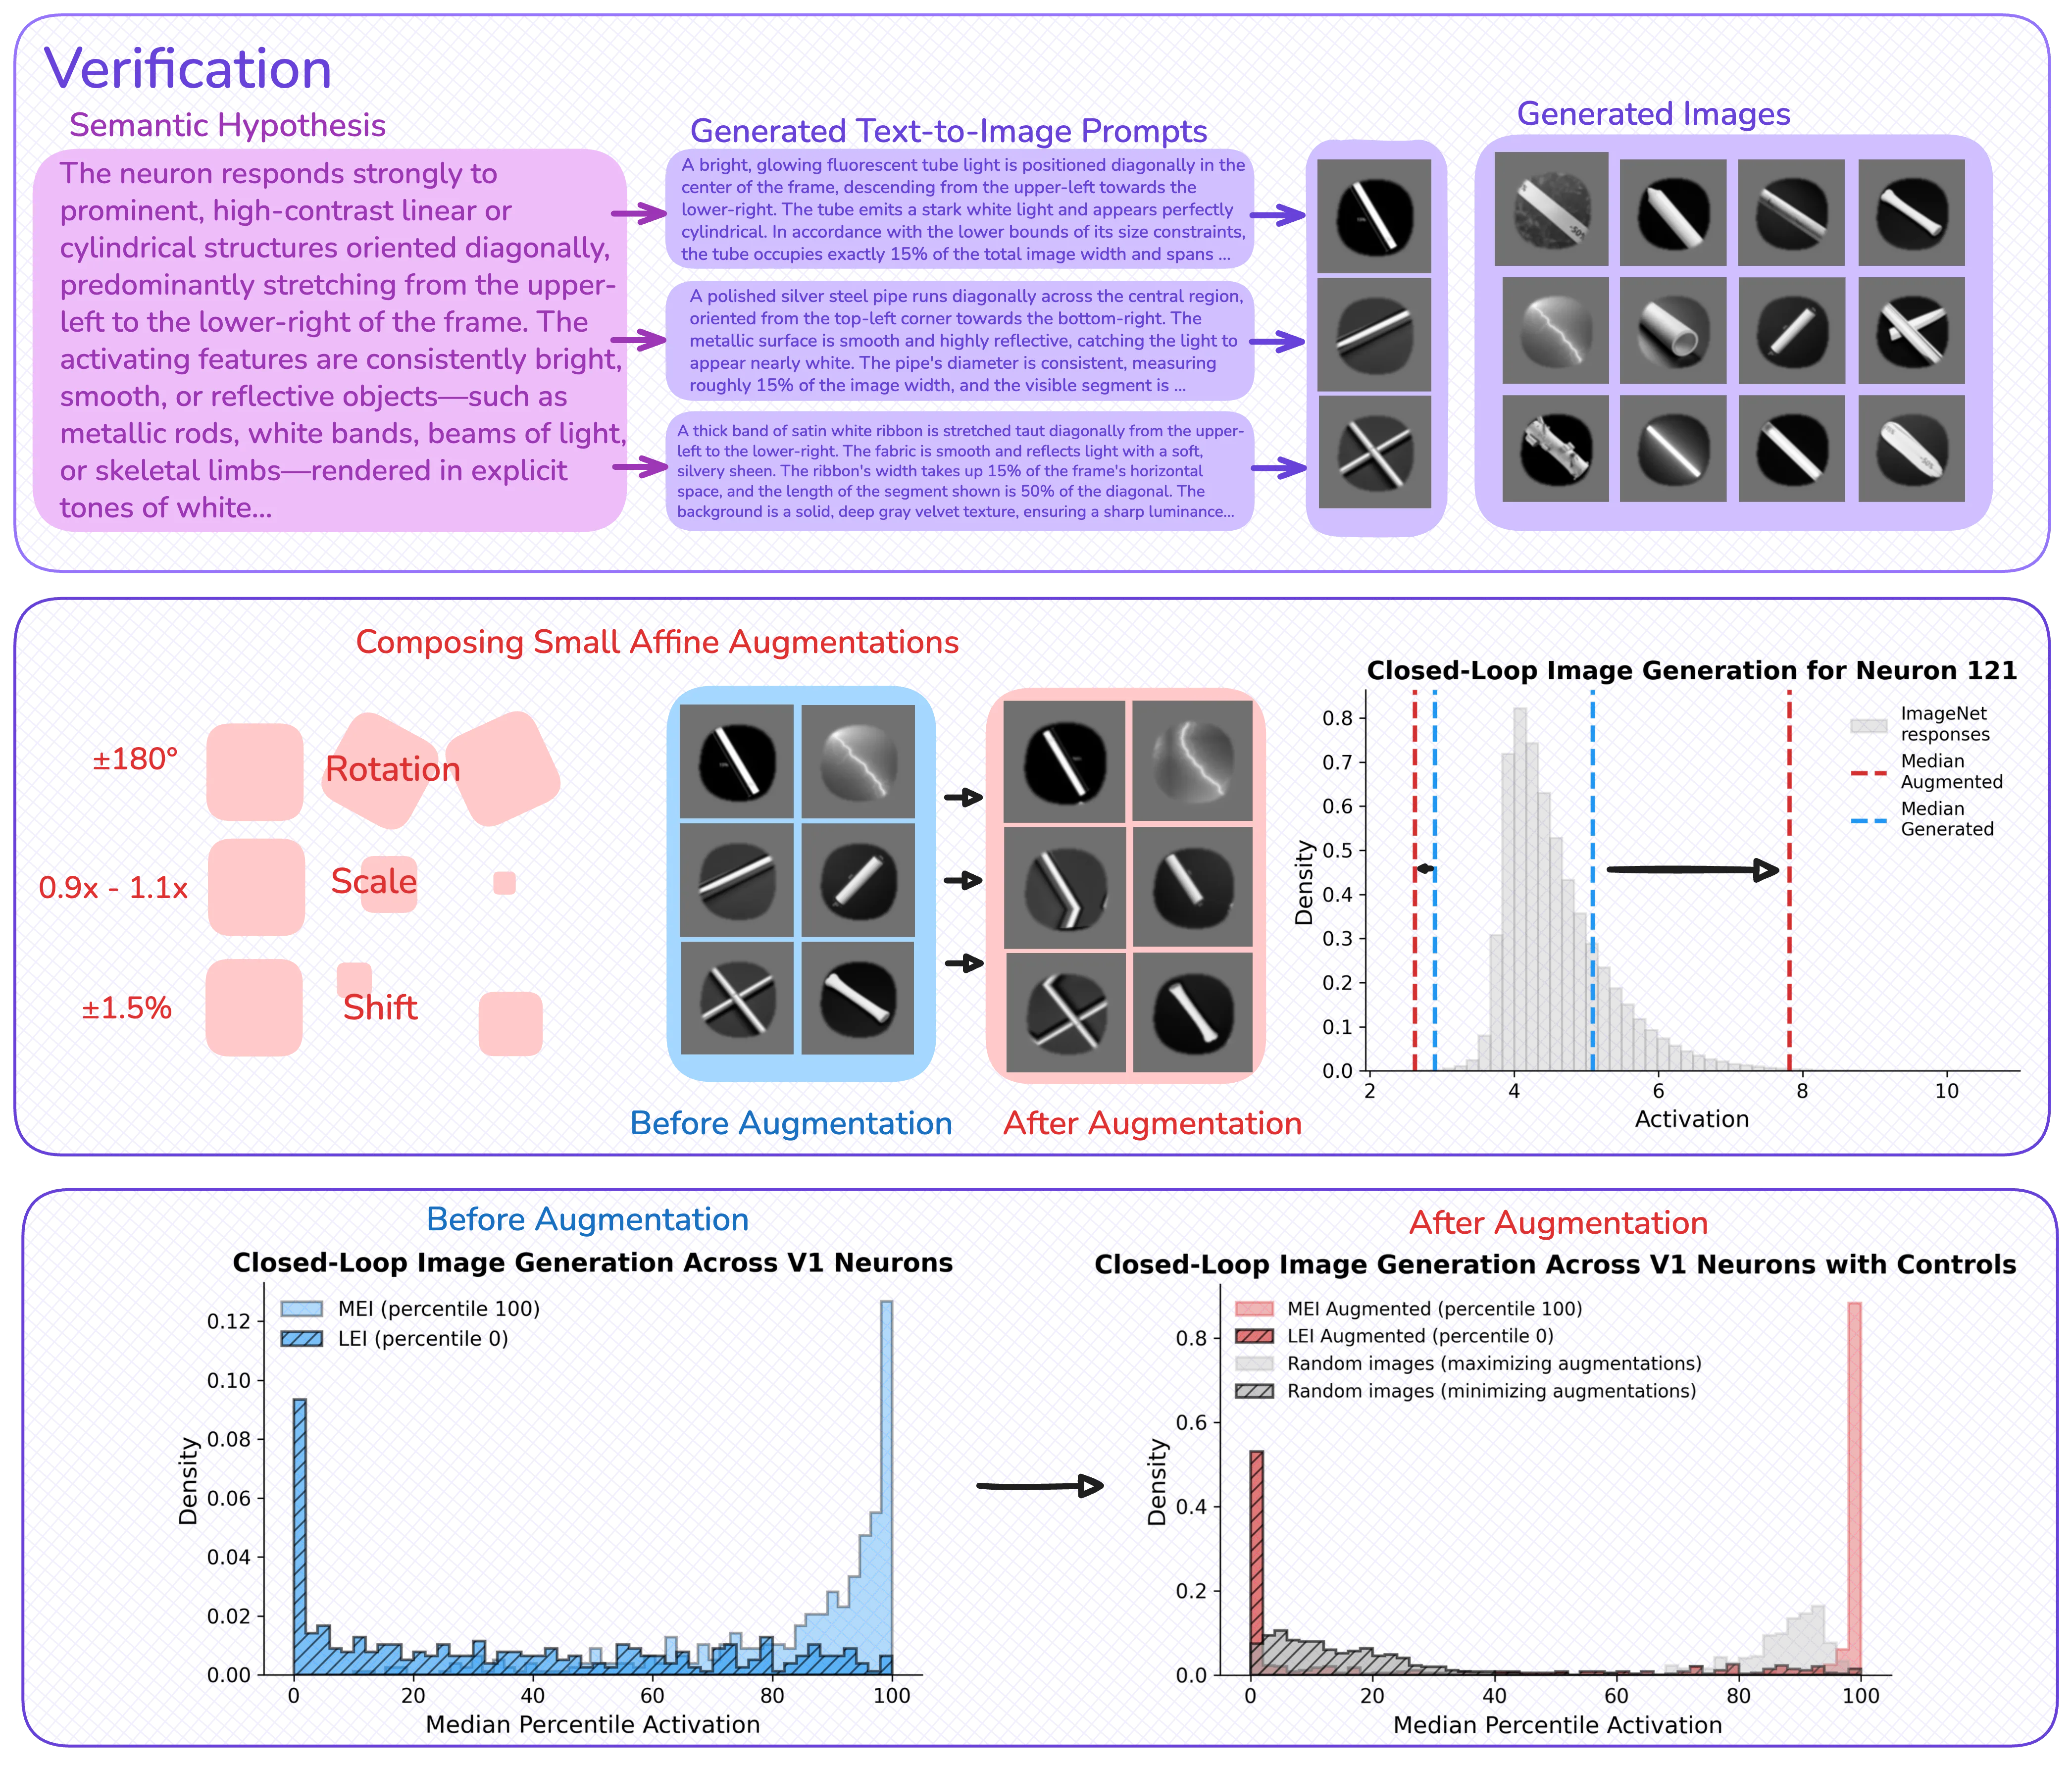
Pour vérifier les hypothèses, les scientifiques ont synthétisé, à partir des mêmes descriptions verbales, de nouvelles images jamais vues auparavant et les ont de nouveau « montrées » aux neurones numériques. Le résultat a été saisissant : dans la zone V4, les images créées selon la description « préférée » ont déclenché une réponse puissante chez 96,1 % des neurones (au-dessus du 95e percentile des stimuli naturels), tandis que les images « non aimées » ont au contraire inhibé 97,6 % des neurones en dessous du 5e percentile. Les images aléatoires ne donnaient qu'environ 10 % de telles correspondances. Pour V1, l'activation fonctionnait aussi précisément, mais la suppression s'est avérée plus difficile à décrire avec des mots — apparemment, le « non-aimé » est moins défini pour les cellules simples.
Cette approche rappelle le jeu du « téléphone arabe » entre le cerveau, l'image et le texte, mais avec une rigueur scientifique. Elle permet non seulement de choisir des stimuli au hasard, mais de « questionner » délibérément chaque neurone dans un langage que nous comprenons. À terme, un tel cycle fermé — des images aux mots et retour aux images synthétisées — pourrait devenir la base d'une découverte scientifique automatique, où l'algorithme formule et teste lui-même des hypothèses sur le fonctionnement du cerveau. Ainsi, le peintre qui commençait par deviner l'humeur du spectateur se retrouve avec un dictionnaire de ses préférences — et peint un tableau qui embrase les neurones dès la première seconde.
Résumé original
tel que rédigé par les auteurs, en anglais arXiv:2605.12485
Understanding what individual neurons encode is a core question in neuroscience. In primary visual cortex (V1), mathematical models (e.g., Gabor functions) capture neural selectivity, but no comparable framework exists for higher areas. We show that natural language can fill this role: across macaque V1 and V4, the selectivity of most neurons is captured by concise, verifiable semantic descriptions. Using digital twins of V1 and V4, we develop a closed-loop framework that translates each neuron's high- and low-activating images into dense captions, generates a semantic hypothesis and synthesized images, and verifies the hypothesis in silico. Descriptions range from oriented edges and spatial frequency in V1 to conjunctions of form, color, and texture in V4. In V4, images generated from activating and suppressing hypotheses drove 96.1% of neurons above the 95th and 97.6% below the 5th percentile of natural-image responses, respectively (vs. ~10% for random images); V1 activation results matched V4, while V1 suppression was less describable in language. Representational similarity analysis reveals partial alignment between neural activity, vision embeddings, and language embeddings, with vision most aligned to neural activity; alignment lost in the text bottleneck is recovered when hypotheses are rendered back into images, showing that linguistic compression is lossy yet semantically faithful. Together, these results show that combining generative models with neural digital twins enables interpretable, testable descriptions of neural function at scale, toward agentic scientific discovery.
Dans la zone V4 des macaques, on a trouvé des neurones qui réagissent à la combinaison de la couleur et de la texture — par exemple, un objet rouge sur une surface en bois. Cela ressemble étrangement à la façon dont les artistes décrivent leurs œuvres.
L'idée de « lire les pensées » des neurones via des modèles de langage fait écho à la nouvelle de Ted Chiang « L'histoire de ta vie », où le déchiffrement d'une langue extraterrestre modifie la perception de la réalité.