La régression symbolique est un type d'apprentissage automatique qui recherche une formule mathématique, plutôt que de simplement ajuster les paramètres d'une équation préétablie, afin de mieux correspondre à un ensemble de données. Contrairement aux réseaux de neurones, qui agissent souvent comme des boîtes noires, la régression symbolique produit des expressions lisibles par l'humain, telles que F = G·m₁·m₂/r². Cela en fait un outil puissant pour la découverte scientifique, car elle peut révéler la structure sous-jacente des phénomènes naturels directement à partir des données.
Histoire
Le concept a été popularisé dans les années 1990 par John Koza dans le cadre de la programmation génétique, bien que des travaux antérieurs sur la régression symbolique via des algorithmes génétiques aient existé dans les années 1980.
Comment ça marche
La méthode utilise des algorithmes évolutionnaires ou d'autres techniques de recherche pour combiner des opérations mathématiques de base (+, −, ×, ÷, sin, exp, etc.) en formules candidates. Chaque formule est évaluée sur sa capacité à prédire les données, et les meilleures candidates sont « mutées » et « croisées » pour produire de nouvelles générations. Le processus itère jusqu'à ce qu'une expression simple et précise émerge, souvent guidée par une pénalité pour la complexité afin d'éviter le surajustement.
En pratique
Elle est utilisée en physique pour redécouvrir des lois à partir de données expérimentales, en ingénierie pour l'identification de systèmes, et en finance pour modéliser la dynamique des marchés.
Anecdote
En 2019, un algorithme de régression symbolique a redécouvert indépendamment la loi de la gravitation universelle de Newton et d'autres équations fondamentales de la physique à partir de données d'observation brutes.
Un interprète dans une salle bondée essaie de saisir le discours d'une personne, mais entend le bourdonnement de centaines de voix. Une molécule qui stocke l'information quantique dans son spin se trouve dans une situation similaire : son spin est entouré par l'agitation thermique des atomes, et c'est précisément cette agitation qui efface progressivement la mémoire.
Le diamant n'est pas qu'une simple parure. Dans son réseau cristallin se cachent des défauts qui détectent le champ magnétique mieux que bien des instruments. L'un de ces défauts, le centre NV, agit comme une minuscule boussole, mais son aiguille oscille à cause de la chaleur et du bruit.
L'interprète se laisse distraire par le moindre bruit dans la salle, et une réunion d'une heure s'étire sur deux. C'est le même problème pour les modèles de fondation moléculaires : ils apprennent le langage des molécules sur d'immenses corpus, mais chaque nouvelle conversation exige un réglage.
Un poisson solitaire voit une ombre au-dessus de sa tête. Fuir ? Si ce n'est qu'une feuille, il aura gaspillé son énergie et se sera révélé à un prédateur. Si c'est un héron, l'hésitation est mortelle. C'est le compromis éternel de l'individu isolé : réagir vite signifie beaucoup de fausses alertes, être prudent signifie risquer de se faire dévorer.
Dans un banc, c'est différent.
Garder en tête la position exacte d'un stylo qu'on déplace lentement est une tâche banale pour le cerveau. Pour les réseaux de neurones artificiels, c'est presque impossible. Les réseaux récurrents classiques, comme GRU et LSTM, ont tendance à découper le mouvement continu en paliers rigides : le stylo ne glisse pas de façon fluide, il saute d'un point à un autre.
Prédire le rendement d'une réaction chimique, c'est un peu comme essayer de deviner la récolte en ne connaissant que la composition du sol. Traditionnellement, les chimistes s'appuyaient sur de longues colonnes de nombres – les descripteurs quantiques – qui décrivent l'énergie des électrons mais restent muets sur la forme de la molécule.
Reconstituer une image complète à partir de fragments, c'est un peu comme essayer de distinguer la mélodie d'un orchestre dans une salle bruyante. De telles tâches se posent en photométrie, où l'on reconstitue la luminosité d'une étoile à partir de faibles scintillements.
Une IA classique regarde les images médicales comme des puzzles faits de pièces inconnues : elle considère que deux images non appariées sont complètement différentes. C'est comme essayer de distinguer des jumeaux sans connaître leur lien de parenté. Or, en médecine, les patients atteints d'une même maladie présentent des IRM presque identiques, et l'algorithme se trompe en confondant les « parents ».
Évaluer la qualité d'une image, c'est le travail d'un contrôleur méticuleux muni de tout un attirail. Le réseau de neurones IQA-T1 agit exactement ainsi : il ne se contente pas de dévisager l'image, il y applique tantôt un spectroscope, tantôt un luxmètre.
La préparation d'un plat complexe exige une recette claire : d'abord couper, puis faire revenir, ajouter les épices au bon moment. Les transformations chimiques suivent aussi des recettes pas à pas — des mécanismes où les atomes de carbone et d'hydrogène se réarrangent strictement dans l'ordre.
Les puces neuromorphiques fonctionnent différemment des ordinateurs classiques, construits selon les plans de John von Neumann, avec une mémoire et un processeur séparés.
Le flotteur dans la chasse d'eau est un contrôleur idéal : en sentant le niveau de l'eau, il ramène instantanément le système à l'équilibre sans se soucier du passé. Des ingénieurs ont appliqué ce principe aux réseaux de neurones.
La méthode standard de numérisation de la parole : on mesure le volume des milliers de fois par seconde. C'est comme goûter un bouillon avec une cuillère à café — chaque gorgée est aqueuse, et il n'y a presque pas de détails. Le flux de données enfle, alors que le sens se compte sur les doigts.
Les chercheurs ont proposé de « réduire » d'abord le signal sonore.
Plongez votre regard dans le ciel nocturne : ce n'est pas un semis d'étoiles, mais un manuscrit à plusieurs couches. Sous l'encre brillante des étoiles et des galaxies transparaît un texte pâle, presque effacé.
Le ciel gamma, immortalisé par le télescope Fermi, est une symphonie grandiose de milliers de sources. On y trouve les pulsations rythmiques des pulsars, les accords puissants des noyaux actifs de galaxie, mais surtout des objets non identifiés dont la partition reste une énigme.
Le rayonnement fossile, c'est la première lumière qui a réussi à percer le brouillard dense de l'Univers naissant. Son spectre, telle une partition figée de la symphonie cosmique, conserve les infimes fluctuations de densité à l'origine des galaxies.
La lumière des galaxies lointaines met des milliards d'années à nous parvenir, mais en chemin, elle est déviée et courbée par la toile invisible de la matière noire. Cet effet, prédit par Einstein dans le cadre de la relativité générale, est appelé lentille gravitationnelle.
Les chaînes de spin quantiques évoquent une file de personnes se transmettant une poignée de main secrète : chacun se tourne vers son voisin, et la force de la poignée détermine la manière dont l'onde se propage le long de la chaîne.
Le trou noir n'est pas un vide figé, mais un moteur magnétique vivant. Son « cœur » — le disque d'accrétion — pulse : à l'inspiration, la matière s'enroule en entonnoir ; à l'expiration, la reconnexion magnétique déchire les lignes de champ, et le plasma jaillit loin de l'horizon.
Un médecin ne pose pas un diagnostic au hasard. Il ouvre le manuel médical et montre sur quel article il s'appuie. C'est à peu près ainsi que fonctionne le nouveau système KG-TRACE.
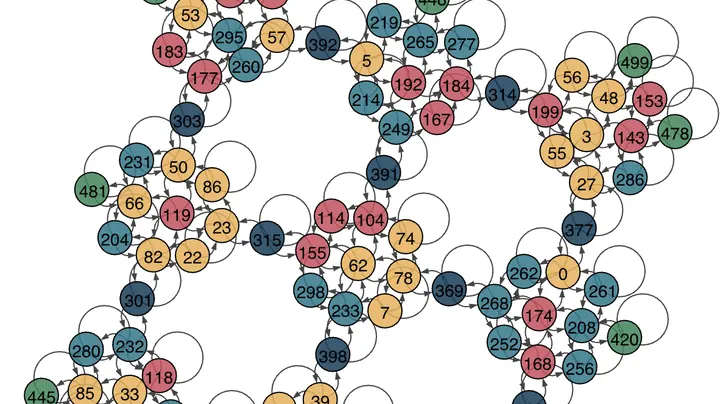
Les détecteurs de rayons X fonctionnent comme un nid d'abeilles : dans les alvéoles hexagonales, des particules scintillent de temps en temps. Les algorithmes classiques étirent ces alvéoles sur une grille carrée, ce qui fait apparaître de faux fantômes de polarisation.
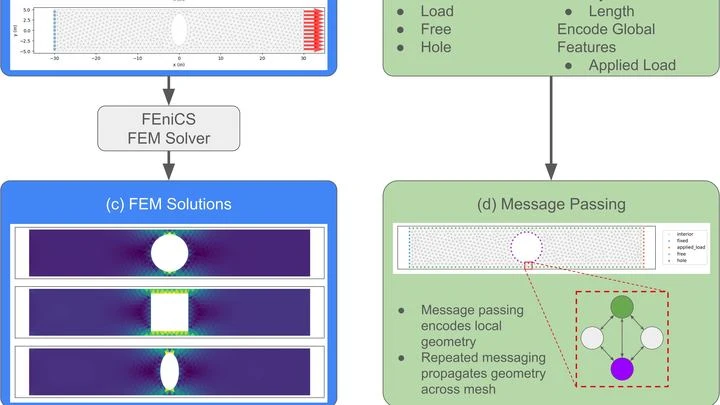
Concevoir des machines, c'est un peu comme faire de la pâtisserie : il faut savoir exactement où la pâte va se déchirer. Les anciens calculs informatiques vérifient chaque point de la pièce pendant des heures — comme si on mesurait toute la casserole pour être sûr que l'anse ne se détache pas.
Un peintre compose son tableau en observant le spectateur dans la salle. Si le spectateur sourit, le peintre ajoute plus de rouge et de courbes ; s'il fronce les sourcils, il retire le bleu et casse les angles.
Quand des trous noirs entrent en collision, la trame même de la courbure de l'espace-temps frémit. Cette ondulation — les ondes gravitationnelles — est captée par des détecteurs, mais son déchiffrage a longtemps exigé des heures de simulations informatiques.
Une usine où des centaines de minuscules chaînes de montage tournent sans arrêt. Chaque chaîne est un moteur moléculaire qui convertit un carburant chimique en mouvement. Pour que le moteur aille plus vite ou dans la bonne direction, l'ingénieur modifie les réglages — la forme des pièces, la force des interactions.
Dans une salle où jouent une centaine d'instruments, une symphonie s'élève, mais le chef d'orchestre est caché derrière un rideau. Le scientifique n'entend que les notes jouées par les instruments et cherche à comprendre qui donne le rythme. Les données scientifiques ressemblent à cet orchestre : nous enregistrons les lectures des instruments, mais nous ne voyons pas les mécanismes cachés qui les dirigent.
Les astronomes, tels des cuisiniers, ont longtemps préparé la description de l'Univers avec les mêmes recettes lourdes. Ces recettes – des formules mathématiques complexes – estimaient combien de galaxies de différentes luminosités et masses remplissent le cosmos, ainsi que la répartition des fondations invisibles de matière noire.
Si l'on montre la même photo de chat à deux réseaux de neurones différents, ils arrivent souvent à une conclusion similaire : « chat ». Mais si on leur demande plus de détails, les réponses peuvent diverger. Un modèle remarquera les moustaches, un autre la robe, un troisième la posture.
Une protéine ressemble à un collier de perles – les acides aminés – qui se replie en une forme bien précise, et c'est cette forme qui détermine son rôle dans la cellule. Les concepteurs de protéines déplacent les perles pour obtenir la forme voulue, mais le nombre de combinaisons est immense.
La cosmologie standard repose sur le Big Bang et l'énergie noire, mais il existe une alternative — le modèle de Georges Lemaître–Tolman–Bondi, où l'expansion de l'univers s'explique non par une force mystérieuse, mais par les irrégularités naturelles dans la distribution de la…
Un ordinateur classique, lorsqu'il cherche une loi de la nature à partir de données, tente de deviner une formule complète d'un seul coup. C'est comme si un cuisinier, sans connaître la recette, jetait tous les ingrédients dans la casserole en espérant obtenir une soupe.
Une cellule cancéreuse ressemble à une serrure têtue qui change ses clés quand on essaie de l'ouvrir. Le médicament agit comme un passe-partout, mais la cellule trouve rapidement un moyen de lui barrer la route. Dans cette nouvelle étude, les chercheurs ont construit un modèle informatique qui reproduit le comportement des cellules cancéreuses soumises à divers dysfonctionnements génétiques.
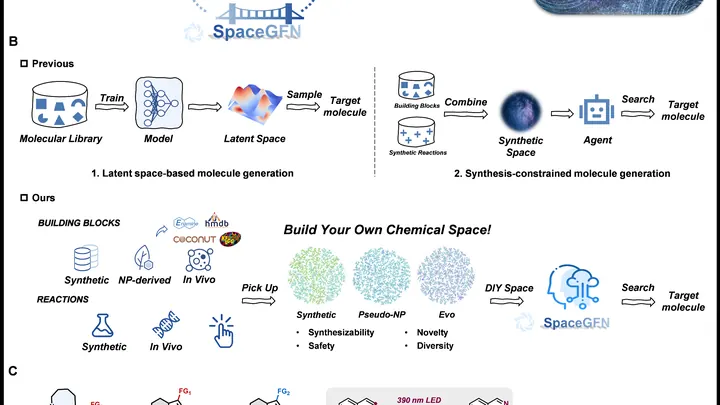
Autrefois, les modèles génératifs pour la découverte de médicaments fonctionnaient comme un peintre qui dessine sans choisir sa toile. Ils apprenaient à partir de molécules existantes et produisaient simplement des molécules similaires, sans se soucier de la structure de l'espace des composés possibles.
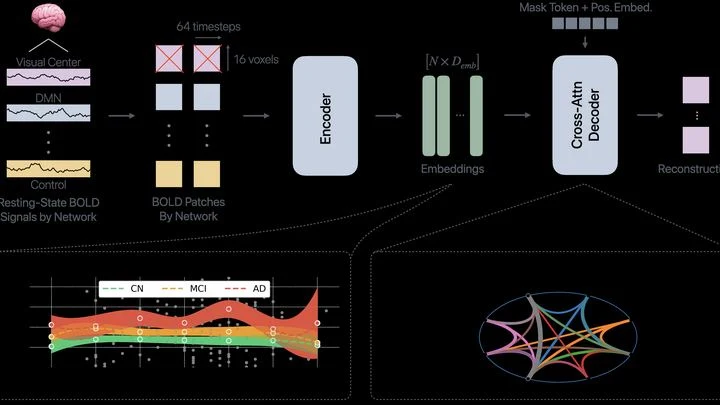
Le cerveau n'est pas un gros ordinateur unique, mais plutôt un orchestre où différents groupes de musiciens jouent leurs partitions. Les réseaux de neurones responsables de la mémoire, de l'attention ou des émotions communiquent constamment. Dans la maladie d'Alzheimer, cet orchestre commence à jouer faux : certains groupes se taisent, d'autres jouent à contretemps.
Lorsque deux particules entrent en collision puis se séparent, les physiciens consignent le résultat sous la forme d'une formule mathématique complexe. Ces formules sont nombreuses, et des liens invisibles les unissent — comme entre différentes recettes d'un même plat : on change l'ordre des étapes, mais le goût reste le même.
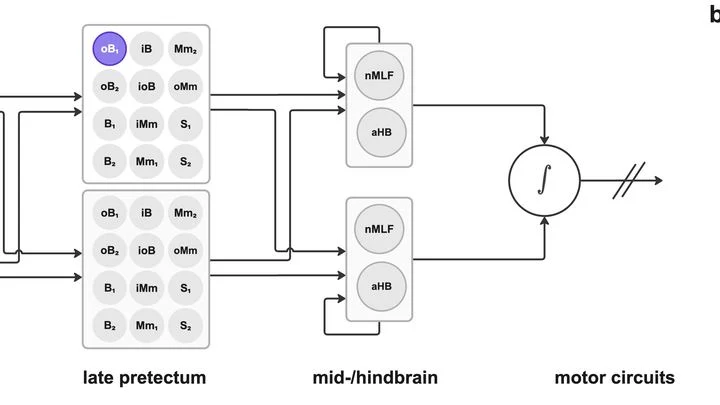
La larve du poisson zèbre est presque transparente, et son cerveau peut être observé au microscope. Mais même chez une si petite créature, les connexions neuronales sont si enchevêtrées qu'il est presque impossible de les démêler à la main. Les scientifiques ont fait un coup de maître : ils ont créé une copie informatique exacte de cette larve, où chaque connexion est connue.
Un chimiste à la recherche d'un nouveau médicament ressemble à un cuisinier sans recette : il a une liste de propriétés souhaitées, mais des millions d'ingrédients possibles. Chaque essai coûte cher et prend du temps, il faut donc procéder avec méthode.
Le nouveau programme SEISMO agit comme un cuisinier qui goûte le plat après chaque étape et décide aussitôt quoi ajouter ensuite.
Chaque pensée laisse une trace : une faible décharge électrique sur le cuir chevelu. Un appareil muni de dizaines de fils, semblable à un bonnet de bain, capture ces traces et les transforme en lignes ondulées. À partir de ces lignes, on peut deviner ce que ressent une personne, même si elle reste silencieuse.
En emménageant dans un nouvel appartement, on ne réapprend pas à ouvrir les portes ni à allumer la lumière. L'expérience de l'ancienne maison se transfère d'elle-même : la cuisine, c'est l'endroit avec la cuisinière et l'évier ; la chambre, celui avec le lit. Le cerveau ne stocke pas une carte exacte, mais un schéma flexible qu'il superpose à un espace inconnu.
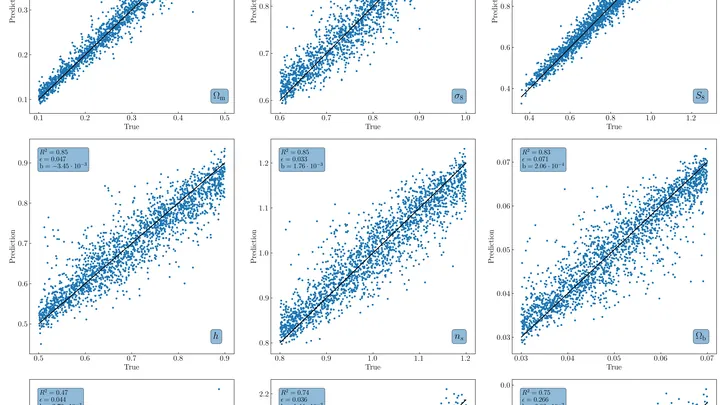
Des milliers d'univers sont nés dans un ordinateur pour, un jour, parler du nôtre. Chacun avec ses amas de galaxies, disposés selon les lois de la gravitation, comme des petits pois dans un bocal secoué avec plus ou moins de force. La façon dont les petits pois se répartissent permet de deviner quelle main a secoué le bocal.