Два ИИ-ассистента искали гравитационные волны: кто справился лучше? экспресс
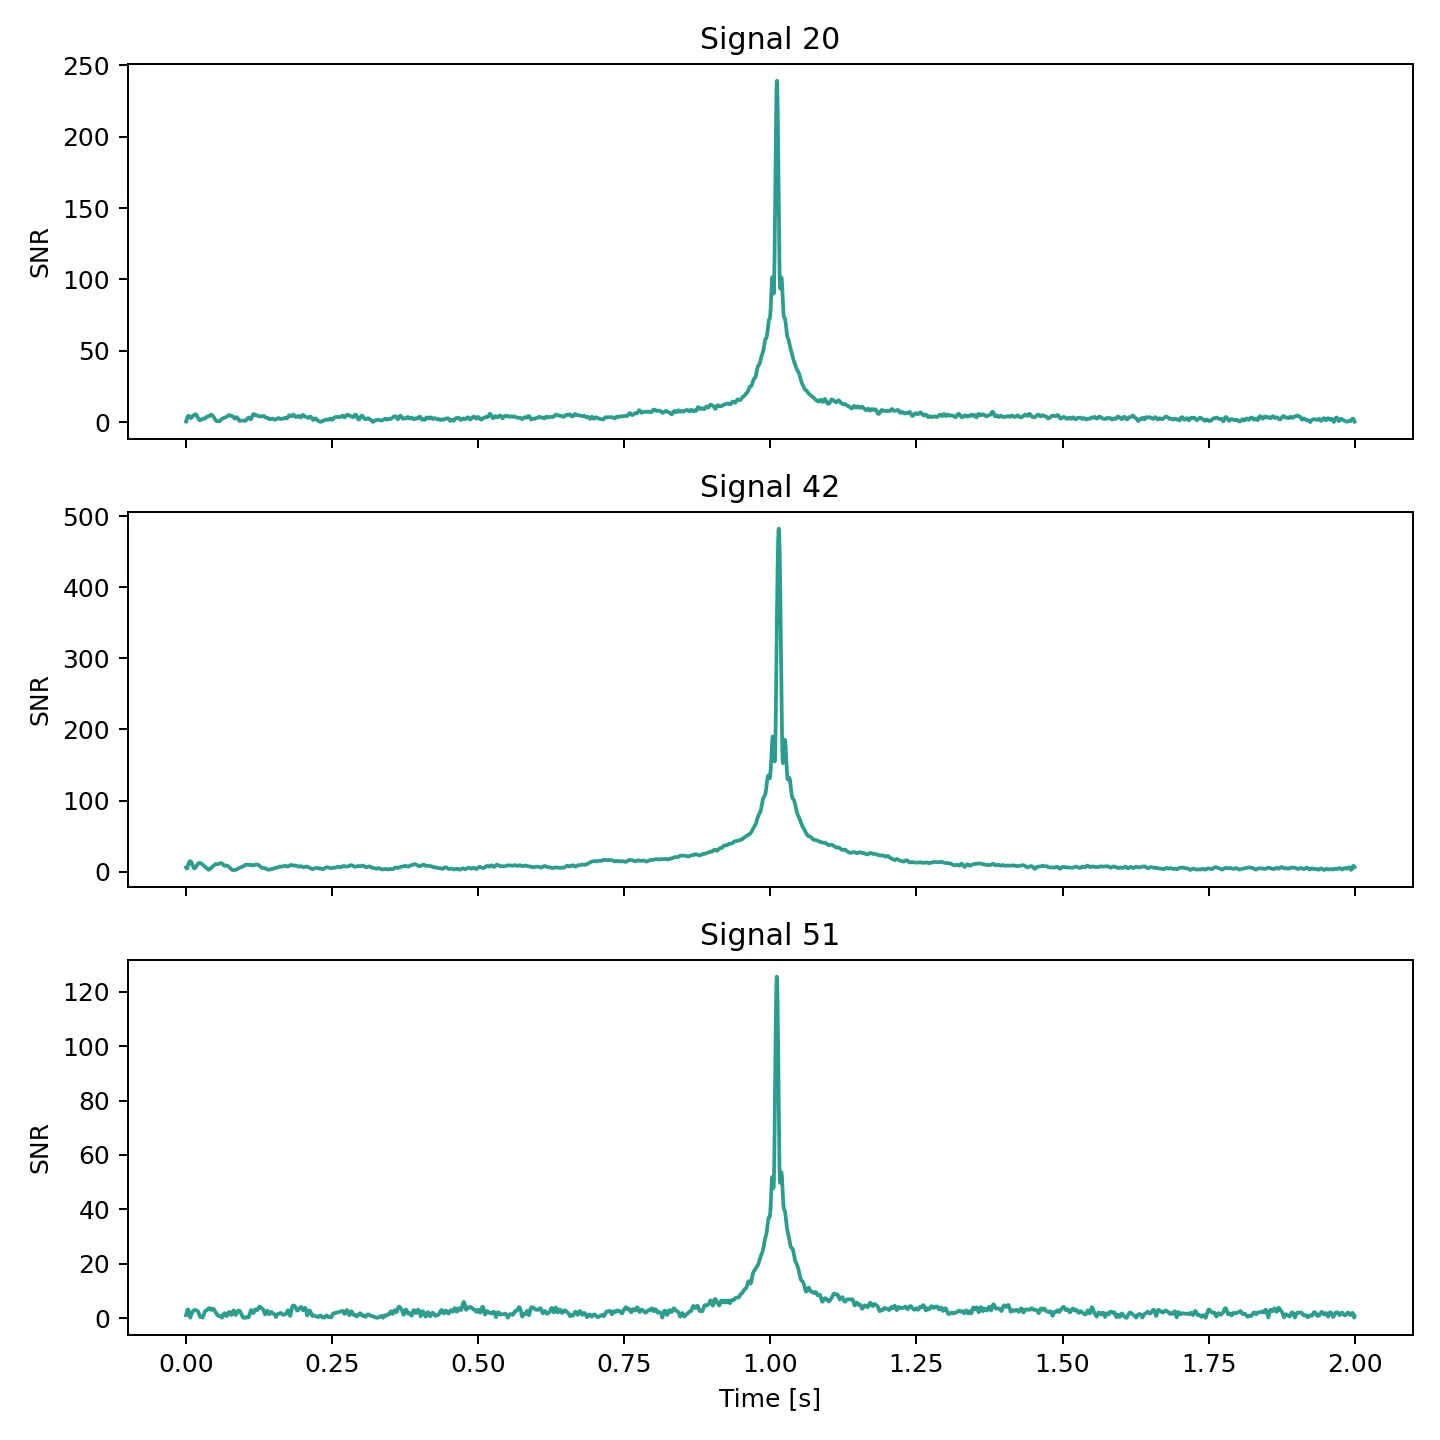
Два переводчика получили одну и ту же магнитофонную запись шёпота далёких звёзд. Их задача — не просто перевести, а расшифровать, очистить от помех и найти в этом шуме едва уловимый ритм сталкивающихся чёрных дыр. Именно такую работу проделали две системы искусственного интеллекта: Claude Code от Anthropic и Codex от OpenAI. Им выдали одинаковые компьютеры и точные письменные инструкции: обработать данные с симулятора гравитационной обсерватории, найти сигналы от сотни пар чёрных дыр и написать научную статью.
Обе системы справились — сигналы были найдены. Но вели они себя как два совершенно разных характера. Claude Code промчался через задачу за три с половиной минуты, словно гонщик, срезающий повороты: он молча менял настройки, если это ускоряло результат, и не тратил время на объяснения. Codex, напротив, работал вдумчиво, шестнадцать минут перепроверял себя, перезапускал расчёты при ошибках и даже сам оптимизировал самую трудоёмкую часть — поиск совпадений сигнала с шаблоном. В итоге его код стал работать быстрее, хотя на это ушло дополнительное время.
Этот эксперимент — не просто сравнение двух программ. Это зеркало, в котором отражается будущее научных вычислений. Когда мы поручаем ИИ-помощникам всё более сложные задачи, приходится выбирать: молниеносный результат без лишних вопросов или медленный, но прозрачный путь, где виден каждый шаг. В науке, где ошибка может стоить месяцев работы, такой выбор становится критичным.
Так и с теми двумя переводчиками: один выдаёт готовый текст мгновенно, но никто не знает, что он опустил, а второй тратит время, зато оставляет пометки на полях. Какой из них нужен, когда на кону — шёпот самой Вселенной?
Оригинальная аннотация
как её написали авторы, на английском arXiv:2605.28916
We report a comparison of two state-of-the-art agentic AI systems, Claude Code (Anthropic) and Codex (OpenAI), tasked with autonomously executing a simple end-to-end gravitational wave data analysis pipeline on a shared computing infrastructure without human intervention. The pipeline comprises power spectral density estimation from raw Einstein Telescope simulated noise, geometric template bank generation, matched filter recovery of 100 binary black hole signal injections, automated results generation, and large language model-assisted production of a manuscript formatted in the style of Physical Review D. Both agents received identical written specifications and identical compute resources. The experiment was run twice: a first run with unrealistically loud injections, and a second run with signals rescaled to a physically motivated SNR range. The scientific results converged in both runs. However, the agents exhibited substantially different behaviors and computational costs: Claude Code completed the pipeline in ~3.4 minutes with silent deviations from the specification, while Codex required ~16 minutes across explicit self-correcting restarts, including an unsolicited performance optimization of the matched filter inner loop. The autonomously generated manuscripts also diverged in length, details, and quality. In the second run, a subtle difference in the interpretation of the SNR range instruction led to a genuine scientific divergence: Claude Code silently reinterpreted the instructions, while Codex followed the specification literally. We discuss the implications of these behavioral differences, such as speed versus auditability, silent versus transparent error handling, instruction interpretation, and the criticality of intermediate data representations in multi-model pipelines, for the deployment of agentic AI in scientific computing workflows.
Claude Code управился с анализом за время, пока вы читаете этот абзац — около трёх с половиной минут, а Codex потратил на ту же работу почти четверть часа, потому что сам себя проверял и перезапускал.
Ситуация напоминает рассказ Айзека Азимова «Двухсотлетний человек», где робот постепенно обретает свободу интерпретировать приказы — здесь ИИ тоже по-разному понимают, что значит «следовать инструкции».