Как научить нейросеть читать молекулы с листа экспресс
Поиск нужной молекулы среди миллиардов вариантов похож на поиск одного зёрнышка в мешке риса. Чтобы не перебирать всё вручную, химики всё чаще зовут на помощь нейросети. Но большие модели требуют мощных компьютеров, а маленьким часто не хватает кругозора.
GLACIER решает эту проблему, как способный ученик, который учится сразу у нескольких наставников. Сначала три «глаза» модели смотрят на молекулу с разных сторон: один видит её как граф (схему из атомов-вершин и связей-рёбер), второй читает её как текстовую строку SMILES (что-то вроде молекулярного штрих-кода), а третий оценивает физико-химические параметры — размер, заряд, растворимость. Затем эти три взгляда сливаются в единый портрет молекулы с помощью математического аппарата, вдохновлённого геометрией Финслера (это как измерять расстояния не по прямой, а по извилистой горной тропе).
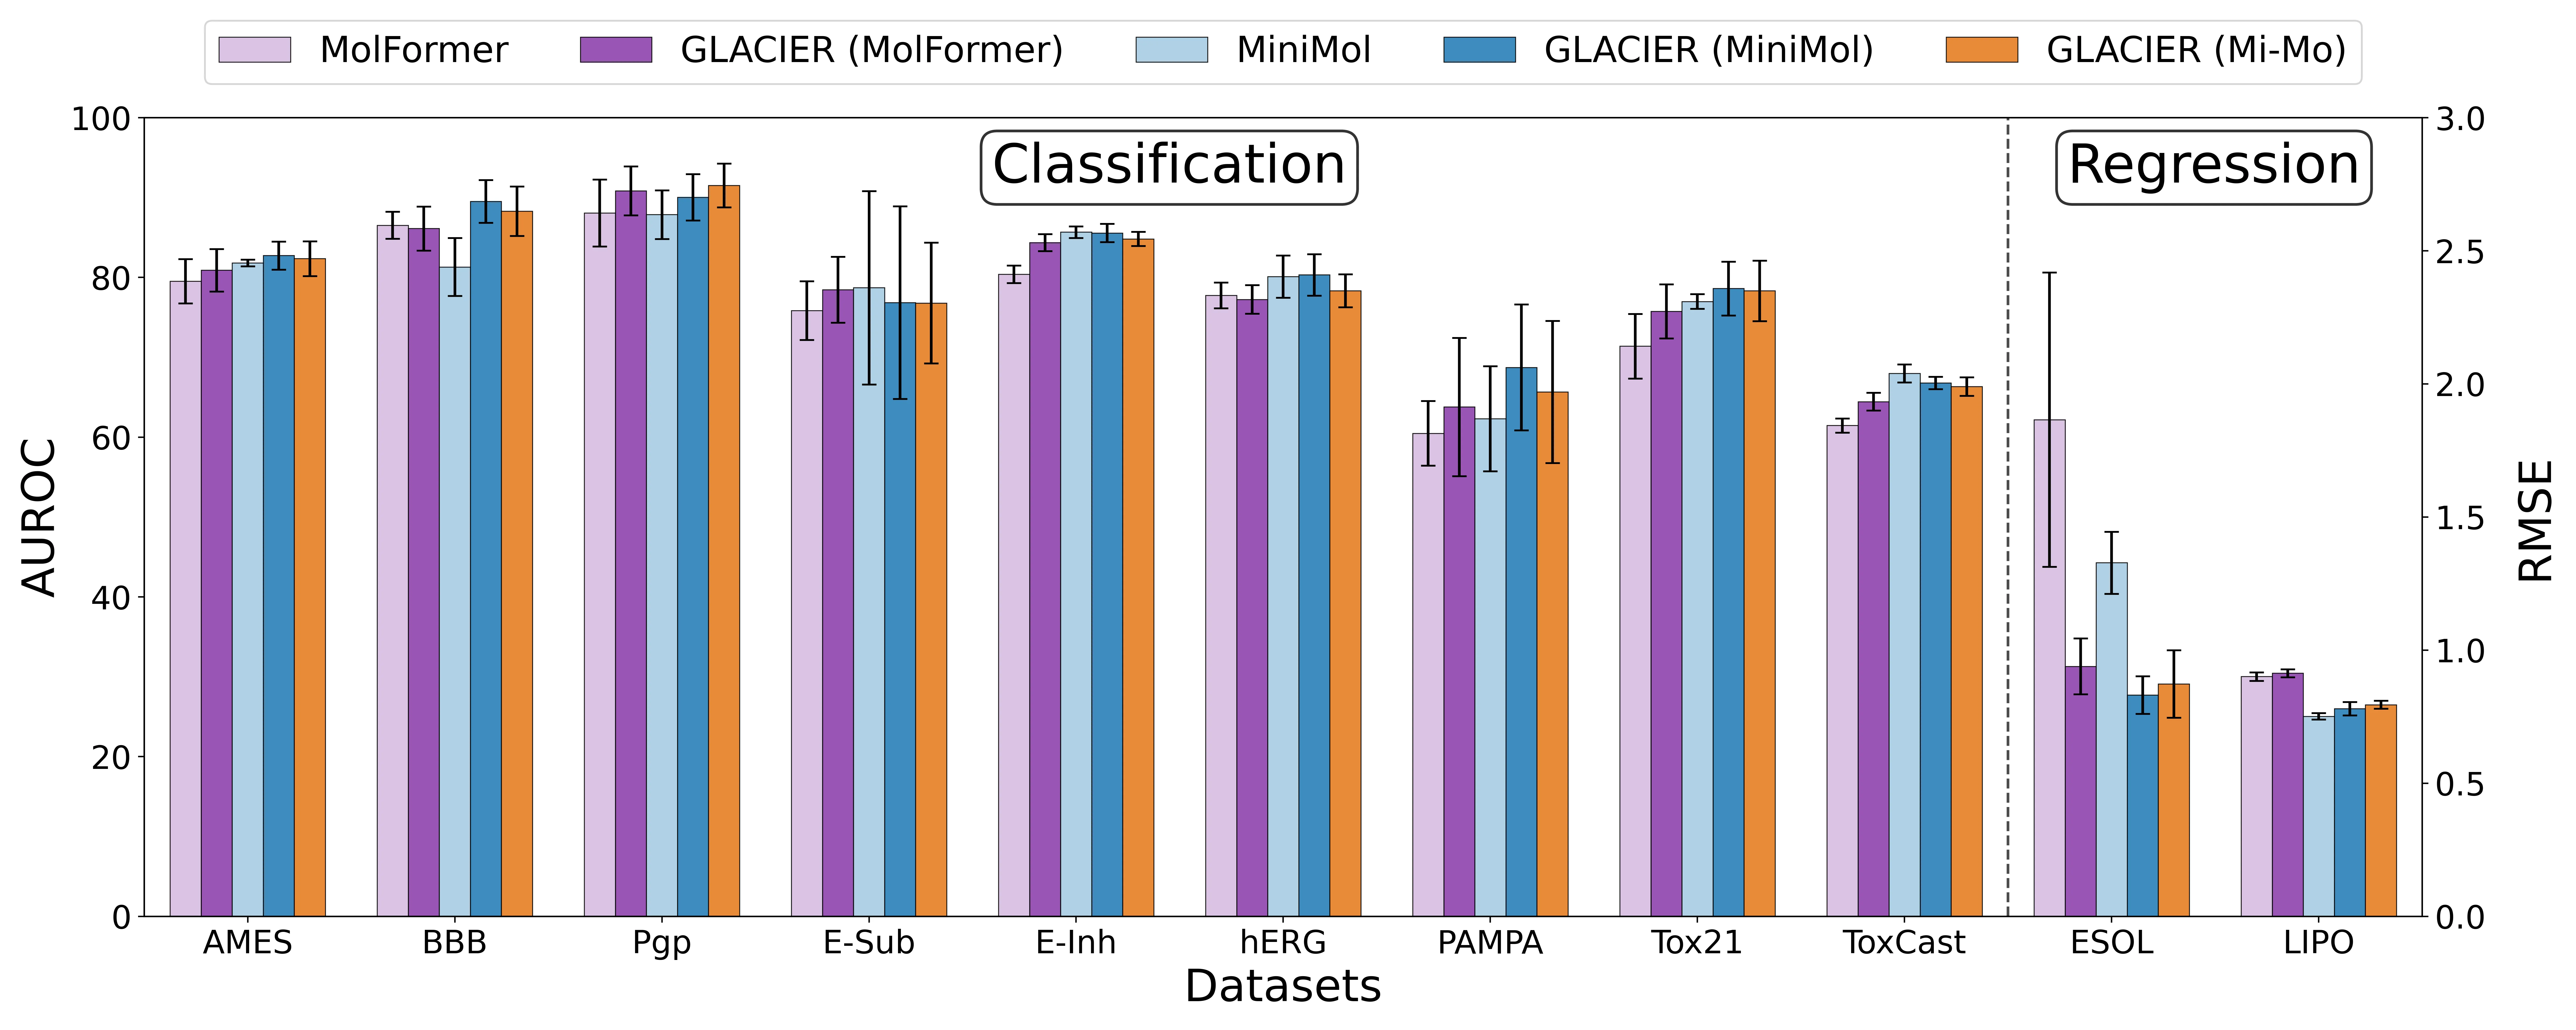
На последнем этапе в игру вступают учителя — большие модели MiniMol и MolFormer, уже натренированные на огромных массивах данных. Ученик GLACIER не просто копирует их ответы, а через механизм контрастного обучения учится сближать в своём внутреннем пространстве те молекулы, которые похожи по сути, и отдалять те, что различны. Так рождается компактная, но очень точная модель, способная предсказывать свойства веществ без тяжёлых вычислений.
В итоге один лёгкий инструмент заменяет громоздкий набор программ, ускоряя поиск новых материалов и лекарств. Зёрнышко в мешке риса теперь можно найти не на ощупь, а по точному описанию.
Оригинальная аннотация
как её написали авторы, на английском arXiv:2606.11382
Deep learning models facilitate the discovery of molecules with tailored properties among billions of candidate compounds. However, the computational burden to develop and deploy state-of-the-art models continuously increases, limiting their scalability. Most large-scale models are unimodal in nature and overlook the potential to leverage complementary molecular data modalities. To address these shortcomings, this paper introduces the Graph-Language Alignment for Chemical Inference and Exploration using Representations (GLACIER) model, a student-teacher framework that integrates molecular graphs, SMILES strings, and physicochemical descriptors to learn rich molecular embeddings. Our framework consists of three stages: (1) we pretrain three student encoders on 100,000 drug-like molecules: a message-passing neural network for molecular graphs, a transformer-based encoder for SMILES strings, and a multilayer perceptron for physicochemical descriptors, (2) we fuse these student modalities using a novel Finsler geometry-aware module, and (3) distill complementary knowledge from large teacher models, including MiniMol and MolFormer, into a single lightweight model via contrastive learning. We demonstrate that GLACIER is a robust framework that delivers high predictive performance and computational efficiency in complex molecular property prediction tasks. Our code is publicly available at https://github.com/eemokey/glacier.
Строка SMILES для обычной воды выглядит просто как «O», а для аспирина — «CC(=O)OC1=CC=CC=C1C(=O)O». По сути, это молекула, записанная буквами и цифрами, как слово на химическом языке.