Деление, которое не дробит память экспресс
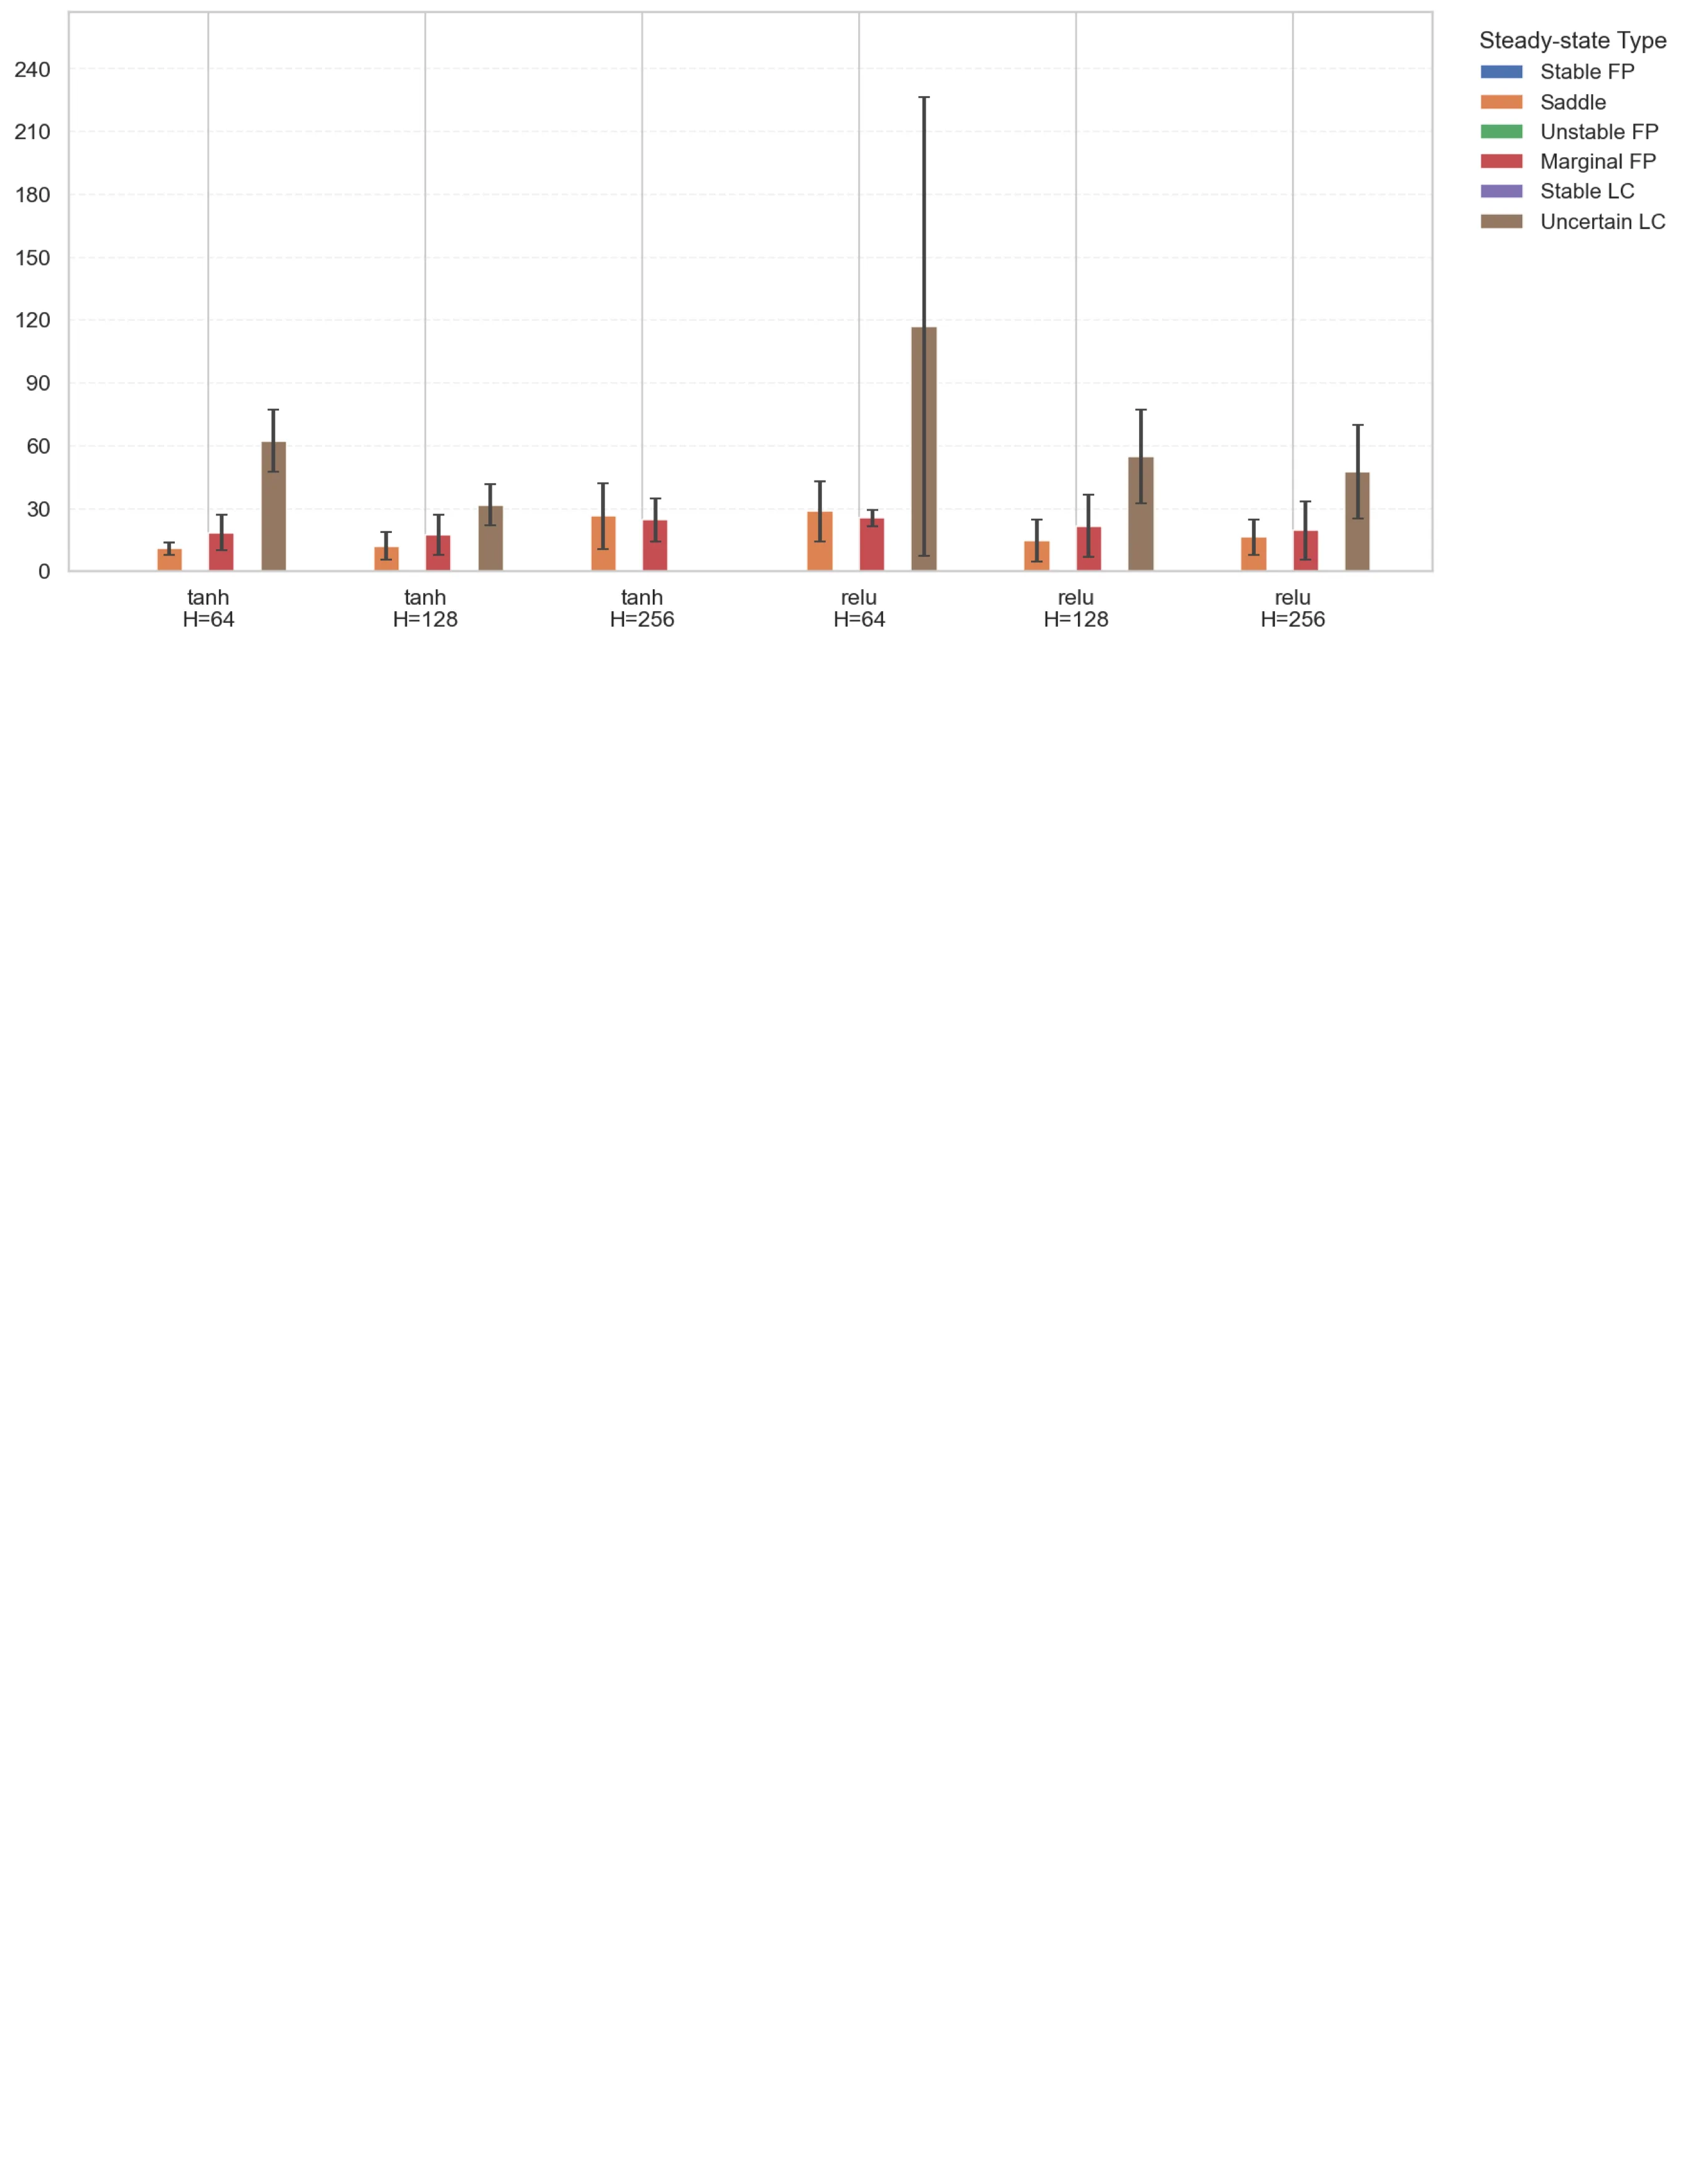
Удержать в голове точное положение ручки, пока её медленно двигают, — для мозга рядовая задача. Для искусственных нейросетей она почти невыполнима. Обычные рекуррентные сети, вроде GRU и LSTM, склонны разбивать непрерывное движение на жёсткие ступеньки: ручка не ползёт плавно, а перескакивает из точки в точку. Сеть словно запоминает не линию, а несколько отдельных кадров.
Группа исследователей предложила сеть с делением — Recurrent Divisive Normalization Network (RDNN). Её секрет не в вычитании тормозных сигналов, а в их делении. Когда один нейрон активен, он не просто глушит соседа, а уменьшает его выход пропорционально. Это напоминает регулировку громкости: если в комнате шумно, мы не вычитаем шум из речи, а делим — говорим громче относительно фона. Такой механизм широко распространён в коре мозга, но в искусственных сетях его почти не используют.
Математический анализ показал, что деление создаёт в сети медленное многообразие — плавную дорожку, по которой состояние памяти может меняться без скачков. Когда сеть обучают методом обратного распространения ошибки, деление автоматически масштабирует шаги обучения: в сильно активных участках обновление параметров затухает. Это сжимает эффективный ранг сети — динамика сама ужимается в узкое низкоразмерное русло, избегая переобучения и хаоса.
В экспериментах на задачах рабочей памяти RDNN удерживала непрерывные сигналы в десятки раз точнее обычных сетей. А когда деление заменили на вычитание, сеть тут же начинала дробить плавный сигнал на ступеньки. Похоже, биология не зря выбрала именно этот механизм — деление оказалось математически необходимым для хранения непрерывных величин в меняющемся мире.
Оригинальная аннотация
как её написали авторы, на английском arXiv:2608.01947v1
The ability to robustly maintain and update continuous variables is a hallmark of working memory. While classical continuous attractor networks suffer from severe fine-tuning fragility, standard artificial recurrent neural networks (RNNs) like GRUs and LSTMs typically fail to stably learn continuous manifolds, instead shattering the state space into discretized point attractors. To bridge this gap, we draw inspiration from divisive normalization, a canonical neural computation widely observed across cortical circuits, and propose the Recurrent Divisive Normalization Network (RDNN), a minimal and algebraically isolated model of dynamic division. Through dynamical systems analysis on canonical working memory tasks, we demonstrate that this biophysical constraint allows the network to converge to robust, high-fidelity slow manifolds. Furthermore, we analyze the gradient dynamics of divisive normalization during Backpropagation Through Time (BPTT), showing that it introduces an activity-dependent local gradient scaling. This scaling dampens parameter updates in highly active regimes, which empirically aligns with a significant self-compression of the network's effective rank, confining the recurrent dynamics to a tight, low-dimensional subspace while avoiding the optimization pathologies associated with explicit low-rank factorization. Finally, ablations demonstrate that while subtractive inhibition can maintain static memories, divisive normalization is mathematically essential to prevent manifold shattering under time-varying inputs. Our findings identify divisive normalization not merely as a biological artifact, but as a critical computational mechanism for learning high-fidelity continuous representations.
Деление сигналов в нейронах впервые описали в зрительной коре: так мозг не ослепляется ярким светом, а просто делает чувствительность ниже — делит, а не вычитает.