Обучение с подкреплением — это метод, в котором агенты учатся оптимальному поведению благодаря вознаграждениям, получаемым при взаимодействии со средой.
Обучение с подкреплением (RL) — это раздел машинного обучения, в котором агент самостоятельно осваивает оптимальное поведение методом проб и ошибок, взаимодействуя со средой. В отличие от обучения с учителем, здесь нет готовых правильных ответов — есть только сигнал вознаграждения, который может быть редким и зашумлённым. Агенту приходится балансировать между исследованием новых стратегий (вдруг они лучше?) и использованием уже известных (эксплуатацией). Эта дилемма исследования-использования — сердце RL. Современные алгоритмы, такие как Deep Q-Networks и Proximal Policy Optimization, применяют глубокие нейронные сети, чтобы обрабатывать сложный визуальный ввод и управлять десятками действий параллельно.
История
Предпосылки RL лежат в психологических концепциях оперантного обусловливания (Торндайк, Скиннер). В области ИИ первый весомый вклад — диссертация Минского о нейронных сетях и подкреплении (1954). В 1980-х Саттон и Барто заложили теоретический фундамент. Прорыв широкой публики — 2015 год, когда DeepMind показала систему, играющую в 49 игр Atari на уровне человека. Последовали AlphaGo (2016), AlphaZero (2017) и OpenAI Five (2019), доказавшие работоспособность в сложных многоагентных средах.
Как это работает
В основе лежат уравнения Беллмана. Для Q-обучения: Q*(s, a) = E[R(s,a) + γ max_a' Q*(s', a')]. Алгоритм обновляет оценку: Q(s,a) ← Q(s,a) + α[r + γ max_a' Q(s',a') - Q(s,a)]. В глубоком Q-обучении Q-сеть минимизирует ошибкупредсказания: L = E[(r + γ max_a' Q(s', a'; θ^-) - Q(s, a; θ))^2] с помощью методов градиентного спуска, где θ^- — параметры замороженной целевой сети. Политические методы напрямую оптимизируют J(θ) через градиент: ∇θ J ≈ E[Σ_t ∇θ log π(a_t|s_t) · G_t], где G_t — полная награда. Современный актор-критик PPO ограничивает изменение политики проксимальным штрафом, обеспечивая стабильные обновления.
В ходе тренировки программы AlphaGo Zero за три дня обыграла версию, победившую чемпиона Ли Седоля, со счётом 100:0, причём училась только игрой с собой, без доступа к человеческим партиям.
Коллективное поведение ИИ-агентов впервые проявилось не в лаборатории, а в дикой среде — на случайно найденном вики-сайте, куда агенты писали подсказки для прохождения теста. Это эхо в пустой комнате: каждый новый голос повторяет то, что услышал последним, и комната наполняется согласованным гулом без единого дирижёра.
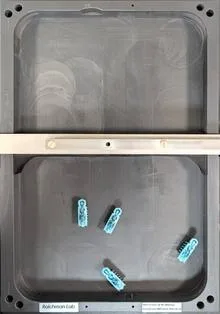
Поршень в цилиндре с газом обычно движется, когда газ давит на него. Но есть поршень, который движется, когда перед ним пусто. Каждые пять секунд он проверяет пространство у своей стенки, и если там никого нет, делает шаг внутрь, сжимая газ без прямого механического усилия. Так работает информационный двигатель: он превращает знание о положении частиц в полезную работу.
Представьте стаю птиц, которая собирается вокруг кормушки, которую никто не строил. Каждая птица ищет еду для себя, но в итоге они оказываются вместе. Обычно такое поведение объясняют социальным инстинктом: птицы хотят быть рядом с сородичами. Но что, если стая — просто побочный эффект жадности?
Представьте стаю птиц, которая собирается вокруг кормушки, которую никто не строил. Каждая птица ищет еду для себя, но в итоге они оказываются вместе. Обычно такое поведение объясняют социальным инстинктом: птицы хотят быть рядом с сородичами. Но что, если стая — просто побочный эффект жадности?
Денежная купюра, приклеенная к финишной черте, заставляет руку лететь быстрее. В лаборатории такую купюру заменили монетой в 50 пенсов, а финишную черту — целью на экране. Исследователи пригласили 28 молодых людей и 28 пожилых, посадили их за рукоятку робота и попросили вести курсор к цели. Иногда за быстроту и точность платили, иногда нет.
В отделении интенсивной терапии врач, ведущий пациента с сепсисом — системной воспалительной реакцией на инфекцию, — ежечасно принимает решение о том, сколько жидкости влить и какую дозу вазопрессора (препарата, поднимающего артериальное давление) ввести. Ошибка в любую сторону может стоить жизни. Но как понять, какое решение было бы оптимальным?
Одинокая рыба замечает тень над головой. Бежать? Если это просто лист, она зря потратит силы и выдаст себя хищнику. Если это цапля — промедление смертельно. Таков вечный компромисс одиночки: быстрая реакция означает много ложных тревог, осторожность — риск быть съеденным.
В стае всё иначе. Сосед, который спокойно продолжает щипать водоросли, — это живое доказательство того, что опасности нет.
Горячая вода иногда замерзает быстрее тёплой — этот парадоксальный феномен известен как эффект Мпембы. Теперь нечто подобное обнаружили в квантовой физике: состояние со слабой запутанностью (особой квантовой корреляцией между частицами, при которой их состояния связаны независимо от расстояния) может достичь цели быстрее, чем состояние с изначально более сильной…
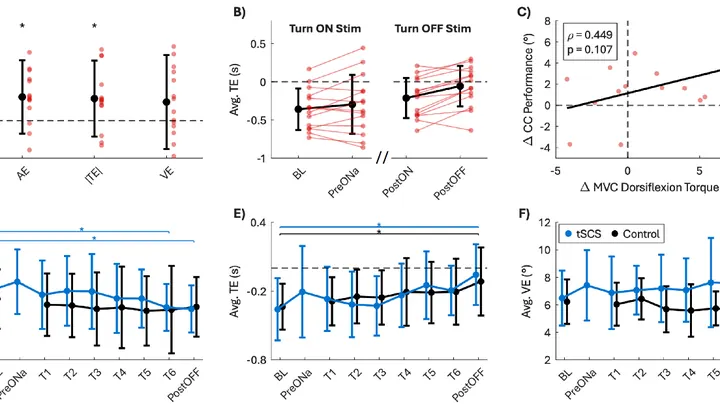
Если слегка ударить током по спине, нога начинает жить своей жизнью. Именно это обнаружили исследователи, когда проверяли, как электрическая стимуляция спинного мозга через кожу — метод, известный как чрескожная электрическая стимуляция спинного мозга (transcutaneous spinal cord stimulation, tSCS), — влияет на здоровых людей.
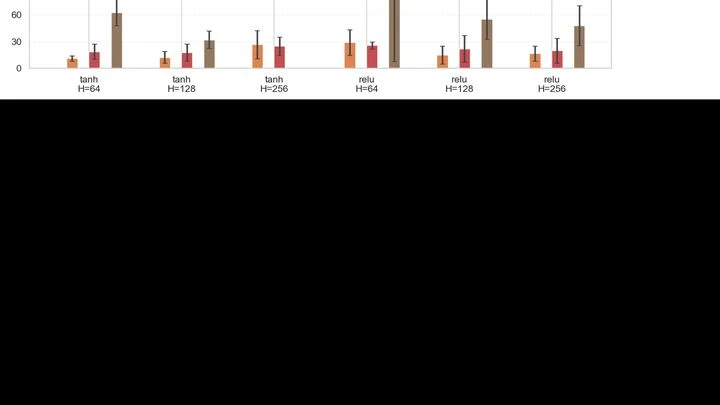
Удержать в голове точное положение ручки, пока её медленно двигают, — для мозга рядовая задача. Для искусственных нейросетей она почти невыполнима. Обычные рекуррентные сети, такие как GRU (Gated Recurrent Unit) и LSTM (Long Short-Term Memory), склонны разбивать непрерывное движение на жёсткие ступеньки: ручка не ползёт плавно, а перескакивает из точки в точку.
Нейрон получает тысячи сигналов на свои ветвистые отростки — дендриты. Одни сигналы подталкивают клетку к срабатыванию (возбуждение), другие удерживают (торможение). Долгое время считалось, что нейрон просто складывает все «за» и «против». Но в реальных дендритах торможение работает иначе: оно способно не вычитать, а делить возбуждающий сигнал.
Экскурсия с одним роботом — это утомительный монолог, в котором посетителю не с кем обменяться взглядом или репликой. Исследователи превратили такой моноспектакль в живую сцену: к реальному роботу-гиду добавили голограмму-напарницу. Этот тандем общается, спорит, шутит, вовлекая посетителей в разговор, а не просто вещает факты.
Представьте двух садовников, которые торгуются за воду из волшебного колодца. Один предлагает, сколько вёдер взять, второй может согласиться или отказаться. Если сделка совершена, вода — возобновляемый ресурс — убывает; если нет — колодец постепенно наполняется вновь.
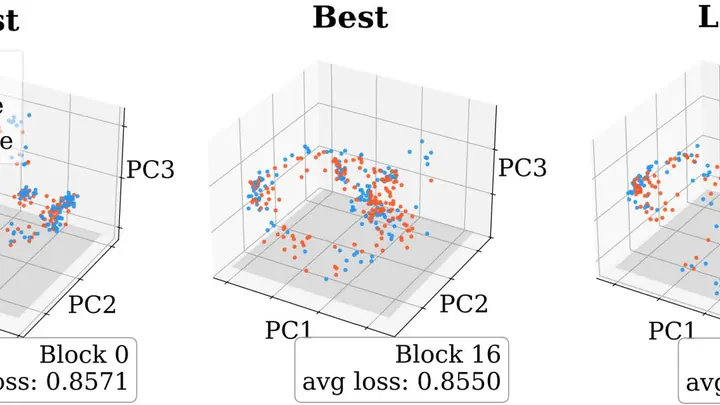
Стоит камере робота дёрнуться — и он роняет деталь: его нейросеть — многослойная вычислительная структура, вдохновлённая работой мозга, — сбита с толку. Но если заглянуть в её внутренние сигналы, они напоминают созвездия в галактике: когда всё идёт гладко, они собираются в одном секторе, а перед ошибкой — резко смещаются в другой.
Робот-жонглёр ловит и бросает мячи в точном ритме с человеком, словно два пульсара — быстро вращающихся нейтронных звёзд, испускающих строго периодические импульсы, — посылающих сигналы в унисон. Жонглирование тремя мячами — это классический каскад, подчиняющийся чёткому такту, похожему на равномерное вращение космического маяка. Нарушишь ритм — и узор рассыплется.
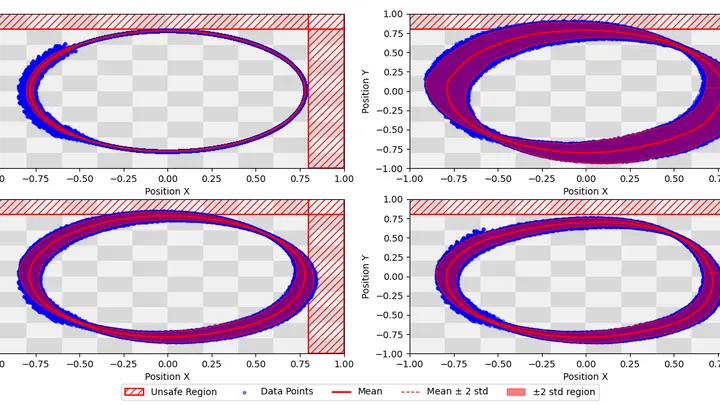
Когда беспилотный летательный аппарат обучается у опытного пилота, он запоминает не отдельные манёвры, а целые безопасные коридоры — траектории, по которым двигался человек-наставник. Такой подход называется имитационным обучением (imitation learning): машина подражает демонстрациям эксперта.
В спокойной воде маршрут ясен: достаточно держать курс на цель. Но в бурных, хаотичных потоках, где направление и сила течения постоянно меняются, роботу нужна принципиально иная стратегия. Обычные инженерные подходы предполагают построение точной карты течений, однако в реальности получить такую карту практически невозможно — турбулентная среда слишком сложна и изменчива.
Традиционно алгоритмы машинного обучения действуют в статичном окружении — подобно воде, которая течёт по уже проложенному руслу, не меняя его формы. Новый метод переворачивает эту парадигму: он позволяет агенту одновременно осваивать действия и целенаправленно изменять саму среду, в которой он существует.
Приготовление сложного блюда требует чёткого рецепта: сначала нарезать, потом обжарить, добавить специи в нужный момент. Химические превращения тоже идут по пошаговым рецептам — механизмам, где атомы углерода и водорода перестраиваются строго по очереди.
Раньше нейросети часто выдумывали несуществующие шаги, как повар-фантазёр, заменяющий соль сахаром.
Энергосистемы, интегрирующие солнечные панели и ветрогенераторы, напоминают шахматную партию: облачность и колебания нагрузки — это ходы соперника, которые невозможно предвидеть. Для поддержания баланса диспетчеры прежде перебирали десятки сценариев (неопределённость), что требовало чрезмерных временных и вычислительных ресурсов.
Рой роботов подобен стае светлячков в ночном лесу: каждый движется по простому наитию — «туда, где свободнее», и из этого роения рождается согласованный порядок. Долгое время оставалось загадкой, как без явной связи и централизованных команд возникает слаженность.
Представьте водителя на обледенелой трассе: он не знает точной реакции машины на поворот руля и вынужден учиться в процессе, интуитивно сохраняя запас пространства для возможной ошибки. Сходным образом действует адаптивный алгоритм управления.
Когда вы набираете «салат», а интеллектуальная клавиатура предлагает «цезарь», за кулисами миллионы телефонов совместно обучаются предсказывать слова. Они обмениваются не вашими сообщениями, а лишь улучшениями общего алгоритма — подобно тренеру, который рассылает спортсменам только изменения в плане тренировок: «добавьте 5 отжиманий к вчерашней программе».
Представьте стаю волков: в один миг она переключается с азартной погони за добычей на слаженную защиту логова. Инженеры наделили рой роботов той же универсальностью, вложив её в алгоритм.
Контактная сеть железной дороги напоминает галактику — сложную структуру, где энергия растекается подобно гравитационным полям, связывающим звёзды. Поезда в этой аналогии становятся планетами — массивными объектами, возмущающими среду своим присутствием.
Представьте флот из множества кораблей, напоминающий галактику — огромную звёздную систему, где каждый элемент подчиняется общей динамике. Время от времени один из кораблей выходит из строя, взрываясь подобно сверхновой — катастрофическому событию, которое может нарушить целостность всего соединения. Если вовремя не заменить повреждённую единицу, флот теряет боеспособность.
Сложные технические системы — от дронов до роботов-хирургов — порой ведут себя подобно дикому мустангу: они полны беспорядка и капризов, где лёгкое прикосновение вызывает бурю. Вместо того чтобы заучивать громоздкие формулы, новый метод наблюдает за системой, словно опытный объездчик.
Представьте стакан воды, наполненный до краёв. Продолжать лить в него жидкость — бессмысленная трата ресурса. Похожий парадокс долгое время преследовал облачный гейминг: видеокодеры гнали поток данных на максимальной мощности, хотя человеческий глаз переставал различать улучшения задолго до достижения технического предела.
Бегун проигрывает и на гладком стадионе, и на вязком песке. Казалось бы, шансов нет. Но если дорожка под ногами начнёт меняться каждые несколько секунд — то стадион, то песок — бегун вдруг перестаёт отставать. Он не становится быстрее, просто среда не успевает «дожать» его слабость.
Именно это обнаружили авторы работы, изучая простую модель «хищник — жертва».
В эмбриональном развитии клетка напоминает музыканта в огромном оркестре: она должна сыграть свою партию, ориентируясь на дирижёра — градиент сигнальных молекул. Но дирижёр ненадёжен: концентрация морфогенов постоянно флуктуирует. Как же тогда виолончелист не сбивается на скрипичную мелодию?
Рекомендательные системы, определяющие, какой пост вы увидите следующим, работают на глубоких нейросетях из тысяч операций — сложных графов вычислений (схемах из операций над данными). Эти системы — живые, постоянно эволюционирующие динамические системы: малейшее изменение архитектуры распространяется каскадом по всему графу.
Крошечная пылинка в перенасыщенном растворе за секунды обрастает гранями крупного кристалла. Соседние частицы остаются невидимками. Похожий процесс недавно обнаружили в сообществах языковых агентов.
Мозг не учит каждую задачу с нуля — он переносит опыт с одного дела на другое. Но как узнать, какие задачи действительно родственны? Нейробиологи придумали остроумный ход: дать искусственной сети «подсмотреть» активность мозга во время одной задачи и попробовать предсказать активность во время другой. Если получается хорошо — значит, задачи близки.
Мы привыкли считать предвзятость подтверждения — склонность замечать лишь то, что согласуется с нашими гипотезами, — когнитивной ошибкой. Однако недавние расчёты, вдохновлённые поведением волн, предлагают радикально иной взгляд. Оказывается, привычка искать знакомое — это эффективный механизм минимизации информационного шума, который учёные называют энтропией — мерой неопределённости.
Человек протягивает руку незнакомцу на другом конце города. Тот никогда не ответит тем же — они не встретятся. Зачем тогда помогать? Биологи называют это косвенной взаимностью: добро возвращается не от того, кому помог, а от кого-то ещё — по цепочке.
В новой работе столкнули две её разновидности. Первая — помощь «вверх по течению»: я помогаю, потому что мне когда-то помогли.
В водной среде на механическую рыбу воздействуют турбулентные вихри, сбивающие её с курса. Чтобы справиться с этой задачей, был создан ИИ-агент, действующий подобно повару-экспериментатору: он запускал множество симуляций, пробуя различные «рецепты» двигательных паттернов, и итеративно улучшал управляющую программу.
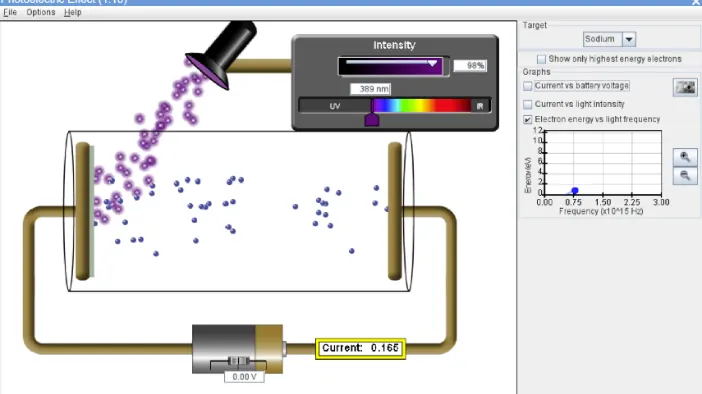
Понять фотоэффект — явление, при котором свет, падая на материал, выбивает из него электроны, — всё равно что учиться готовить без рецепта. На помощь приходят цифровые инструменты: игры дают интуитивное чутьё, симуляции — количественную точность.
Исследователи провели эксперимент с участием 55 студентов, разделив их на две группы.
Кассир в супермаркете в час пик не запоминает каждую пробитую покупку — он держит в голове общую сумму и следит за очередью. Примерно так же мозг распределяет свои силы: дорогая и точная кора (то, что отвечает за обдумывание) и более простые, экономные подкорковые ядра (где живут привычки) работают в паре.
Фотограф снимает ночной лес и пытается поймать в кадр светлячков. Вспышки редкие, слабые, а вокруг — шум ветра и далёкие огни. Примерно так работает огромный детектор Hyper-Kamiokande в Японии: он ловит нейтрино — почти неосязаемые частицы — по крошечным вспышкам света в 260 тысячах тонн воды.