تعلّم الشبكة العصبية على بيانات أقل، لكن بذكاء سريع
البروتينات في الطبيعة كحبات الرمل على الشاطئ، ولكلٍّ منها وظيفته: بعضها يكسر الطعام، وبعضها يبني الخلايا. لكن لفهم ما يفعله بروتين معين بالضبط، يجب دراسته في المختبر — وهذا بطيء ومكلف. تستطيع الشبكات العصبية تخمين وظيفة البروتين من خلال «نصّه» — تسلسل الأحماض الأمينية — لكن تدريبها يتطلب عددًا هائلًا من الأمثلة المصنفة. المشكلة أن البروتينات المصنفة قليلة: مقابل كل بروتين تم التحقق منه في المختبر، هناك مليون بروتين مجهول.
اقترحت مجموعة من الباحثين نهجًا يشبه الطالب الذكي الذي لا يحفظ الكتاب كله، بل يسأل المعلم فقط عن أصعب الأماكن. هذه الطريقة تسمى التعلم النشط: النموذج نفسه يختار البروتينات التي يكون أقل ثقة فيها، ويطلب من خبير بشري أن يمنحها التصنيف الصحيح. ثم يعيد النموذج تدريبه على هذه الأمثلة المختارة. جمع العلماء نظامًا يجمع بين عدة استراتيجيات لاختيار البروتينات «الصعبة» ويسمح للإنسان بالتحقق يدويًا من التوقعات وتصحيحها.
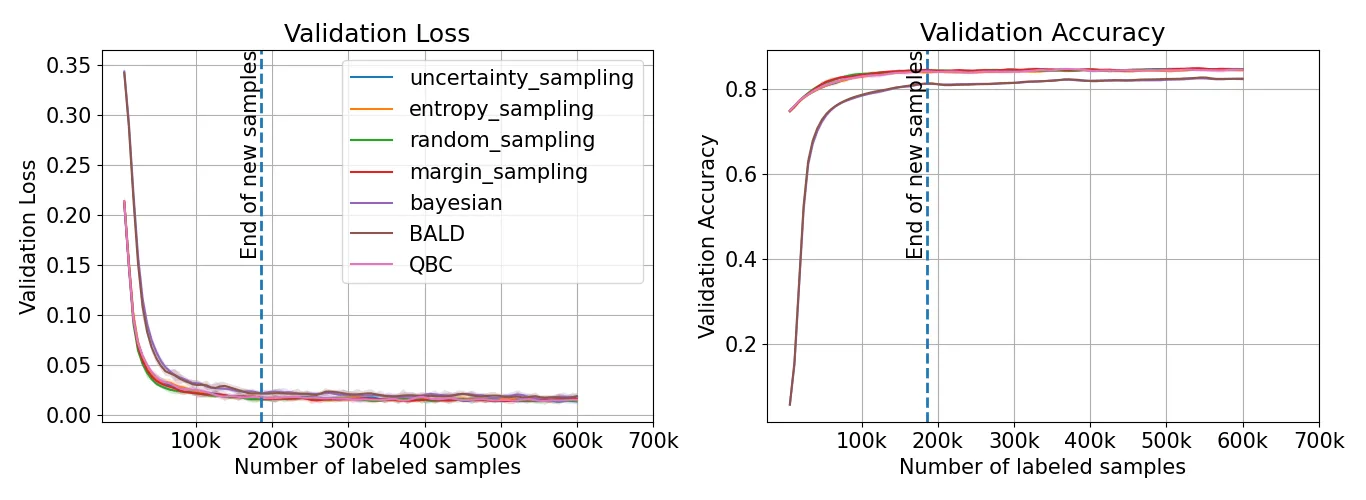
قارنوا النتائج بالتعلم التقليدي، حيث يُغذى النموذج بجميع البيانات دفعة واحدة. اتضح أن التعلم النشط يحقق نفس دقة التوقعات، لكنه يتطلب تحديثات أقل للنموذج، ويعالج بيانات أقل، ويوفر موارد حسابية بشكل ملحوظ. بالنسبة للباحثين، هذا يعني أن دراسة وظائف البروتينات يمكن أن تكون أسرع وأرخص دون فقدان الجودة.
هذا النهج مهم بشكل خاص الآن، حيث تنمو قواعد بيانات تسلسلات البروتين بمعدلات هائلة، بينما لا يواكبها التحقق التجريبي. فبدلاً من انتظار سنوات حتى يُدرس كل بروتين جديد في المختبر، يمكن للعلماء التركيز على المرشحين الأكثر غموضًا والأكثر واعدة. إنه مثل البحث عن الألماس في كومة رمل، لا بغربلة كل شيء، بل فقط الأماكن التي يلمع فيها البريق بالفعل.
الملخص الأصلي
كما كتبه المؤلفون، بالإنجليزية arXiv:2602.23269
Generalizable protein function prediction is increasingly constrained by the growing mismatch between exponentially expanding sequences of environmental proteins and the comparatively slow accumulation of experimentally verified functional data. Active learning offers a promising path forward for accelerating biological function prediction, by selecting the most informative proteins to experimentally annotate for data-efficient training, yet its potential remains largely unexplored. We introduce HATTER (Human-in-the-loop Adaptive Toolkit for Transferable Enzyme Representations), a modular framework that integrates multiple active learning strategies with human-in-the-loop experimental annotation to efficiently fine tune function prediction models. We compare active learning training to standard supervised training for biological enzyme function prediction, demonstrating that active learning achieves performance comparable to standard training across diverse protein sequence evaluation datasets while requiring fewer model updates, processing less data, and substantially reducing computational cost.
أكبر بنك لتسلسلات البروتين يحتوي على مئات الملايين من السجلات، لكن جزءًا صغيرًا جدًا منها فقط تم التحقق منه تجريبيًا — أقل من واحد بالمئة.