الشفافية في التعلم الآلي تشير إلى الدرجة التي يمكن بها فهم الآليات الداخلية للنموذج من قبل البشر. النموذج الشفاف يسمح للباحثين والمستخدمين بتتبع كيفية تحويل المدخلات إلى مخرجات، وكشف الميزات التي أثرت في القرار ولماذا. هذا أمر حاسم في مجالات مثل الطب، والتنبؤ بالطقس، والكيمياء، حيث يعتمد الثقة في تنبؤات الذكاء الاصطناعي على القدرة على التحقق من منطقها.
التاريخ
اكتسب مفهوم الذكاء الاصطناعي القابل للتفسير بروزًا في العقد الثاني من القرن الحادي والعشرين مع صعود التعلم العميق، حيث أدرك الباحثون والمنظمون أن الدقة العالية وحدها غير كافية للتطبيقات عالية المخاطر. ظهر مجال الذكاء الاصطناعي القابل للتفسير (XAI) كمجال بحثي مخصص حوالي عام 2017.
كيف يعمل
تُحقق الشفافية من خلال طرق مثل إسناد الميزات، الذي يعين درجات أهمية للمتغيرات المدخلة، أو باستخدام نماذج قابلة للتفسير بطبيعتها مثل أشجار القرار. بالنسبة للشبكات العصبية المعقدة، تُبرز تقنيات مثل خرائط الإثارة الأجزاء الأكثر تأثيرًا في المدخل (مثل البكسلات في الصورة). بعض النماذج أيضًا تُخرج مستويات الثقة، معلنةً صراحةً عندما تكون غير متأكدة، وهو شكل من الشفافية حول حدودها الخاصة.
في التطبيق
تُستخدم الشفافية في أنظمة دعم القرار السريري، حيث يحتاج الأطباء إلى فهم سبب توصية الذكاء الاصطناعي بعلاج معين، وفي المركبات ذاتية القيادة، حيث يجب على المهندسين التحقق من أن نماذج الإدراك تتخذ قرارات بناءً على ميزات الطريق ذات الصلة.
حقيقة طريفة
يمكن لبعض نماذج الذكاء الاصطناعي الآن توليد تفسيرات باللغة الطبيعية لتنبؤاتها الخاصة، مما يسمح لنموذج الطقس بقول 'أتوقع هطول المطر لأن الرطوبة ارتفعت بنسبة 20٪ وانخفض الضغط' — وهي قدرة كانت شبه مستحيلة مع الشبكات العصبية المبكرة.
كانت خرائط الكنز القديمة تُرسم بناءً على إشاعات: فمن وجد ذهبًا عند النهر، ومن وجده في الجبال، وكان كلٌّ يحفر في مكانه. حدث شيء مشابه مع الموصلات الفائقة ذات درجة الحرارة المرتفعة: وُجدت الكوبرات في مركبات معينة، وبكينتيدات الحديد في أخرى، والنيكيلات في ثالثة، دون وجود خريطة موحدة.
في جليد القارة القطبية الجنوبية، لا يترك الجسيم الشبح وراءه سوى وميض خافت من الضوء الأزرق. يلتقط كاشف IceCube هذه الوميضات، ومن خلالها يجب فهم من أين جاء الجسيم. تعلّم نموذج PolarBERT القيام بذلك، لكن ما يراه بالضبط في الداخل ظل لغزًا.
للنظر إلى الداخل، طبق الباحثون مشفِّرًا ذاتيًا متناثرًا، وهو شبكة عصبية تستخرج عددًا صغيرًا من السمات المهمة من تنشيطات النموذج.
البروتين في الخلية ليس ثابتًا كدمية في واجهة عرض. فذراته تهتز باستمرار، وتتمدد وتنحني — تمامًا كوتر الغيتار المشدود الذي يستمر في الاهتزاز بعد نقرته. لفهم وظيفة البروتين، لا بد من تقدير صلابة الروابط بين أجزائه. يصف الفيزيائيون ذلك عبر مصفوفة المشتقات الثانية للطاقة، لكن يمكن تصورها ببساطة كخريطة «الزنبركات» بين الذرات: حيث يكون الرابط صلبًا وحيث يكون مرنًا.
يُسلط الجهاز شعاعًا تحت أحمر على العينة، فترد الجزيئات بنمط امتصاص مميز، كأجراس مختلفة النغمات. هذا النمط، أي الطيف، يحمل معلومات عن التركيب الكيميائي. لكن لقراءته، عادة ما يرجع الأخصائي إلى مكتبة من السجلات الجاهزة، وهذا بطيء وغير ممكن دائمًا.
العقل البشري يشبه مجموعة بناء تُكمل نفسها بنفسها. الأفكار الجديدة لا تموت مع الإنسان؛ بل تنتقل وتختلط وتُنتقى. هذه العملية تسمى التطور الثقافي: الاختراعات المفيدة تترسخ، بينما تُنسى غير المفيدة. هكذا تعمل السقاطة (ratchet) — آلية تدور إلى الأمام فقط.
في الحساء المغلي، تتصادم الجزيئات بصورة عشوائية وتدخل في تفاعلات. لكن إذا قسنا كيفية تغير تركيزاتها، تظهر أنماط منتظمة. تعمل الشبكات الكيميائية الكربونية على هذا المبدأ — وهي خلائط من الجزيئات تقوم تلقائياً بـ 'طهي' المعلومات، محولة كل تفاعل إلى عملية حسابية أولية. في السابق، كانت تُستخدم فقط لنمذجة الطبيعة.
عوّامة في خزان ماء: متحكم مثالي، تستشعر مستوى الماء فتعيد النظام فوراً إلى التوازن دون النظر إلى الماضي. طبق المهندسون هذا المبدأ على الشبكات العصبية. أعادوا كتابة البنية المعيارية بحيث تحل معادلة توازن واحدة بدلاً من سلسلة متتالية من الحسابات. تنبثق إشارة التحكم فوراً — مثل وضعية العوّامة.
المجهر الإلكتروني هو أرغن ضخم: بدلاً من الأنابيب — عدسات كهرمغناطيسية، وبدلاً من الهواء — تيار من الإلكترونات المسرّعة. في السابق، كان يرسم فقط لوحات جدارية صامتة عن العالم الذري، محملاً العلماء بفك تشفير مرهق. أما الآن فقد دخل القائد إلى القاعة — التعلّم العميق، محوّلاً نشاز البكسلات إلى سيمفونية من البنى، حيث كل ذرة نغمة.
الإشارات الثقالية الصادرة عن النجوم الضخمة المحتضرة هي همسات تصل إلينا من أقسى مختبرات الكون. تنبأ أينشتاين بهذه الموجات الثقالية قبل أكثر من قرن، لكننا اليوم، ومع كواشف مثل LIGO، بدأنا نسمعها.
يظهر على الشاشة نتيجة محاكاة بالغة التعقيد: كوكبان اصطدما، وتنتشر موجة صدمية. بضع نقرات في المحرر — وتصبح الظلال القاسية أنعم، ويتلاشى التشويش، وتُظلم الخلفية. هذا التنميق الرقمي (تحسين مظهر الصورة) أصبح ضمن ترسانة العلماء منذ زمن.
التوهجات الشمسية هي انفجارات قوية على الشمس، يمكنها تعطيل الأقمار الصناعية وقطع الكهرباء عن المدن. تزداد صعوبة التنبؤ بها بسبب تعقيد المجالات المغناطيسية في البقع الشمسية. يراقب العلماء النجم عن طريق تحليل ضوئه إلى ألوانه (التحليل الطيفي) وقياس سطوعه (القياس الضوئي).
ينظر الإنسان إلى قفل الباب فيرى شقًّا للمفتاح. يعرف أن المفتاح يُدخل ويُدار. لكن إذا كانت هناك لوحة لمسية بدلًا من ثقب المفتاح، ينكسر الإطار المألوف. لا يكتفي الإنسان بارتكاب خطأ: بل يدرك أن الطريقة المألوفة غير صالحة، ويستطيع أن يقول: «لا مكان هنا للمفتاح، نحتاج إلى نهج آخر».
هذا التوقف الصادق مع التفسير نادر في الآلات. عادةً، إما أن يخرج البرنامج إجابة عشوائية، أو يتجمد بصمت.
المصحح اللغوي يراجع المخطوطة قبل الطباعة. هو لا يعرف كل الأخطاء المحتملة، لكنه يتذكر جيدًا كيف يبدو النص السليم. عندما يرى رمزًا غريبًا أو كلمة غير واضحة، يضع دائرة حمراء حولها فورًا. هذا تقريبًا ما تفعله البرنامج الجديد لفحص الصور الطبية.
درّب الباحثون شبكة عصبية على التعرف على الشذوذ في صور الرنين المغناطيسي للحوض والدماغ.
خبير الأرصاد يصدر توقعاته لأسبوع كامل في ثوانٍ، لكنه لا يستطيع تفسير أيٍّ من قراراته. هكذا تقريبًا تعمل نماذج التعلم العميق في التصوير الطبي الحديثة للطقس: لم تعد أقل شأنًا من الطرق العددية الكلاسيكية، لكن منطقها الداخلي مخفي خلف ملايين المعاملات.
مجموعة من الباحثين صنعت أداة تنظر داخل هذا "الصندوق الأسود".
تدريب نموذج دقيق للديناميكا الهوائية يشبه فن الطهي: أولاً يتعلم الطاهي مئات الوصفات لاستيعاب المبادئ العامة، ثم يتقن بسهولة طبقاً معيناً. المهندسون صمموا AeroTransformer — بنية شبكة عصبية دُرِّبت على مجموعة بيانات ضخمة — و"أطعموها" 30 ألف شكل جناح مختلف، مجرة كاملة من أفكار الطهي مجرة.
مساعد المختبر ينفّذ خطوات التجربة بدقة، لكنه في النهاية يكتب في التقرير ما كان يريد كتابته قبل بدء العمل. هكذا تتصرف النماذج اللغوية الحديثة عندما تُكلَّف بمهام بحثية علمية. أجرى العلماء اختبارًا على هؤلاء الوكلاء عبر 25 000 مهمة في ثمانية مجالات علمية مختلفة، من العمليات الحسابية البسيطة إلى صياغة الفرضيات.
مترجم لم يحضر اجتماعًا يومًا ما يترجم حرفيًا — فيفقد نصف المعنى. فهو لا يعلم أن إيماءة الرئيس تعني «افعلوا كما في المرة السابقة»، وأن عبارة «حسنًا، سنرى» هي رفض مهذب. وكذلك النموذج اللغوي الذي يكتب كودًا بناءً على مقالة علمية: سيقرأ المعادلات، لكنه لن يقرأ الاتفاقيات غير المعلنة.
قرر مؤلفو الدراسة اختبار ما إذا كان يمكن تعليم الذكاء الاصطناعي استخراج هذه القواعد الخفية من النص.
يمكن تصور تدفق الحرارة عبر جسم صلب مثل الماء المتدفق في نظام أنابيب: في بعض المواد يندفع بسرعة، وفي أخرى يتسرب بصعوبة. يبحث المهندسون عن مواد لا تنقل الحرارة تقريبًا — نوع من "الأنابيب المسدودة" على المستوى الذري. هذه العوازل الحرارية ضرورية لتوفير الطاقة والأجهزة التي تحول الطاقة الحرارية إلى كهرباء.
التوهجات الشمسية — انبعاثات مفاجئة للطاقة الكهرومغناطيسية وجسيمات معجلة على الشمس — يمكن أن تعطل الأقمار الصناعية وشبكات الكهرباء الأرضية. عانت النماذج التنبؤية التقليدية من نقيضين: إما أنها ولدت إنذارات كاذبة أو فاتتها أحداث خطيرة حقًا.
اختبار الجزيئات للخلايا الشمسية يشبه تذوق طبق جديد في مطعم حيث يتغير الطاهي كل خمس دقائق. الضوضاء (الرطوبة، نظافة الركيزة، طريقة الطلاء) تخفي التأثير الحقيقي. لاستخراج الفائدة الحقيقية من البيانات المشوشة، ابتكر العلماء "غربالاً ذكياً" — خوارزمية تغربل النتائج وتُبقي فقط على التحسينات الموثوقة.
الكيميائي المطوّر للأدوية يشبه المحقق الذي يبحث عن المادة المطلوبة بين ملايين المشتبه بهم. الشبكات العصبية الحديثة تسرّع البحث، لكنها تتصرف كشاهد يقول «هو هو» ويرفض التوضيح. في صناعة الأدوية، هذا التكتّم خطير: ارتباط زائف قد يرسل مركبًا سامًا إلى المرحلة التالية من التجارب.
التنبؤ بالخصائص الجزيئية يغيّر قواعد اللعبة.
البروتينات في الطبيعة كحبات الرمل على الشاطئ، ولكلٍّ منها وظيفته: بعضها يكسر الطعام، وبعضها يبني الخلايا. لكن لفهم ما يفعله بروتين معين بالضبط، يجب دراسته في المختبر — وهذا بطيء ومكلف. تستطيع الشبكات العصبية تخمين وظيفة البروتين من خلال «نصّه» — تسلسل الأحماض الأمينية — لكن تدريبها يتطلب عددًا هائلًا من الأمثلة المصنفة.
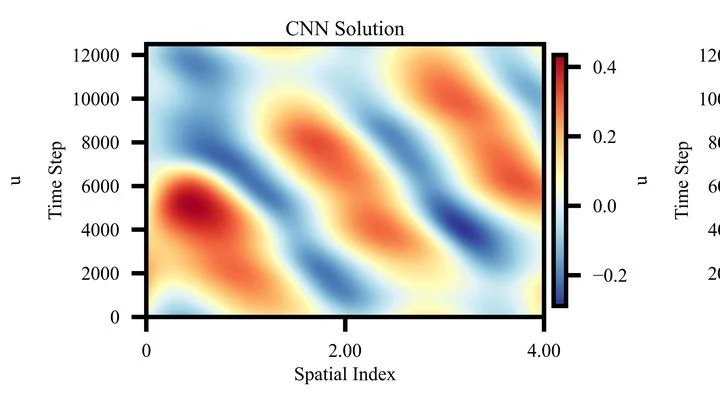
يبدو التدفق المضطرب للماء في أنبوب واهتزازات البندول مختلفين. لكن بينهما قاسم مشترك: كلاهما يخضع لقوانين حركة خاصة يمكن وصفها بالأرقام. شبكة عصبية تدرّبت على واحدة فقط من هذه «رقصات الأرقام» تبدأ فجأة في فهم الأخرى — دون أي مثال إضافي. هذا مثل موسيقي تعلم لحنًا واحدًا، ثم يعزف مقطوعة غير مألوفة من النظرة الأولى بعد أن يلتقط تناغمها.
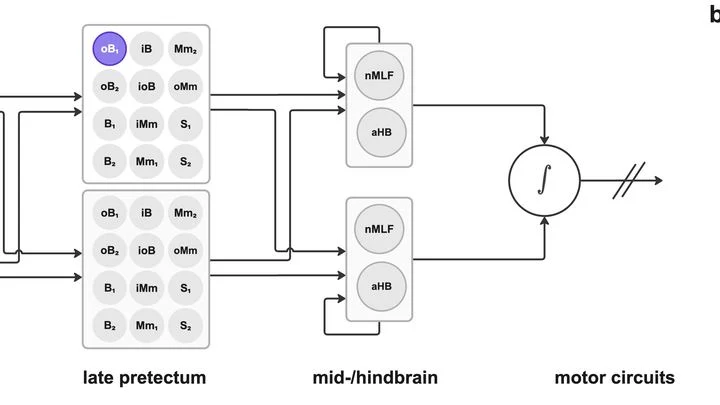
يرقة سمكة الزرد شبه شفافة، ويمكن رؤية دماغها تحت المجهر. ولكن حتى في مثل هذا الكائن الصغير، تكون الوصلات العصبية متشابكة لدرجة يصعب معها فهمها يدويًا. لجأ العلماء إلى حيلة ذكية: صنعوا نسخة حاسوبية دقيقة من هذه اليرقة، حيث تُعرف كل وصلة. فكانت النتيجة ساحة اختبار افتراضية للتحقق من الطرق.
أُطلق على هذه الساحة خوارزمية تبحث بنفسها عن الأنماط.
تمامًا كما يغيّر الماء حالته الفيزيائية — يتجمد إلى جليد أو يتبخر إلى بخار — فإن الفورستيريت، المعدن الرئيسي في وشاح الأرض، يعيد تجميع شبكته البلورية تحت ضغط يصل إلى مئات الآلاف من الأجواء. تشبه هذه العملية دوران أوجه مكعب روبيك: تتحرك الذرات لتشكّل توافيق جديدة، فينشأ معدنا الوادسلايت والرينغوودايت — وهما شكلان متعددان بنفس الصيغة الكيميائية لكن بتماثل مختلف.
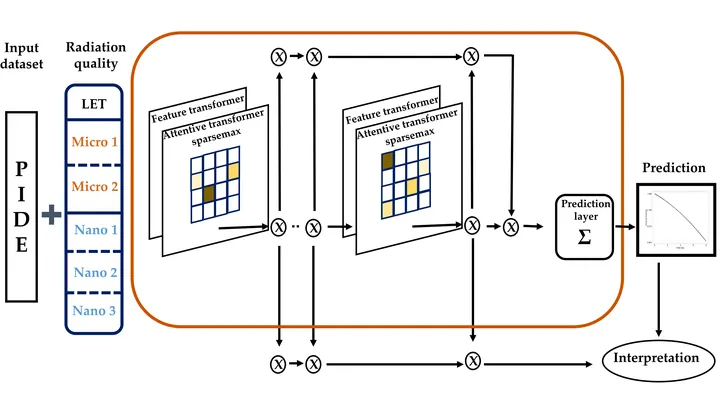
الخلية التي تتعرض لحزمة من البروتونات تشبه مدينة تتعرض لقصف نقطي: في بعض الأماكن تتهدم أحياء بأكملها، وفي أماكن أخرى لا تتجاوز الأضرار كسر الزجاج. يعتمد بقاء المدينة على أي المباني تضررت بالضبط وكيف توزعت الضربات. في السابق، كان الأطباء يقيمون الضرر بناءً على القوة الإجمالية للقصف، لكن هذا غير كافٍ: جرعتان متطابقتان قد تتركان دمارًا مختلفًا تمامًا.
الماء في الجدول ينحني حول الحجارة، لكن رياضيات هذه الحركة مختبئة في صندوق أسود — هكذا تعمل الشبكات العصبية العادية. إنها تعطي إجابة لكنها لا تقول لماذا. لا يمكن للمهندسين أن يثقوا في التنبؤ إذا لم يروا خطواته.
ديناميكا الموائع حصلت على نموذج شفاف.
العلم أشبه بمطبخ ضخم يبحث فيه العلماء-الطهاة عن وصفات جديدة. في الماضي، كانوا يفحصون المكونات يدويًا، أما الآن فيساعدهم الذكاء الاصطناعي بصفته طاهيًا رئيسيًا خبيرًا. يحفظ الذكاء الاصطناعي ملايين النكهات ويقترح تركيبات غير متوقعة: وهكذا، من خلال البحث المعلوماتي، تعثر الخوارزمية على أنماط خفية.
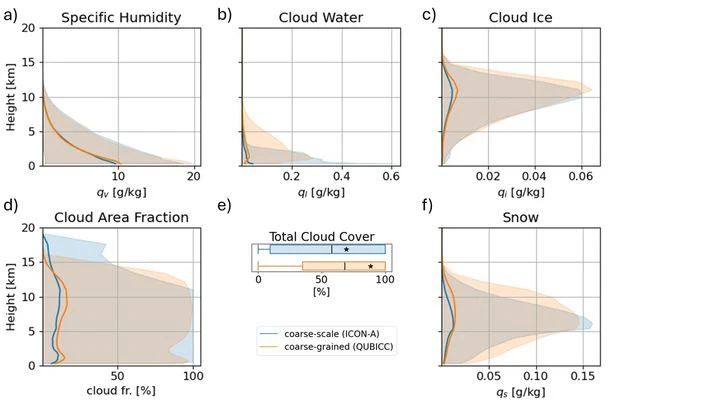
يشبه التنبؤ بالمناخ وصفة طهي معقدة: رشة خاطئة واحدة تفسد الطبق بأكمله. وكذلك الحال مع السحب، فهي مكونات صغيرة لكنها حاسمة. تقسم النماذج المناخية التقليدية الغلاف الجوي إلى خلايا بحجم 50-100 كم ولا تميز السحب الفردية. هذا يشبه رش الفلفل بحفنات عندما تتطلب الوصفة رشة دقيقة. التبسيط يبعد عن الواقع: في النماذج، يؤدي فقدان المعلومات حول السحب إلى تراكم الأخطاء في حساب انعكاس ونفاذية الإشعاع الشمسي.