امتحان لعالم ذكاء اصطناعي سريع
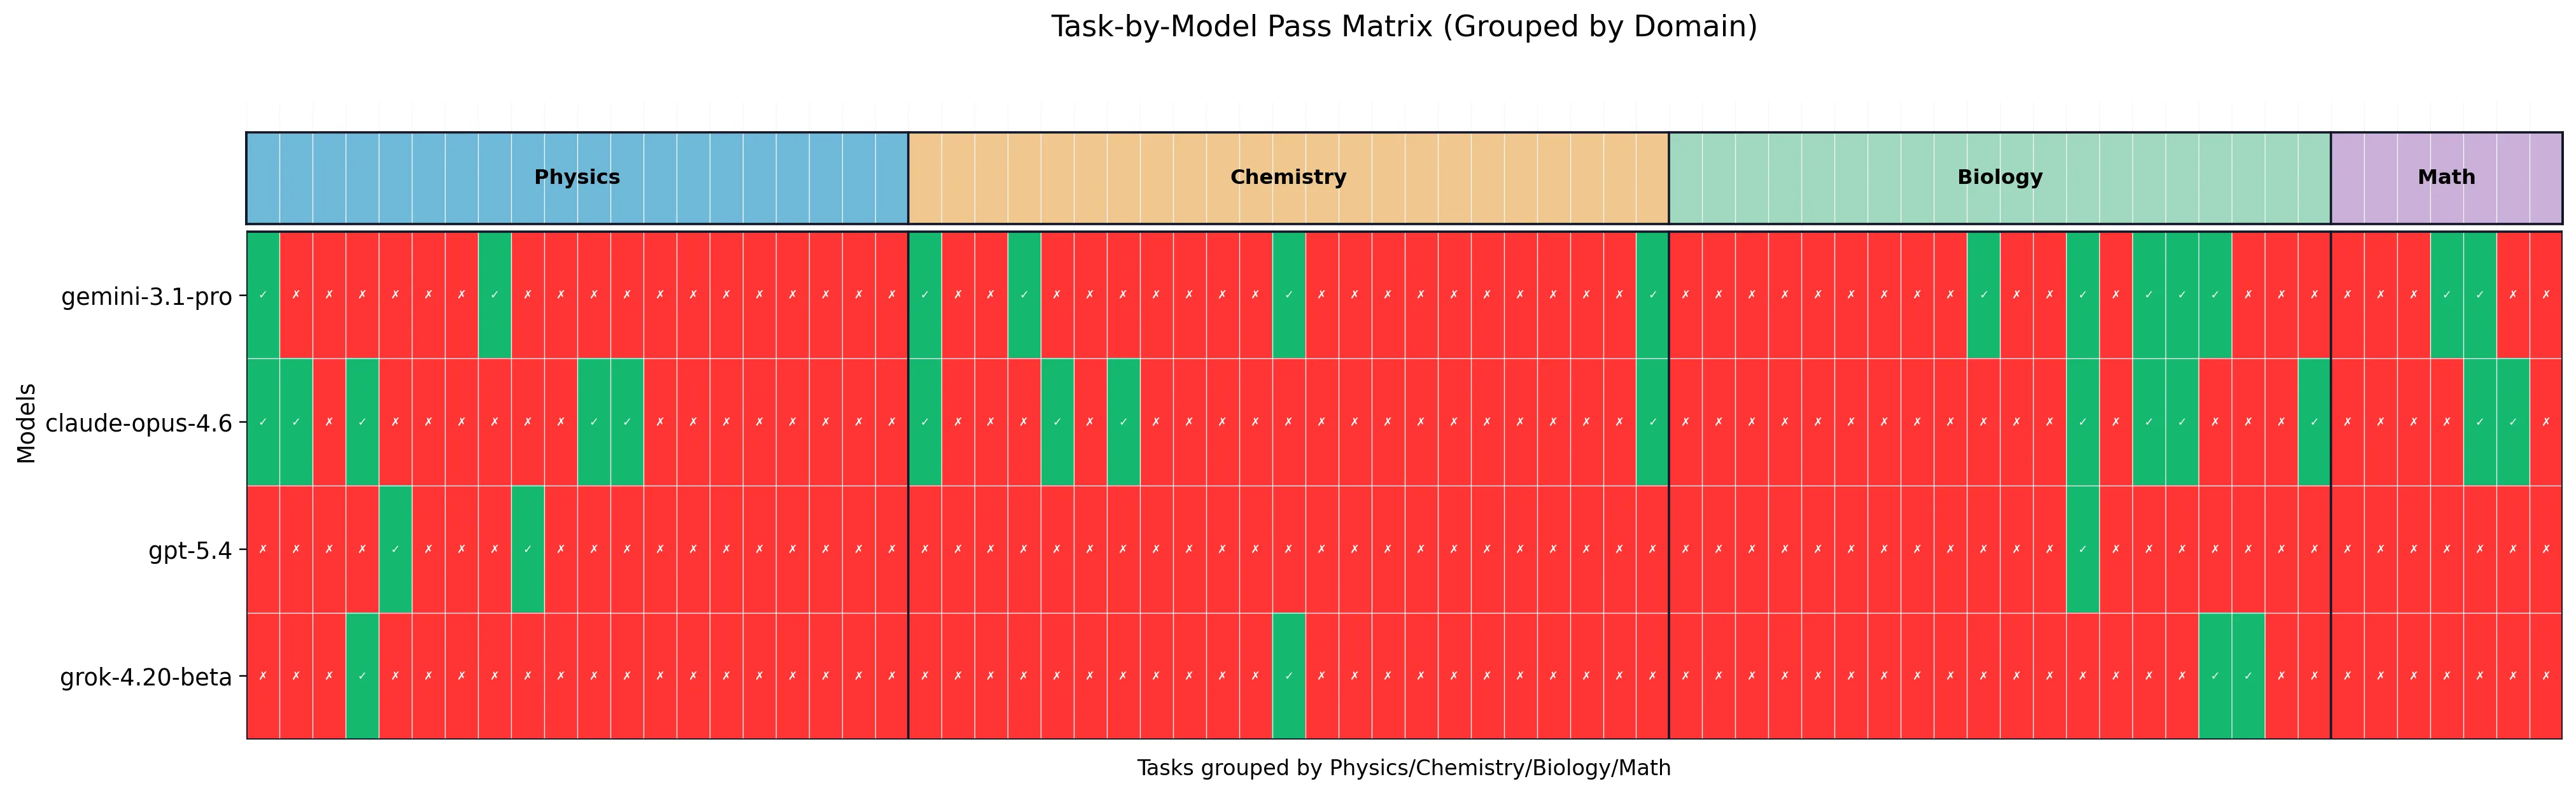
أفضل مساعد ذكاء اصطناعي للعلماء رسب في الامتحان أسوأ من طالب متوسط في اختبار قصير. 21% فقط من الإجابات الصحيحة — وهذا هو سقف أقوى أربعة نماذج. مسائل الاختبار الجديد لم يكتبها مبرمجون، بل طلاب دراسات عليا: أناس يواجهون العلم الحقيقي كل يوم.
سُمي الاختبار COMPOSITE-STEM. يضم 70 مسألة في الفيزياء والأحياء والكيمياء والرياضيات. على عكس مسائل المدارس، لا توجد إجابة واحدة صحيحة — بل يُقيَّم أسلوب التفكير نفسه. على سبيل المثال، لا يكفي حساب رقم، بل يجب شرح سبب اختيار هذه الطريقة. يُصحَّح بطريقتين: مقارنة دقيقة للإجابات، وتحكيم نموذج لغوي آخر.
النتيجة مخيبة للآمال: حتى أفضل نموذج يحل مسألة واحدة فقط من كل خمس. هذا يعني أن الذكاء الاصطناعي ما زال بعيدًا عن أن يكون مساعدًا حقيقيًا للعالم. لكن الاختبار مفتوح للجميع — يمكن لأي مطور اختبار نموذجه ومحاولة تحسين النتيجة.
الملخص الأصلي
كما كتبه المؤلفون، بالإنجليزية arXiv:2604.09836
AI agents hold growing promise for accelerating scientific discovery; yet, a lack of frontier evaluations hinders adoption into real workflows. Expert-written benchmarks have proven effective at measuring AI reasoning, but most at this stage have become saturated and only measure performance on constrained outputs. To help address this gap, we introduce COMPOSITE-STEM, a benchmark of 70 expert-written tasks in physics, biology, chemistry, and mathematics, curated by doctoral-level researchers. Our benchmark combines exact-match grading and criterion-based rubrics with an LLM-as-a-jury grading protocol, allowing more flexible assessment of scientifically meaningful outputs. Using an adapted multimodal Terminus-2 agent harness within the Harbor agentic evaluation framework, we evaluate four frontier models. The top-performing model achieves 21%, demonstrating that COMPOSITE-STEM captures capabilities beyond current agent reach. All tasks are open-sourced with contributor permission to support reproducibility and to promote additional research towards AI's acceleration of scientific progress in these domains.
جُمعت مسائل الاختبار من طلاب الدراسات العليا — أولئك الذين ما زالوا يتذكرون كيف يكون الجلوس أمام معادلة حتى منتصف الليل والشك في كل خطوة.