التعرف على الكلام هو التقنية التي تمكّن الآلات من تحويل اللغة المنطوقة إلى نص أو أوامر. يتضمن تحليل الإشارات الصوتية، واستخراج الخصائص الصوتية، وربطها بالوحدات اللغوية مثل الفونيمات والكلمات. تستخدم الأنظمة الحديثة شبكات عصبية عميقة مدرّبة على كميات هائلة من بيانات الكلام لتحقيق دقة تقترب من دقة الإنسان، حتى في البيئات المزعجة أو مع اللهجات المتنوعة.
التاريخ
المحاولات المبكرة في الخمسينيات استخدمت مطابقة الأنماط البسيطة للأرقام. تقدم المجال مع نماذج ماركوف المخفية في الثمانينيات، لكن الاختراق جاء في العقد 2010 عندما حل التعلم العميق محل النماذج الصوتية التقليدية، مما حسن الدقة بشكل كبير.
كيف يعمل
تبدأ العملية برقمنة شكل الموجة الصوتية وتقسيمه إلى إطارات قصيرة (مثل 25 مللي ثانية). لكل إطار، تُستخرج خصائص مثل معاملات التردد الميلية (MFCCs)، التي تلتقط الشكل الطيفي للصوت. تُغذى هذه المتجهات المميزة إلى شبكة عصبية — غالبًا بنية متكررة أو محول — تُخرج احتمالات على الفونيمات أو الحروف الممكنة. ثم يجمع نموذج لغوي هذه الاحتمالات مع القيود اللغوية لإنتاج تسلسل النص الأكثر ترجيحًا. النماذج الحديثة من البداية إلى النهاية (مثل Whisper وDeepSpeech) تتعلم التعيين الكامل من الصوت إلى النص مباشرة، متجاوزةً المحاذاة الصوتية الصريحة.
في التطبيق
التعرف على الكلام يشغل المساعدين الافتراضيين (Siri، Alexa)، وخدمات النسخ الآلي، والأجهزة التي تُتحكم بالصوت، والترجمة الفورية للنصوص للمعاقين سمعيًا.
حقيقة طريفة
أنظمة التعرف على الكلام الحديثة حساسة جدًا لدرجة أنه يمكن خداعها بأوامر فوق صوتية غير مسموعة مخبأة في التسجيلات الصوتية، وهي ثغرة أمنية اكتُشفت في عام 2017.
في ثمانينيات القرن العشرين، وضعت مسابقة DARPA للتعرف على الكلام حدًا للجدل بين الأساليب الإحصائية والقواعد المكتوبة يدويًا، ووضعت معيارًا موحدًا للمجال بأكمله. أما بالنسبة للواجهات العصبية الكلامية التي تترجم النشاط الدماغي إلى كلمات، فلم يكن هناك حتى الآن مثل هذا المعيار المشترك: كل نظام يستخدم مفرداته الخاصة، وطريقته في التسجيل، ونوع الكلام.
يمكن تخيل الدماغ كأوركسترا، حيث القائد هو قشرة المخ، والمهاد هو الكمان الأول. المهاد هو محطة ترحيل مركزية: يستقبل الإشارات الحسية، بما في ذلك الإشارات البصرية من العينين، وينقلها إلى مناطق القشرة المناسبة، مثل القشرة البصرية. لكن الاتصال ليس باتجاه واحد: فالقشرة قادرة على إرسال أوامر عائدة، لضبط المهاد وفقًا للمهمة الحالية. ظل هذا فرضية لفترة طويلة، لكنه الآن اختُبر لأول مرة على البشر.
البحث عن مادة جديدة يشبه التجارب في المطبخ دون وصفة: تجرب وتجرب، وفي الغالب تتخلص من النتيجة. في السابق، كان العلماء يطالعون المقالات العلمية يدويًا ويختبرون التركيبات واحدة تلو الأخرى. الآن ظهر «طاهٍ آلي» يقرأ الأدبيات بنفسه، ويخلط المكونات، ويحلل النتيجة.
مخطط الدماغ المغناطيسي — جهاز يشبه خوذة مزودة بمئات المستشعرات — يلتقط المجالات المغناطيسية الضعيفة التي تولدها الخلايا العصبية أثناء عملها. عندما يستمع الشخص إلى كلام، تختبئ في هذه الإشارات بصمات الكلمات المسموعة. لكن استخراجها ليس بالأمر السهل: فالإشارة القادمة من آلاف المصادر تندمج في كتلة متشابكة.
كل صباح، تُوجّه عشرات التلسكوبات نحو الشمس. تلتقط كاميراتها شريطًا ضيقًا من الضوء الأحمر — خط Hα، الذي اكتشفه Johann Jakob Balmer. تظهر في الصور خيوط داكنة، منحنية بأشكال بديعة. إنها أشبه بغرز نسيج ضخم يخيط الهالة المتوهجة. هذه هي الخيوط الشمسية. أقواس كثيفة من البلازما، تحوم فوق دروز مغناطيسية خفية.
العقل البشري يشبه مجموعة بناء تُكمل نفسها بنفسها. الأفكار الجديدة لا تموت مع الإنسان؛ بل تنتقل وتختلط وتُنتقى. هذه العملية تسمى التطور الثقافي: الاختراعات المفيدة تترسخ، بينما تُنسى غير المفيدة. هكذا تعمل السقاطة (ratchet) — آلية تدور إلى الأمام فقط.
الفنان يرسم بسرعة بالفحم — ويصبح الوجه في الصورة معروفًا. علماء الفيزياء الفلكية يواجهون مشكلة مشابهة: الطيف النجمي هو صورته الفردية، تكشف درجة الحرارة والتركيب وقوة الجاذبية. حتى وقت قريب، كانت هذه الصورة تتطلب «رسمًا زيتيًا» متقنًا — كود الانتقال الإشعاعي (radiative transfer) في ظروف الخروج عن التوازن الحراري المحلي (non-LTE).
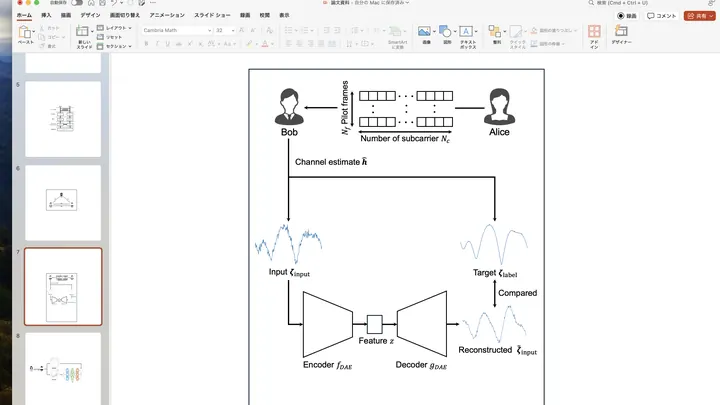
عندما يحاول هاتفان إنشاء مفتاح سري مشترك من الخصائص العشوائية لموجات الراديو، تجعل التداخلات قياساتهما غير دقيقة. الأمر أشبه بشخصين ينظران إلى انعكاس في نافذة ضبابية: يرى كلٌّ منهما ظلاً مشوشاً، ويتعذر تمييز الصورة العامة.
يأتي المُشفِّر التلقائي للإنقاذ — برنامج قابل للتعلم يزيل الضوضاء، مثل قطعة قماش تمسح الزجاج.
يحتاج الطيار في القتال إلى فهم فوري للهدف ونواياه. تنتظر الأنظمة التقليدية بيانات الرادار الكاملة، تمامًا مثل حارس المرمى الذي لا يتفاعل إلا بعد التسديدة. تعمل الخوارزمية الجديدة كحارس مرمى خبير: من خلال الحركات الأولى للمهاجم، تتنبأ بمناورة الهدف.
تجمع الخوارزمية الإشارات المتقطعة وتُحسّن الاستنتاج تدريجيًا.
تتصرف إشارات الراديو في الأماكن المغلقة مثل الموجات الصوتية في قاعة الحفلات: إذ تنعكس مرارًا وتكرارًا عن الجدران والأثاث والأسطح الأخرى، فتشكل نمط تداخل فريدًا — وهو بمثابة «لحن» صامت لكل مكان. الهاتف الذكي المزود بجهاز استقبال، وكأنه أذن حساسة، يسجل هذا النمط من خلال تحليل التداخلات وتشوهات الإشارة.
يستخلص الإنسان دون عناء الصوتَ المطلوب من جلبة الحفل. أما بالنسبة للحاسوب، فما زال الأمر في حدود المستطاع. كانت البرامج السابقة تتدرب على تسجيلات عقيمة، لا صدى فيها ولا طنين أجهزة. لكنّ الحوار الحقيقي يشبه تيارًا عارمًا: المتحاورون يقاطعون، ويبتعدون عن الميكروفون، وفي الخلفية أزيز ماكينة القهوة.
مسابقة REAL-TSE الجديدة ترمي بصنارتها لأول مرة في هذه المياه العكرة.
الذكاء الاصطناعي الذي يتنبأ بصوتيات قاعة ما يشبه طالباً في امتحان يحفظ الإجابات دون فهم. إذا كانت نقاط الفحص هي نفسها نقاط التدريب، يقوم النموذج ببساطة بحفظ "البصمة" الصوتية لكل موضع – كطالب يتعرف على ورقة الأسئلة من ثنية صغيرة فيها. شَدِّد القواعد – جمِّع البيانات حسب المواقع وأخفِ الدلائل الترددية – وستنهار الدقة من 85% إلى 9–57%.
النماذج التي تحول النص إلى صوت تتقن إعادة إنتاج الأصوات المنفردة، لكنها تحتار عندما يتضمن السيناريو عدة أحداث. على سبيل المثال، وفقًا للسيناريو يأتي رنين الجرس أولاً، ثم خطوات الأقدام، ثم صوت إغلاق الباب. قد يعيد المولد ترتيب الأحداث، فيسمع المستمع خطوات الأقدام قبل رنين الجرس.
وجد الباحثون حلاً غير متوقع: بدلاً من برمجة قواعد معقدة، أخذوا شبكة عصبية 'تفهم' الصوت، وجعلوها مراقبًا صارمًا.
الإشارة الراديوية ذات التشكيل الطبقي — تخيل عدة تدفقات معلومات مستقلة متراكبة فوق بعضها — تشبه الطبقة الثقافية لمدينة قديمة. كل مستوى يحمل قصته الخاصة، لكن مع مرور الوقت، وتحت تأثير التشويش والتحريفات، تختلط في فوضى عارمة. الخوارزميات التقليدية لفك التشكيل تضيع في هذا الخليط، عاجزة عن فصل الطبقات.
حكّام الكلام الآليون هم خوارزميات تُقيّم النطق والعواطف. لكنهم غالبًا ما يعملون كناقد طعام يُصدر حكمه بعد قراءة القائمة دون تذوّق الطبق. فبدلاً من تحليل الصوت، يتشبث النموذج بالمؤشرات النصية — كما لو كان يحكم على طبق من خلال وصفتها لا مذاقها. أظهرت التجارب أنه إذا قمت ببساطة بتبديل تسجيلين صوتيين، فإن حكم الذكاء الاصطناعي يغيّر درجته، رغم بقاء الصوت كما هو.
إن إتقان لغة أجنبية يشبه ضبط آلة موسيقية. تعمل التقنية الجديدة كموالف ذكي: فهي تستقبل تسجيلك الصوتي وخطاب الناطق الأصلي المرجعي، ثم تمدد أو تضغطهما زمنيًا بشكل ديناميكي — تمامًا كما تُشدّ أوتار الآلة لمطابقة النغمات بدقة — لمحاذاة الإشارات بشكل مثالي، وتقيّم ثلاثة معايير رئيسية: نقاء الأصوات (النطق)، والدقة الإيقاعية، والمنحنى التنغيمي.
الدماغ يتحدث عبر طقطقات كهربائية قصيرة. في السابق، لتعلم هذه اللغة، كانت هناك حاجة إلى آلاف الأمثلة المترجمة من قبل المجرِّب. طريقة MOJO تسلك مسارًا مختلفًا: كما يحدث عند تعلم لغة عن طريق الانغماس، فهي أولاً 'تستمع' إلى 'تيار الوعي' دون أي تلميحات وتجد بنفسها الأنماط المتكررة.
غالباً ما تشبه المساعدات الصوتية طبّاخاً يقرأ وصفة من ورقة دون ذرة شهية. أرشيف الحوارات الروسية الجديد 'ديالوغي' يغيّر القواعد: ثلاثة ممثلين في الاستوديو، مثل طهاة ماهرين، مزجوا 20 ساعة من المحادثات الحية باثنتي عشرة 'تابلة' عاطفية. حصلت كل جملة على وسم للأسلوب والعاطفة – فتشكّل كتاب نكهات متكامل.
من الملائم تمثيل الإشارة الصوتية بعدد مركب: معامله (السعة) يعكس شدة الصوت، ووسيطه (الطور) يحدد موضع الموجة في الزمن وإزاحتها اللحظية. الشبكات العصبية التقليدية تقسم هذا الوصف الموحد إلى إحداثيين مستقلين – ببساطة، تحدد عنوانًا في شبكة ديكارتية: «خطوتان شرقًا وخطوة شمالًا».
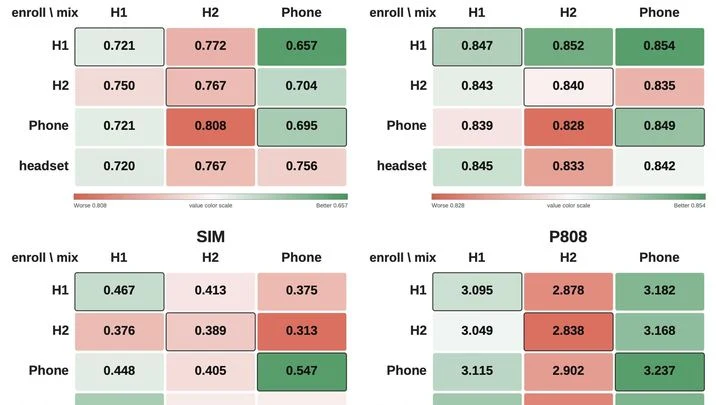
تشبه أجهزة السمع التقليدية طاهياً يطبخ بوصفة وهو مغمض العينين. تحلل الفوضى الصوتية الفوضى القادمة من الميكروفون، وبناءً عليها تضخّم الكلام. في مقهى صاخب، كثيراً ما يخطئ هذا الأسلوب. يتصرّف النظام الجديد كطاهٍ خبير: يعالج الإشارة أولاً ثم يتذوق النتيجة. إن لم يكن الكلام نقياً، يعدّل الإعدادات، مثل إضافة الملح إلى حساء جاهز.
في غرفة صاخبة، يميز الإنسان الصوت المطلوب بفضل الأذنين اللتين تلتقطان الفرق في وصول الصوت. يعمل الكمبيوتر المزود بعدة ميكروفونات بالطريقة نفسها: يحصل على تلميحات مكانية — من أين يتحدث كل شخص.
في السابق، كانت هذه التلميحات تُستخدم للتركيز على اتجاه واحد، مثل شعاع المصباح. لكن عند تداخل الأصوات، كان التركيز يتشتت ويُفقد جزء من الإشارة — كما لو كنا نحاول رؤية ممثلَين في نفس شعاع الكشاف دفعة واحدة.
الأذن البشرية مصممة بحيث يبرز الدماغ في المقام الأول الأنماط المألوفة — صوت المحاور، وصوت المطر، وإشارة السيارة. لكن النظام الجديد يعمل بمبدأ مختلف: فهو يسجل أي طفرة صوتية، حتى تلك التي لم تُسمع من قبل. يُسمى هذا النهج بالتدوين الصوتي (audio diarization) — وهو ليس مجرد البحث عن ضوضاء محددة، بل تقسيم التسجيل الصوتي بأكمله إلى مقاطع مع تحديد واضح لبداية ونهاية كل حدث صوتي.
الشبكة العصبية التي تولد الأصوات من النصوص تشبه مطبخاً يحضّر فيه عشرات الطهاة كل «طبق». كثير منهم لا يضيفون شيئاً سوى الإشارات الخاطئة وإهدار الموارد. أجرى العلماء مراجعة: باستخدام مطيافية (تحليل طيف المعلمات) حددوا من هو ضروري حقاً، واستغنوا عن الزائدين — بإزالة الوصلات غير المفيدة. بعد هذا التنظيف، تخلص النموذج من 83% من معلماته وأصبح يعمل أسرع بنسبة 39%.
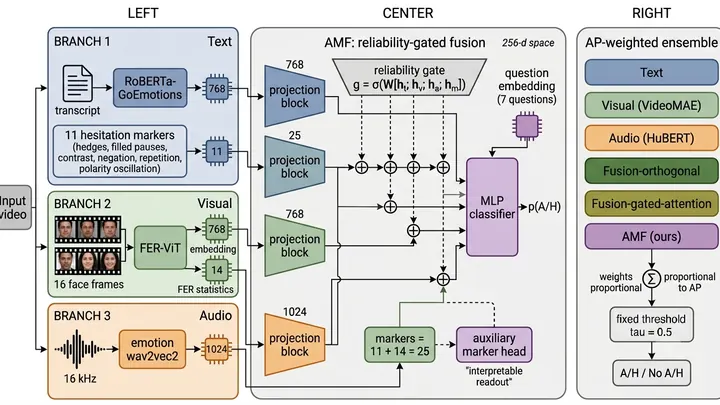
يقوم نظام جديد بتحليل مقابلة قصيرة للتعرف على شكوك الشخص، من خلال دمج النص والصوت وتعابير الوجه. لكن المفتاح الرئيسي لعدم اليقين كان المادة المظلمة للكلام - التوقفات وكلمات الحشو التي تُمحى من أنظمة الكلام القياسية كما يمحو الثقب الأسود كل شيء. هذه الفجوات، التي تُعتبر عادةً نفايات، قدّمت الإشارة غير اللفظية الأكثر استقلالية.
عوّامة في خزان ماء: متحكم مثالي، تستشعر مستوى الماء فتعيد النظام فوراً إلى التوازن دون النظر إلى الماضي. طبق المهندسون هذا المبدأ على الشبكات العصبية. أعادوا كتابة البنية المعيارية بحيث تحل معادلة توازن واحدة بدلاً من سلسلة متتالية من الحسابات. تنبثق إشارة التحكم فوراً — مثل وضعية العوّامة.
تنظيف الكلام من الضوضاء يشبه محاولة ضبط تلفاز قديم: بمجرد أن تُفرط في تدوير مقبض التباين، تصبح الوجوه غير طبيعية. تمكن الباحثون من ضبط «الجهارة» و«الإزاحة الزمنية» لكل تردد صوتي على حدة، كما لو قاموا بتفكيكه إلى ألوان قوس قزح – وهي طريقة تُعرف باسم التحليل الطيفي. واتضح أن المقبض الأساسي هو الجهارة، وليس تزامن الطور.
شبكة عصبية كبيرة، مثل Whisper، التي تتقن مئات اللغات، تشبه النموذج القياسي في فيزياء الجسيمات الأولية — نظامًا متناسقًا حيث كل شيء في توازن دقيق. ولكن بمجرد البدء في تدريبها على لغة نادرة، ينهار هذا التوازن: تتحول اللغة المستهدفة إلى ثقب أسود — منطقة تجذب بلا هوادة جميع موارد التدريب.
النهج القياسي لرقمنة الكلام، الذي يقوم عليه النموذج القياسي للاتصالات الحديثة، هو أخذ عينات مباشر: آلاف المرات في الثانية يتم تسجيل شدة الإشارة اللحظية. تخيل أنك تتذوق المرق بملعقة صغيرة — كل رشفة تعطي لمحة خافتة عن الطعم، ولإدراك النكهة الكاملة عليك أن تغرف مرارًا وتكرارًا. وهكذا هنا: تتدفق البيانات وتتضخم، رغم أن الحمل الدلالي فيها ضئيل.
في قاعة المحكمة — سلسلة مقدَّمة كمدخل. اثنا عشر محلفًا (مسارات حسابية) يدرسونها رمزًا رمزًا. يمكن لكل منهم أن يصدر حكمًا بـ «مذنب» (يقبل) أو «غير مذنب». بالنسبة للآلة المحدودة غير القطعية (NFA) يكفي صوت واحد بـ «نعم». لكن في محكمة الفرق المتماثل (XNFA) يُصدر الحكم بناءً على الفردية: إذا كان عدد الأصوات بـ «مذنب» فرديًا — تُقبل الكلمة.
مئة وعشرون ساكنًا في مونتيلاغو ليسوا بشرًا، بل شخصيات رقمية. لكل منهم، بالإضافة إلى الاسم والسيرة الذاتية، ثلاثة إحداثيات مخفية: الثقة في السلطات البلدية، تقييم مصداقية المصدر، مدى ملاءمة المعلومات المدركة. هذه الأرقام معروفة للمبدعين، ولكن ليس للنظام نفسه.
النماذج الإحصائية هي محاولة لمد شبكة رياضية مثالية على تضاريس البيانات غير المنتظمة. عندما يقاوم النموذج، يصدر توترًا، لكننا اعتدنا تجاهله. يقضي الباحثون ساعات محدقين في رسوم البواقي محاولين تخمين حيث يبدأ النموذج في "التفكك". سكويلر يحوّل هذه المقاومة إلى صوت. لم تعد تنظر إلى منحنًى — بل تسمع صريره عندما يُجبر على الانصياع لنقاط بعينها.
تحكي لصديقك قصة، فيبدو دماغه وكأنه يضبط على موجتك — تنشط نفس المناطق في إيقاع كلماتك. سجّل العلماء هذا "التزامن العصبي" باستخدام تخطيط الدماغ المغناطيسي (جهاز يلتقط المجالات المغناطيسية للدماغ) وقرروا اختبار ما إذا كان نموذج اللغة الحاسوبي قادرًا على تكرار هذه الرقصة من المعاني.
كاميرا الهاتف الذكي تصور كل شيء دون تمييز، بينما العين تركز فورًا على المهم. الشبكية لا تنقل الصورة إلى الدماغ فحسب، بل تقوم في مكانها بإبراز الحواف، وتخفيف الضوضاء الزائدة، والتكيف مع السطوع. لطالما حاول المهندسون تكرار هذه الحيلة في عتاد «ذكي» لتستهلك الكاميرات طاقة أقل وتتخذ قرارات أسرع.
في أنبوب الاختبار تسبح الجزيئات. كميتها — لنقل تركيز بروتين معين — تصبح الإشارة الداخلة. وعلى المخرج لا نريد مجرد محلول عكر، بل إجابة واضحة مثل "نعم" أو "لا".
يُقيم مؤلفو العمل سلسلة كيميائية تفعل ذلك بالضبط. تستقبل مادة واحدة بتركيز يتراوح بين الصفر والواحد، وتُخرج سلسلة من النبضات — مثل شيفرة مورس، لكن كيميائية. كل نبضة تعني "تشغيل"، وغيابها يعني "إيقاف".
القمر الصناعي MethaneSAT يرصد تسريبات الميثان — وهو غاز غير مرئي للعين البشرية لكن له تأثير احتباس حراري قوي. أداته الرئيسية هي المطياف (spectrometer)، وهو جهاز يسجل أدق التغيرات في طيف الضوء المار عبر الغلاف الجوي. جزيئات الميثان تمتص الضوء عند أطوال موجية محددة، تاركة «بصمة» مميزة يلتقطها المطياف.
ترسم اليد في الهواء كلمة «ماما» — أقواس وخطوط مألوفة. والدماغ في هذه الأثناء لا يستعرض صورة كل حرف، بل يشغّل سلسلة من الحركات البسيطة. اختبر مهندسو الأعصاب هذه الفكرة: الكتابة الذهنية ليست معرضًا للصور الجاهزة، بل مجموعة تركيب من «لبنات» حركية متكررة.
في التجربة، زُرعت في أدمغة المتطوعين غرسات داخل القشرة الدماغية — أجهزة استشعار دقيقة داخل الدماغ مباشرة. كانوا يكتبون حروفًا لاتينية ذهنيًا.
الطيف هو مثل صورة فوتوغرافية للبنية الداخلية للمادة، تُلتقط بالضوء. عندما يمر شعاع عبر العينة أو ينعكس عنها، تترك الجزيئات على هذه الصورة خطوطًا داكنة مميزة — القمم. ولكن إذا كانت الصورة معرّضة للضوء بشكل زائد أو مغطاة بحجاب رمادي، يكاد يكون من المستحيل تمييز التفاصيل.
رسام يرسم لوحة وهو يراقب المشاهد في القاعة. إذا ابتسم المشاهد، يضيف الرسام إلى اللوحة مزيدًا من الأحمر والخطوط المستديرة، وإذا عبس، يزيل الأزرق ويكسر الزوايا. تقريبًا بهذه الطريقة، «يستجوب» علماء الأعصاب الخلايا العصبية في القشرة البصرية، لكن بدل الألوان يستخدمون مئات الآلاف من الصور، وبدل الابتسامة يستخدمون نبضة كهربائية.
تُعزف نغمة — ولا يكتفي الدماغ بالاستماع إلى النوتة تلو الأخرى. إنه يعمل كقائد أوركسترا يعرف النوتة مسبقًا: كل نغمة تالية متوقعة لأن النغمات السابقة لا تزال تتردد في الذاكرة. ولكن كيف تحتفظ الخلايا العصبية بهذا الصدى؟ في مقال جديد، يُقترح نموذج لتذبذبات الشبكات العصبية النبضية PCL+ — وهي شبكة تنتقل فيها الإشارات عبر دفعات قصيرة، كما في الدماغ الحقيقي.
في كل مرة تتردد فيها قبل خطوة محفوفة بالمخاطر — سواء استثمار المال في الأسهم أم الانتظار — يدور في رأسك حوار داخلي. عادةً يحاول العلماء إعادة بناء مسار هذا الحوار من الاختيار النهائي وحده، كما لو أن محققًا يحاول إعادة بناء محادثة بين شخصين بالنظر إلى صورة لمكان اللقاء. غالبًا ما تكون هذه الصورة ناقصة: فالأفعال المتطابقة قد تنبع من أفكار مختلفة تمامًا.
اقترح مؤلفو الدراسة تسجيل الحوار نفسه.