El cielo radio a hombros de voluntarios: cómo la ciencia ciudadana enseña a la IA a ver galaxias complejas ✛
Contexto
La nueva generación de radiotelescopios de gran campo, como ASKAP, recopila en una sola noche datos sobre millones de fuentes. Los algoritmos automáticos manejan bien los objetos compactos, pero fallan ante estructuras extendidas con morfologías peculiares: chorros, puentes, burbujas. En torno a este desafío ya se ha formado toda una línea de investigación: algunos grupos buscan señales de radio de origen tecnológico, otros construyen mapas de cientos de miles de galaxias con redes neuronales, y otros captan el resplandor fantasma en los bordes de los cúmulos. El trabajo de RGZ EMU se sitúa al margen: no descubre nuevas fuentes, sino que crea etiquetas de referencia sin las cuales todos esos mapas y búsquedas quedarían en bruto.
Métodos
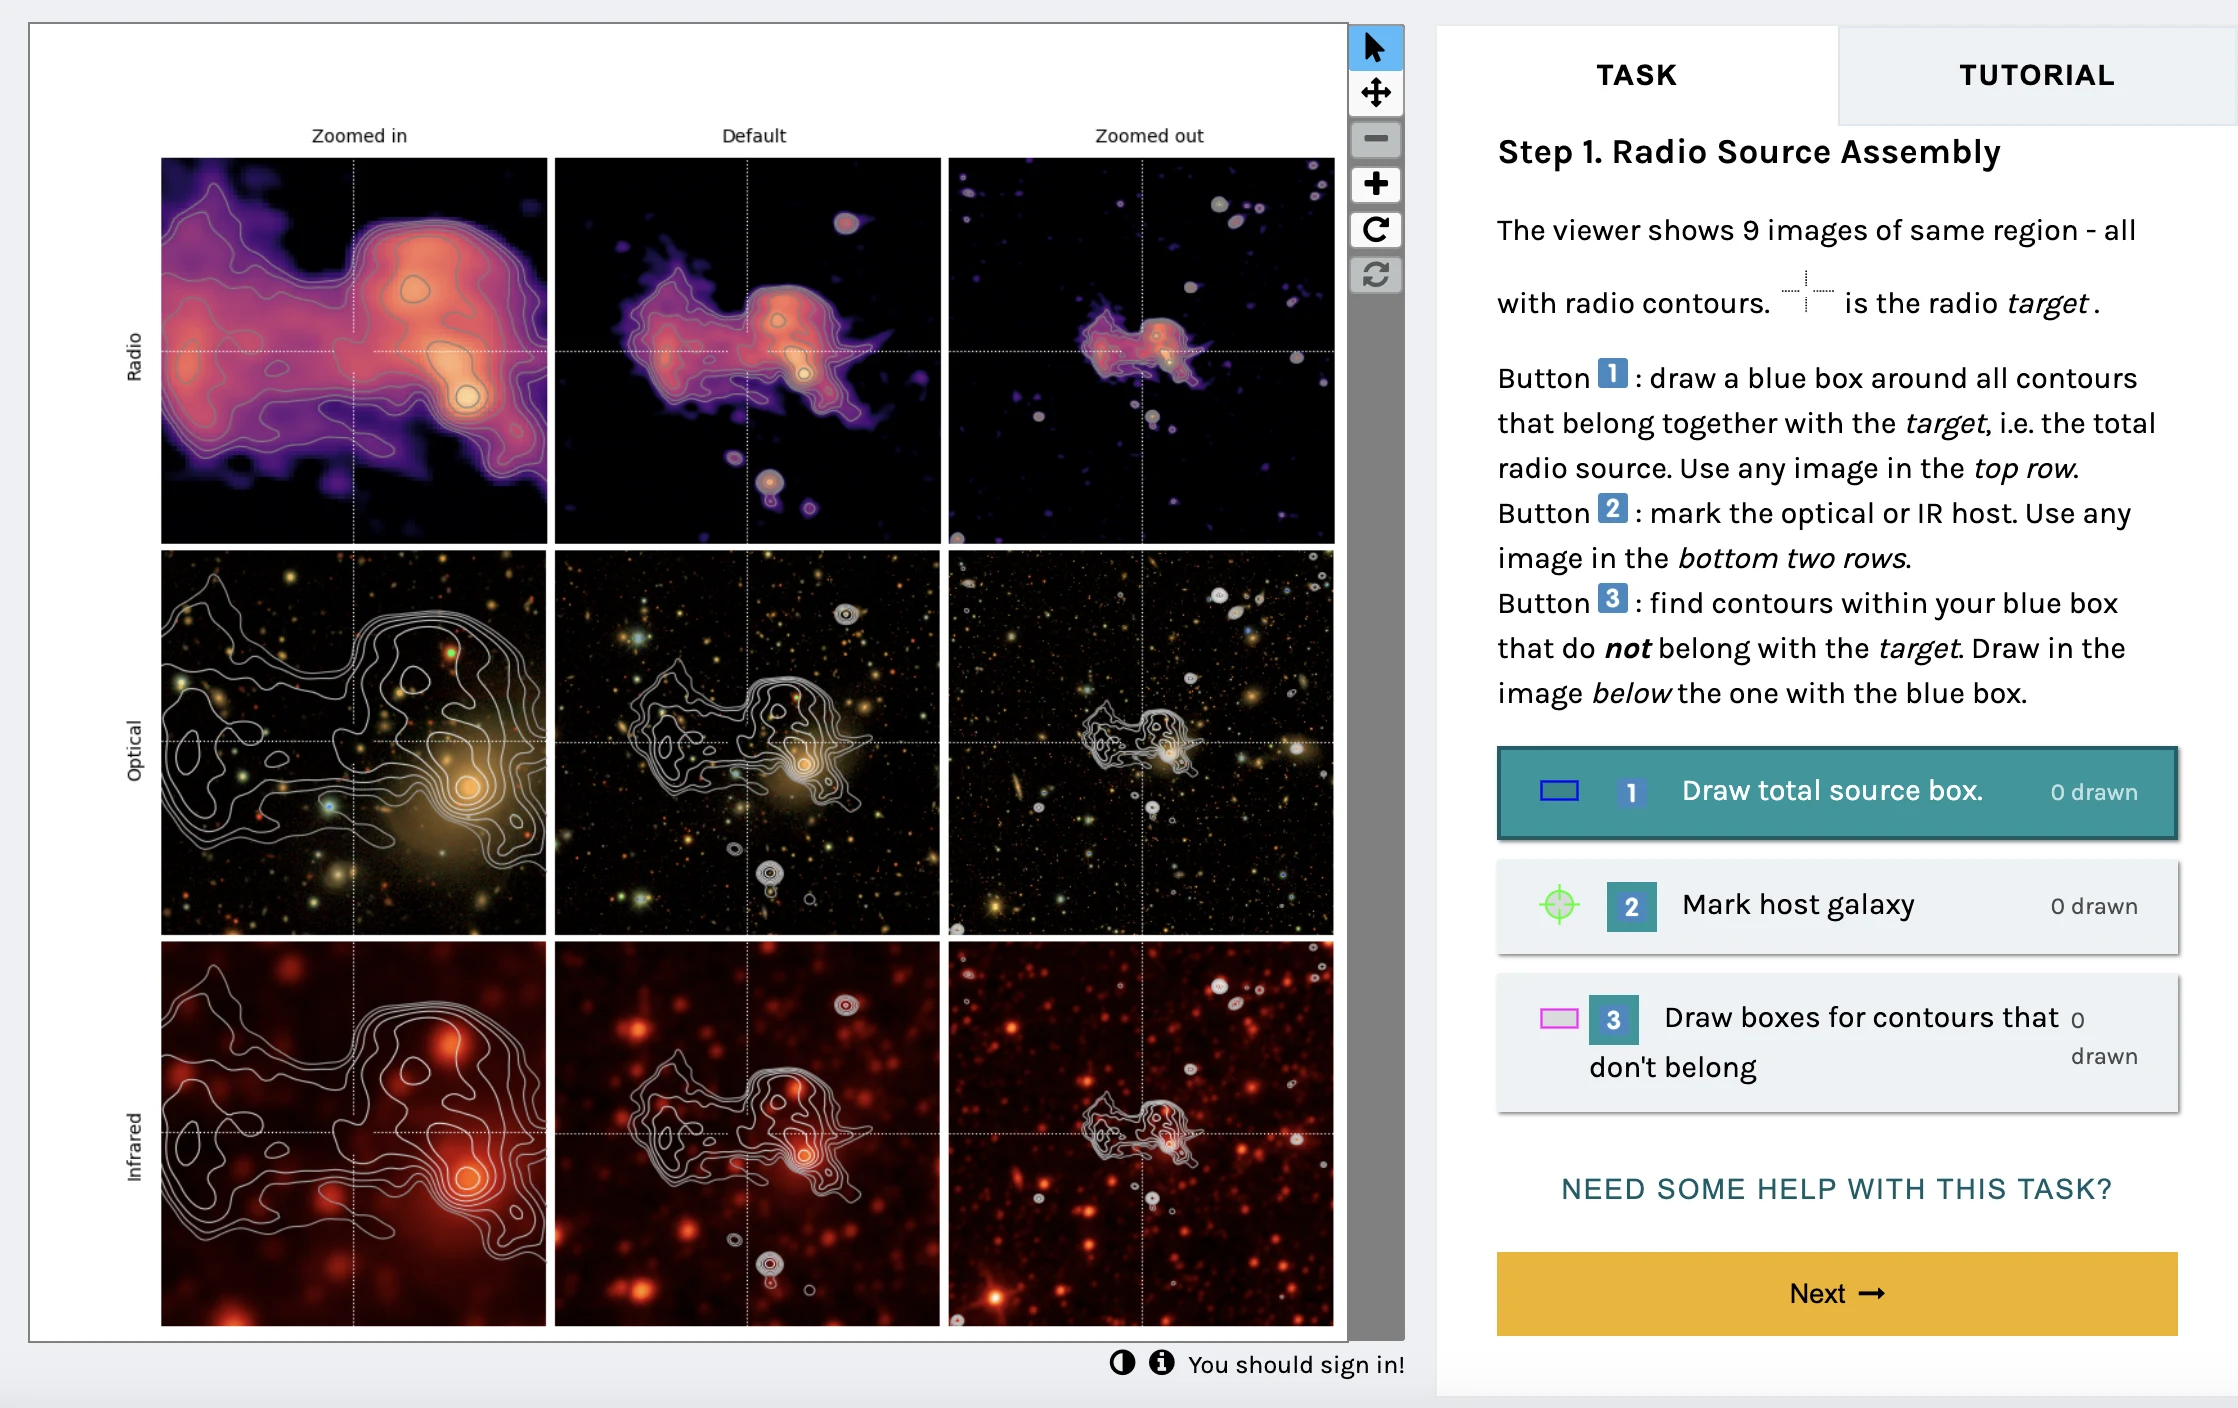
En el corazón del trabajo hay un pipeline híbrido donde el ser humano y la máquina se complementan. Primero, del catálogo Selavy se seleccionan fuentes con alta complejidad morfológica: para ello se utiliza una medida aproximada de Kolmogorov, que evalúa cuán mal se comprime una imagen, es decir, cuán rica es su estructura interna. Luego, a la complejidad se añade el tamaño angular, para que los voluntarios reciban los objetos más interesantes y grandes. En la plataforma Zooniverse, los voluntarios marcan componentes de radio relacionados, identifican las galaxias anfitrionas y asignan etiquetas simples como 'reloj de arena', 'curvado', 'rastros de la galaxia anfitriona'. Estas etiquetas nacieron de una taxonomía semántica construida con métodos de procesamiento de lenguaje natural: primero se extrajeron 22 rasgos morfológicos de las descripciones, luego se redujeron a un conjunto de aproximadamente diez etiquetas intuitivas. Así surge un vocabulario común, comprensible tanto para el humano como para el algoritmo.
Resultados
En la primera fase, más de 2500 voluntarios realizaron unas 97 000 clasificaciones. El análisis preliminar muestra que la precisión colectiva de los voluntarios se acerca al consenso de los expertos en cuanto se reúne un número suficiente de respuestas independientes. Esto concuerda con resultados anteriores del proyecto Galaxy Zoo y confirma la idoneidad de las 'muestras de oro' para entrenar modelos. Son especialmente valiosas las fuentes raras y ambiguas, donde los pipelines automáticos fallan con más frecuencia. El despliegue multilingüe (griego, chino, urdu, japonés) subraya la apertura del proyecto y amplía el grupo de participantes.
Implicaciones
El trabajo proporciona etiquetas de referencia para entrenar modelos profundos, algo que faltaba en proyectos vecinos que dependían de la automatización pura o de muestras limitadas de expertos. La diferencia con los más cercanos radica en la escala y la sistematicidad: aquí no se buscan señales de alienígenas ni se construyen mapas con un solo algoritmo, sino que se crea un corpus etiquetado que puede reutilizarse en múltiples tareas. Esta es la primera prueba del enfoque híbrido con datos reales de EMU, donde la complejidad de las fuentes es mayor que en sondeos anteriores.
Desarrollo futuro
En los próximos cinco años, el proyecto se ampliará a todo el sondeo EMU y abarcará unos cuatro millones de fuentes extendidas. El aprendizaje activo cerrará el ciclo: los modelos propondrán los objetos más informativos para etiquetar, y las nuevas etiquetas mejorarán los modelos. Este ciclo se convertirá en un banco de pruebas para una IA fiable antes del lanzamiento del Square Kilometre Array, donde los volúmenes de datos crecerán en órdenes de magnitud.
Impacto
Los resultados afectarán directamente al catálogo EMUCAT y a la preparación para el SKA, así como a los estudios multi-longitud de onda con los sondeos POSSUM, WALLABY, PEGASUS y Euclid.
Próximos pasos
Escalar a todo EMU, integrar el aprendizaje activo y publicar la primera versión del catálogo con clasificaciones híbridas.
Problemas abiertos clave
Para la radioastronomía sigue abierta la cuestión de cómo reconocer automáticamente morfologías raras sin sesgos en la muestra de entrenamiento. La ciencia ciudadana ofrece una manera de reunir ejemplos diversos, pero no resuelve el problema del sesgo: los voluntarios también prefieren objetos brillantes e inusuales. La tarea a largo plazo es entender dónde la intuición humana es insustituible y dónde el algoritmo ya la supera.
La mirada de la máquina del conocimiento
Esta sección está dirigida al autor del trabajo y a sus colegas. Los trabajos vecinos los encontró la búsqueda por significado en nuestro archivo, no por coincidencia de palabras. No evaluamos: mostramos el campo alrededor.
Qué hace el trabajo
El trabajo describe el proyecto Radio Galaxy Zoo EMU: un etiquetado colaborativo de 6230 fuentes de radio complejas del sondeo EMU, realizado por 2500 voluntarios que completaron unas 97 000 clasificaciones. Se emplea un esquema híbrido: selección automática según complejidad morfológica (medida de Kolmogorov) y tamaño angular, seguida de anotación manual en la plataforma Zooniverse con etiquetas de una taxonomía semántica construida con técnicas de PLN. El resultado será un catálogo público, EMUCAT, y datos de entrenamiento para modelos preparados para la era SKA.
Dónde está su fuerza
La fortaleza del trabajo radica en crear un corpus de referencia etiquetado para fuentes de radio extendidas y complejas, obtenido mediante un vocabulario de etiquetas consensuado, comprensible tanto para humanos como para algoritmos. La escala y la sistematicidad del enfoque proporcionan una base para entrenar modelos profundos en casos donde los pipelines automáticos suelen fallar.
Hacia dónde puede avanzar
- Podría ser interesante comparar las anotaciones obtenidas con los resultados de la clasificación automática descrita en el trabajo donde una red neuronal, sin pistas, descubre nuevas galaxias: esto permitiría evaluar en qué medida los modelos entrenados con datos de RGZ EMU mejoran la detección de morfologías raras.se apoya en: Una red neuronal sin pistas descubre nuevas galaxias arXiv:2511.05439
- Existe un trabajo cercano en el que una red neuronal generó mapas de 639 000 galaxias: se podría intentar usar las fuentes etiquetadas de RGZ EMU como conjunto de entrenamiento adicional para mejorar la calidad de los mapas de estructuras extendidas.se apoya en: Una red neuronal dibujó mapas de 639 mil galaxias arXiv:2606.16507
- En el archivo hay un análisis completo sobre quién se esconde en la luz de radio de las galaxias: allí se discute la relación entre morfología y física de las fuentes, y tus etiquetas podrían ayudar a interpretar dichas relaciones para la muestra EMU.se apoya en: Mapa de radio de tres galaxias: fuentes compactas frente al fondo difuso arXiv:2507.23332
Vale la pena probar
- Comprobar hasta qué punto las etiquetas de la taxonomía semántica correlacionan con parámetros físicos de las fuentes (por ejemplo, corrimiento al rojo, luminosidad), utilizando el catálogo del análisis completo.
- Entrenar un modelo con las anotaciones actuales y comparar sus predicciones con el consenso de los voluntarios en nuevos datos, para evaluar la mejora en precisión.
- Utilizar el enfoque de PLN para expandir automáticamente la taxonomía a partir de las descripciones de fuentes raras señaladas por los voluntarios.
Por qué puede importar
Las anotaciones de referencia de fuentes de radio complejas son cruciales para prepararse ante el flujo de datos de SKA, donde la inspección manual de cada objeto será inviable. El corpus abierto RGZ EMU podría convertirse en un estándar para entrenar y validar algoritmos de clasificación, mejorando la fiabilidad de los catálogos automáticos y liberando a los expertos para analizar objetos verdaderamente inusuales.
Trabajos cercanos en nuestro archivo
- Una red neuronal dibujó mapas de 639 mil galaxiascercanía 0.52
- Cinco mil gigantes en el mapa radioeléctrico del cielocercanía 0.51
- Sirenas gravitacionales: dónde buscar la clave del universo oscurocercanía 0.50
- El cosmos se entrena para predecircercanía 0.50
- La luz de galaxias lejanas: cómo distinguir las tranquilas de las turbulentascercanía 0.50
- Una red neuronal sin pistas descubre nuevas galaxiascercanía 0.49
- Mapa de radio de tres galaxias: fuentes compactas frente al fondo difusocercanía 0.49
El archivo está vacío alrededor de este trabajo: el análisis más cercano queda en 0.52, frente a un 0.64 habitual. Parece que aquí al lado casi nadie ha perforado.
Una de las etiquetas para la clasificación es 'reloj de arena': así se ven las radiogalaxias con dos lóbulos simétricos, que recuerdan a la figura con la que se medía el tiempo en la antigüedad.
Cifras clave
- número de clasificaciones: 97 000
- número de voluntarios: más de 2500
- tamaño de la muestra de la Fase I: 6230 fuentes extendidas
- sensibilidad del sondeo EMU-PS: 25–30 µJy/haz
- resolución angular: 11–18 segundos de arco