El cielo radioeléctrico sobre los hombros de voluntarios: cómo la ciencia ciudadana enseña a la IA a ver galaxias complejas ✛
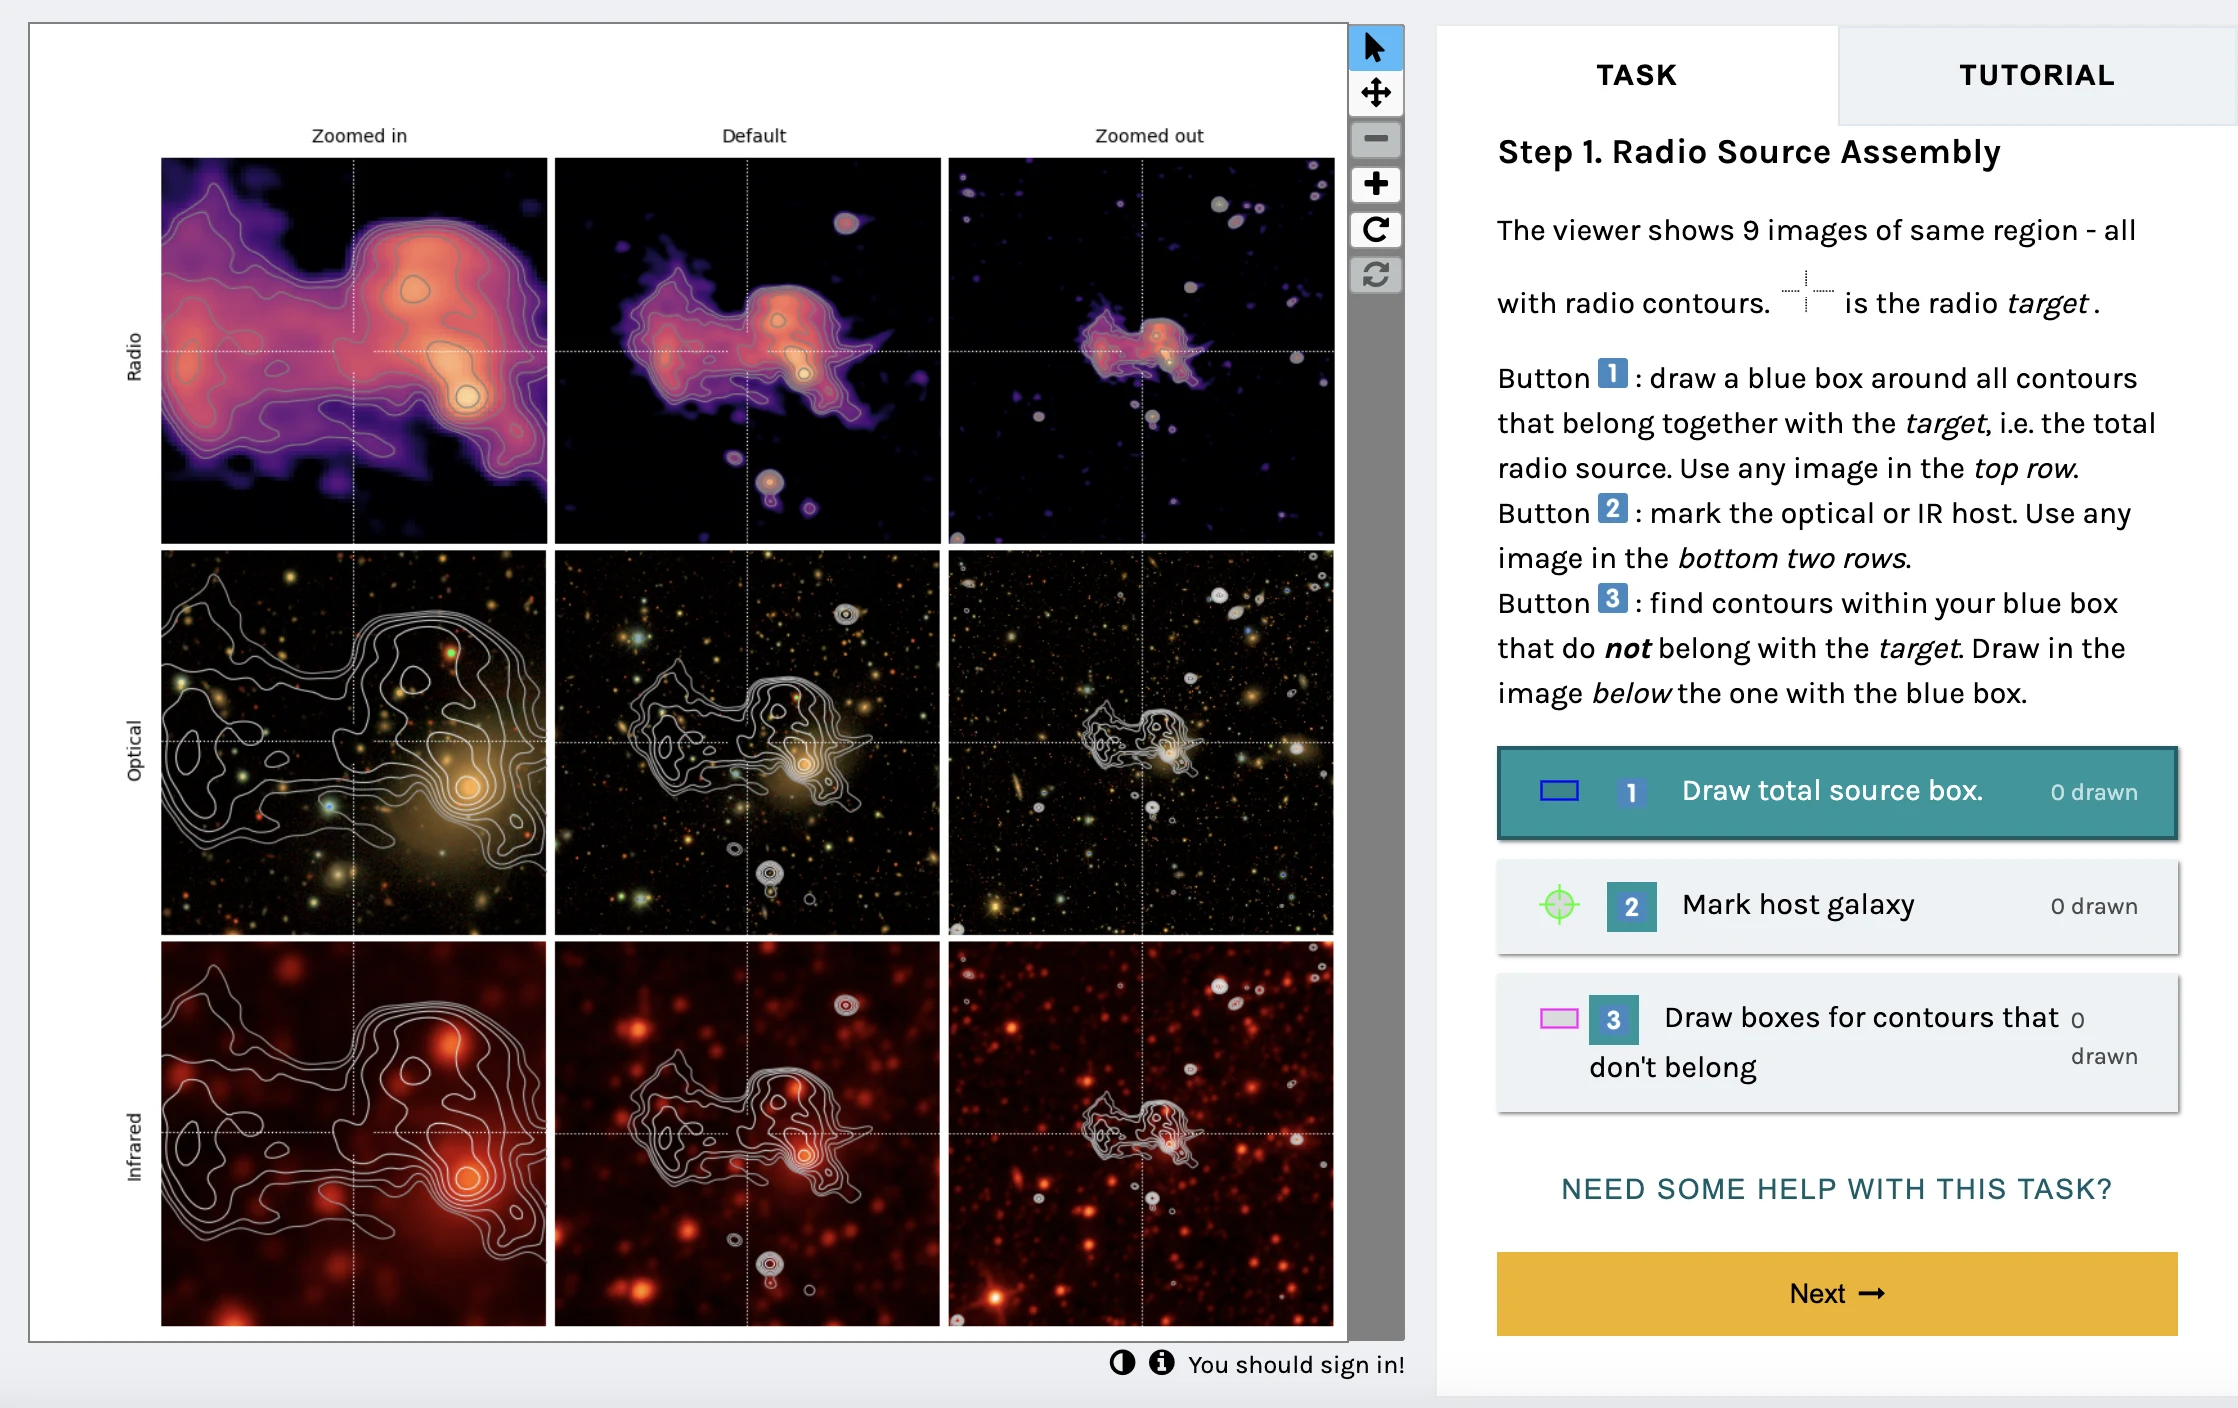
El telescopio ASKAP recopila en una sola noche datos sobre millones de fuentes de radio. Los algoritmos automáticos reconocen con seguridad los puntos compactos, pero se rinden ante las estructuras extendidas con chorros, puentes y burbujas. Los voluntarios acudieron al rescate: en la primera fase del proyecto Radio Galaxy Zoo EMU, más de 2500 personas realizaron 97 000 clasificaciones de 6230 objetos complejos.
La selección se basa en la medida de Kolmogorov: cuanto peor se comprime una imagen, más rica es su estructura interna. A esto se añade el tamaño angular, para que los voluntarios reciban los objetos más interesantes y grandes. En la plataforma Zooniverse, los voluntarios marcan los componentes conectados, encuentran las galaxias anfitrionas y asignan etiquetas simples como «reloj de arena», «curvado», «rastros de la galaxia anfitriona». Estas etiquetas nacieron de una taxonomía semántica: primero se extrajeron 22 rasgos morfológicos de las descripciones, luego se redujeron a un conjunto de aproximadamente diez etiquetas intuitivas. Surge un vocabulario común, comprensible tanto para el humano como para el algoritmo.
El enfoque híbrido ofrece lo que faltaba en proyectos similares: anotaciones de referencia para entrenar modelos profundos. Antes, los algoritmos automáticos no podían reconocer de manera fiable morfologías raras, y las anotaciones de expertos eran escasas. Ahora existe un corpus etiquetado de 6230 fuentes extendidas con etiquetas de miles de voluntarios. Se puede utilizar repetidamente y en diferentes tareas: desde mejorar el catálogo EMUCAT hasta prepararse para el Square Kilometre Array.
En los próximos cinco años, el proyecto se expandirá a todo el sondeo EMU y abarcará unos cuatro millones de fuentes extendidas. El aprendizaje activo cerrará el ciclo: los modelos propondrán los objetos más informativos para etiquetar, y las nuevas etiquetas mejorarán los modelos. Este ciclo se convertirá en un banco de pruebas para una IA fiable antes del lanzamiento de SKA, donde los volúmenes de datos crecerán en órdenes de magnitud. Los voluntarios, que comenzaron con etiquetas simples, se convertirán en coautores de una herramienta que algún día trabajará en solitario.
Una de las etiquetas para la clasificación es 'reloj de arena': así se ven las radiogalaxias con dos lóbulos simétricos, que recuerdan a la figura con la que se medía el tiempo en la antigüedad.