Los grandes modelos de lenguaje modernos son redes neuronales con arquitectura «transformer», que cuentan desde cientos de millones hasta cientos de miles de millones de parámetros. Cada parámetro es un número que influye en cómo se transmite la señal de una palabra a otra. El modelo no almacena palabras, sino que las convierte en vectores numéricos: puntos matemáticos en un espacio multidimensional de significados. El preentrenamiento se realiza mediante la tarea de autocompletado: el modelo rellena palabras faltantes o predice la siguiente palabra en una secuencia. Después, puede ser afinado con ejemplos especializados para que mantenga diálogos, resuelva tareas o escriba código.
Historia
La historia comenzó con los modelos estadísticos de n-gramas (década de 1950), luego con modelos de lenguaje basados en redes neuronales (Bengio et al., década de 2000). El punto de inflexión fue el artículo Attention Is All You Need (2017), que propuso la arquitectura transformer. La empresa OpenAI lanzó GPT-1 con 117 millones de parámetros en 2018, y en 2020 GPT-3, con 175 mil millones de parámetros, demostró que el modelo, sin entrenamiento explícito, es capaz de traducir, programar y razonar simplemente recibiendo instrucciones en lenguaje natural. Desde entonces, la competencia avanza tanto hacia modelos más grandes como hacia una mayor eficiencia (Mezcla de Expertos, leyes de escalado Chinchilla).
Cómo funciona
El modelo recibe como entrada una ventana de contexto de n tokens. Cada token se asigna a un embedding y se codifica mediante capas de auto-atención, creando representaciones contextualizadas. A la salida, un clasificador lineal predice la distribución de probabilidad del siguiente token. El entrenamiento minimiza la entropía cruzada entre la predicción y el token real. Durante la generación, el texto se produce mediante un muestreo secuencial de tokens (normalmente con núcleo top-p o top-k). Las técnicas clave incluyen: preentrenamiento en texto no etiquetado, seguido de un ajuste fino mediante instrucciones o RLHF para alinearlo con la utilidad y la seguridad. El mecanismo de atención calcula pesos de similitud entre consultas y claves para cada par de tokens, lo que permite enfocarse en dependencias de largo alcance.
En la práctica
Estos modelos escriben noticias, componen poemas, generan código de programación, responden preguntas de clientes en chats y ayudan a los médicos a redactar resúmenes de historias clínicas.
Dato curioso
GPT-3 es capaz de escribir un ensayo que una comisión no distinguió del escrito por un humano, en 2 segundos: el tiempo que tarda una persona solo en abrir un editor de texto.
En marzo de 2020, Francia se quedó vacía: la gente dejó de ir al trabajo, a las escuelas y a los cafés, y las calles se llenaron de silencio. Los epidemiólogos miraban las gráficas y entendían que el virus no se propagaba solo, sino a través de apretones de manos, conversaciones y viajes en metro. Pero, ¿cómo predecir cuántos contactos le quedarán a una persona si el gobierno anuncia nuevas restricciones?
En marzo de 2020, Francia se quedó vacía: la gente dejó de ir al trabajo, a las escuelas y a los cafés, y las calles se llenaron de silencio. Los epidemiólogos miraban las gráficas y entendían que el virus no se propagaba solo, sino a través de apretones de manos, conversaciones y viajes en metro. Pero, ¿cómo predecir cuántos contactos le quedarán a una persona si el gobierno anuncia nuevas restricciones?
Una proteína en la célula no permanece inmóvil, como un maniquí en un escaparate. Sus átomos tiemblan, se estiran y se doblan constantemente, como una cuerda de guitarra tensa que sigue sonando después de que la rozas con el dedo. Para entender cómo funciona una proteína, hay que saber con qué firmeza cada parte se aferra a sus vecinas.
Un intérprete se distrae con cada ruido en la sala, y una reunión de una hora se convierte en dos. Algo parecido ocurre con los modelos fundamentales moleculares: aprenden el lenguaje de las moléculas a partir de corpus enormes, pero para cada nueva conversación requieren un ajuste. Monroe cambia las reglas: no aprende un idioma nuevo, sino que capta al instante el sentido común a partir de unos pocos ejemplos.
Una historia clínica se parece a un diario largo: visitas al médico, diagnósticos, recetas, análisis. Un médico normal lo lee de principio a fin para entender qué le pasa al paciente. Y ahora, ese diario lo lee una máquina, y lo hace en cuestión de segundos.
Los desarrolladores crearon el modelo Foresight-E.
Buscar un material nuevo es como cocinar sin receta: pruebas y pruebas, y a menudo tiras todo a la basura. Antes, los científicos revisaban manualmente los artículos y probaban las composiciones una por una. Ahora ha aparecido un "chef robot" que lee la literatura, mezcla los componentes y observa el resultado.
Un radiotelescopio, como un oído atento, capta el susurro de galaxias distantes. Entre ese murmullo se esconden gigantes: las fuentes de radio de gran tamaño. Son nubes de partículas cargadas expulsadas desde las cercanías de agujeros negros supermasivos. Se extienden a lo largo de millones de años luz, decenas de veces más que nuestra galaxia.
En un horno, al subir la temperatura, las moléculas se mueven más rápido y el desorden aumenta. Con los modelos de lenguaje como ChatGPT ocurre lo contrario. Cuando los desarrolladores aumentan el parámetro de «temperatura», el modelo tiene acceso a una selección más amplia de palabras, pero sus textos largos de repente se quedan en bucle.
El magnetoencefalógrafo, un dispositivo parecido a un casco con cientos de sensores, capta los débiles campos magnéticos que generan las neuronas en acción. Cuando una persona escucha habla, en esas señales se esconden huellas de las palabras oídas. Pero extraerlas no es fácil: la señal de miles de fuentes se funde en una maraña confusa.
La mente humana es como un juego de construcción que se va completando a sí mismo. Las ideas nuevas no mueren con la persona: se transmiten, se mezclan y se seleccionan. Este proceso se llama evolución cultural: los inventos útiles se consolidan y los inútiles se olvidan. Así funciona un trinquete, un mecanismo que solo gira hacia adelante.
Cuatro trazos débiles en una imagen: eso es todo lo que ve un astrónomo. Como un escultor que reconstruye la forma de un vidrio invisible a partir de cuatro sombras.
Doscientas cuarenta y dos mil trescientas veintisiete galaxias — como granos de arena en una playa. Pero los astrónomos convirtieron este caos en un mapa: el algoritmo UMAP (método de aprendizaje automático) tomó de cada galaxia once parámetros — siete colores desde el óptico hasta el infrarrojo medio (esto es…
En 2025, los grandes modelos de lenguaje como GPT ya no solo conversan: ayudan a los científicos a diseñar experimentos. Pero la misma herramienta puede caer en manos de un delincuente. Un grupo de investigadores construyó un campo de pruebas digital para averiguarlo.
Un artista hace un boceto rápido al carboncillo — y el rostro en el retrato ya es reconocible. Los astrofísicos se enfrentan a una tarea similar: el espectro de una estrella es su retrato individual, que revela temperatura, composición, gravedad superficial.
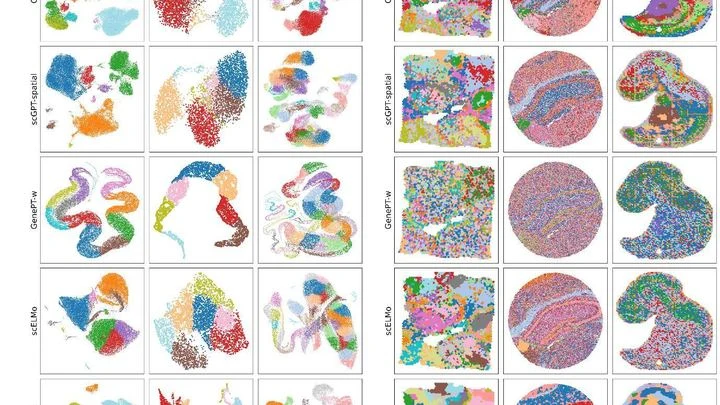
Cada vez más, los biólogos confían a las computadoras la lectura de las "instrucciones de uso" de una célula viva. Seis modelos recientes de inteligencia artificial —Nicheformer, CellPLM, scGPT-spatial, GenePT, scELMo y Novae— son como seis traductores de diferentes dialectos del mismo lenguaje celular.
Un libro de cocina se reescribe de generación en generación, pero un día la receta del gazpacho recibe un ingrediente secreto de un pastelero. A partir de ese momento, el sabor recuerda no solo a los ancestros, sino también al vecino. En el modelo estándar de la evolución, los genes se comportan de la misma manera.
Las señales de radio en una habitación se comportan como el sonido en una sala de conciertos: al rebotar en paredes y objetos, crean un patrón irrepetible, una melodía silenciosa de cada lugar. El teléfono, como un oído atento, capta esa melodía entre interferencias y distorsiones. Memoriza qué acorde corresponde a la esquina del sofá y cuál al marco de la puerta.
Un IA común ve las imágenes médicas como rompecabezas de fragmentos desconocidos: dos imágenes no emparejadas las considera completamente diferentes. Es como intentar distinguir a gemelos sin saber que son familia. En medicina, los pacientes con la misma enfermedad se ven casi iguales en la resonancia, y el algoritmo se equivoca al confundir a los «parientes».
El ser humano extrae sin esfuerzo la voz deseada del bullicio de una fiesta. Para una computadora, lo mismo es aún una tarea al límite de sus posibilidades. Los programas anteriores se entrenaban con grabaciones estériles, sin eco ni pitidos de aparatos.
Los modelos que convierten texto en audio recrean bien los sonidos individuales, pero se confunden cuando en el guión hay varios. Por ejemplo, según el guión primero suena el timbre, luego los pasos, después el portazo. El generador puede alterar los eventos y el oyente escuchará los pasos antes del timbre.
Los jueces automáticos del habla son algoritmos que evalúan la pronunciación y las emociones. Sin embargo, a menudo funcionan como un crítico culinario que emite un veredicto tras leer el menú, pero sin probar el plato.
En una olla de sopa, bastan dos termómetros para saber la temperatura en todas partes, si se sabe que el calor sube en círculos desde el fondo. Así ocurre en la ciencia: a partir de pocas mediciones hay que reconstruir la imagen completa del campo térmico.
El cerebro se comunica con breves chasquidos eléctricos. Antes, para aprender este lenguaje, se necesitaban miles de ejemplos traducidos por un experimentador. El método MOJO sigue otro camino: como cuando se aprende un idioma por inmersión, primero escucha el 'flujo de conciencia' sin pistas y encuentra por sí mismo patrones repetitivos.
Durante mucho tiempo, los biólogos estudiaban las células escuchando solo una voz en un coro polifónico: por ejemplo, medían la actividad de los genes ignorando cómo está empaquetado el ADN. Es como intentar entender una conversación conociendo un solo idioma. LATTICE lo corrige: el programa aprende cinco 'idiomas' moleculares a la vez, desde la actividad génica hasta las marcas espaciales.
Evaluar la calidad de una imagen es tarea de un inspector meticuloso con un juego de herramientas. La red neuronal IQA-T1 actúa exactamente así: no solo observa la imagen, sino que aplica ora un espectroscopio, ora un luxómetro.
El sonido se describe naturalmente con un número complejo, donde el volumen es la fuerza de la onda y la fase su posición en el tiempo. Las redes neuronales convencionales lo descomponen en dos coordenadas independientes, como si para dar una dirección dijeran: «dos al este, uno al norte».
Preparar un plato complejo exige una receta clara: primero cortar, luego sofreír, añadir las especias en el momento justo. Las transformaciones químicas también siguen recetas paso a paso, mecanismos donde los átomos de carbono e hidrógeno se reorganizan en un orden estricto.
Los neurochips funcionan de manera distinta a los ordenadores convencionales, construidos según los planos de von Neumann con memoria y procesador separados.
Los asistentes de programación suelen actuar como un cocinero que, para hervir un solo huevo, relee el libro de cocina entero. Al recibir la tarea de hacer una pequeña corrección, vuelven a abrir decenas de archivos y verifican vínculos ya conocidos. Esto es trabajo innecesario: energía que se desperdicia.
La red neuronal que genera sonidos a partir de texto se parece a una cocina donde cada «plato» lo preparan decenas de cocineros. Muchos solo estorban: envían señales falsas y malgastan recursos.
El transmisor envía solo un esbozo tosco del mensaje — como un artista que dibuja contornos sin detalles. En la recepción, la IA, como un restaurador experimentado, restaura la imagen completa, limpiándola de interferencias. Así funciona la tecnología LiTCom, que cambia las reglas del juego en las futuras redes 6G.
Una gran red neuronal, como Whisper, domina cientos de idiomas y recuerda al modelo estándar del universo: todo está equilibrado. Pero entrenarla en un idioma raro rompe el equilibrio: se convierte en un agujero negro que atrae todos los recursos de aprendizaje. La red comienza a olvidar los demás idiomas.
El método estándar de digitalización de voz: se toman lecturas de volumen miles de veces por segundo. Es como probar un caldo con una cucharadita: cada sorbo es aguado y casi no hay detalles. El flujo de datos se hincha, aunque el significado es ínfimo.
Los científicos propusieron primero ‘reducir’ la señal de audio.
Un árbol genealógico se convierte en un enredo si se tienen en cuenta los hijos adoptivos y los segundos matrimonios. La evolución a menudo se parece a ese enredo: aunque el modelo estándar —la representación tradicional de la evolución divergente, donde las especies se ramifican como un árbol— dibuja un árbol de especies ordenado, en realidad los genes no solo se…
El sistema energético vivo se parece a un organismo: las líneas de transmisión son vasos, la corriente es la sangre. Los datos, en cambio, son impulsos nerviosos que antes se perdían. mAIEnergy conecta estos «nervios» a un «cerebro» común.
Un detective experimentado no calcula la trayectoria de un criminal a partir de las leyes de la física: consulta el archivo de casos similares. Así funciona este nuevo método de predicción: en lugar de ecuaciones complejas, dispone de un enorme archivo de trayectorias ya ocurridas: movimientos planetarios, cotizaciones de divisas, señales del espacio.
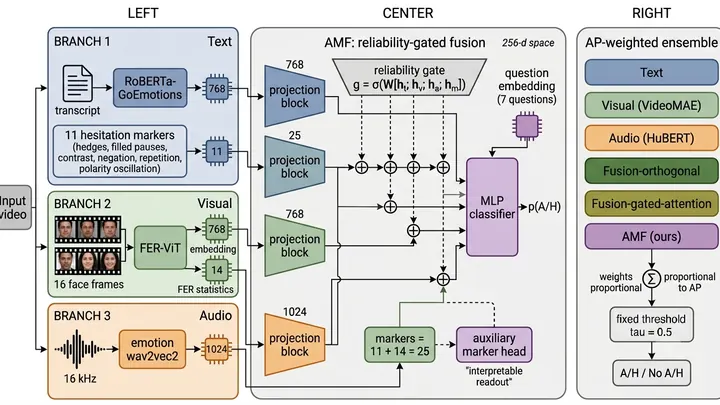
Un nuevo sistema analiza una entrevista corta para reconocer las dudas de una persona, combinando texto, voz y expresión facial. Pero la clave principal de la inseguridad resultó ser la materia oscura del habla: pausas y muletillas que los sistemas de voz estándar borran como un agujero negro.
Los dispositivos cuánticos ya no son curiosidades de laboratorio. Se ensamblan, ajustan y reparan como equipos comunes, solo que en su interior no hay simplemente corriente, sino intrincadas redes de partículas que pueden estar en varios estados a la vez. Los ingenieros dibujan esquemas, los programadores escriben código, los físicos calculan efectos.
La cosmología moderna ha caído en una disonancia. Las mediciones locales de la constante de Hubble basadas en supernovas y cefeidas arrojan alrededor de 73 km/s/Mpc, mientras que las restricciones globales del fondo cósmico de microondas dentro del modelo estándar ΛCDM indican 67 km/s/Mpc.