Enseñar a la red neuronal con menos, pero con inteligencia exprés
Las proteínas en la naturaleza son como granos de arena en la playa, y cada una tiene su función: unas descomponen los alimentos, otras construyen células. Pero para saber qué hace exactamente una proteína, hay que estudiarla en el laboratorio, y eso es lento y caro. Las redes neuronales pueden adivinar la función de una proteína a partir de su "texto" —la secuencia de aminoácidos—, pero su entrenamiento requiere una enorme cantidad de ejemplos etiquetados. El problema es que hay pocas proteínas etiquetadas: por cada una verificada en el laboratorio, hay un millón desconocidas.
Un grupo de investigadores propuso un enfoque parecido a un estudiante inteligente que no se memoriza todo el libro, sino que pregunta al profesor solo por las partes más difíciles. Este método se llama aprendizaje activo: el modelo elige las proteínas en las que está menos seguro y pide a un experto humano que les ponga la etiqueta correcta. Luego, el modelo se reentrena con esos ejemplos seleccionados. Los científicos construyeron un sistema que combina varias estrategias para elegir las proteínas "difíciles" y permite que un humano revise y corrija las predicciones manualmente.
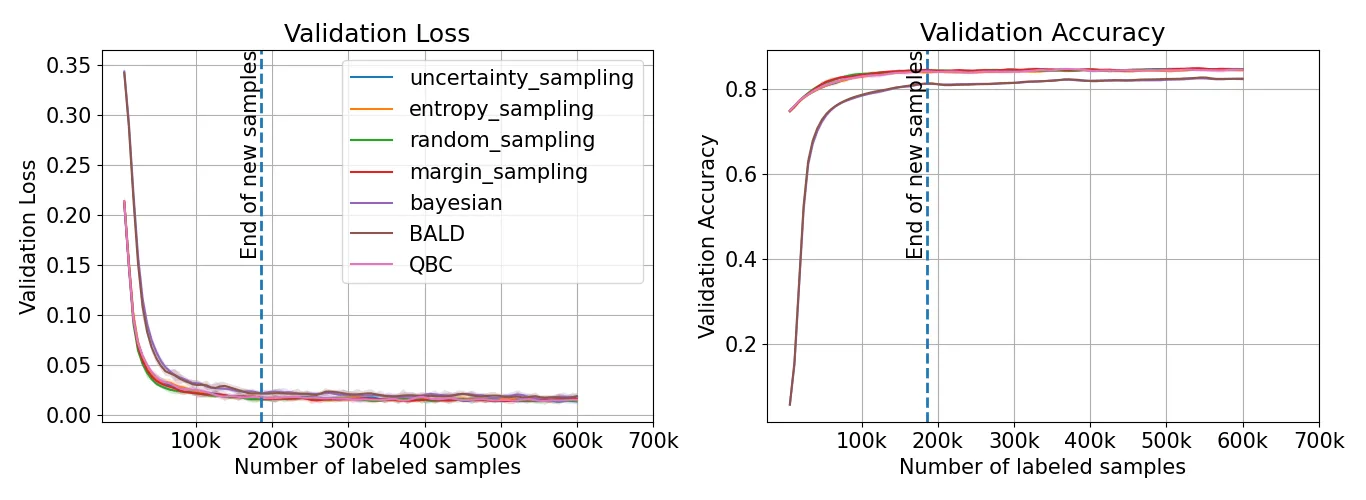
Los resultados se compararon con el entrenamiento convencional, en el que se le da al modelo todos los datos de una vez. Resultó que el aprendizaje activo alcanza la misma precisión en las predicciones, pero requiere menos actualizaciones del modelo, procesa menos datos y ahorra notablemente recursos computacionales. Para los investigadores, esto significa que se pueden estudiar las funciones de las proteínas más rápido y más barato, sin perder calidad.
Este enfoque es especialmente importante ahora que las bases de datos de secuencias de proteínas crecen a un ritmo explosivo y la verificación experimental no va a la par. En lugar de esperar años a que cada nueva proteína se estudie en el laboratorio, los científicos pueden centrarse en los candidatos más misteriosos y prometedores. Es como buscar diamantes en un montón de arena: no se tamiza todo, sino solo las zonas donde ya se ve un brillo.
Resumen original
tal como lo escribieron los autores, en inglés arXiv:2602.23269
Generalizable protein function prediction is increasingly constrained by the growing mismatch between exponentially expanding sequences of environmental proteins and the comparatively slow accumulation of experimentally verified functional data. Active learning offers a promising path forward for accelerating biological function prediction, by selecting the most informative proteins to experimentally annotate for data-efficient training, yet its potential remains largely unexplored. We introduce HATTER (Human-in-the-loop Adaptive Toolkit for Transferable Enzyme Representations), a modular framework that integrates multiple active learning strategies with human-in-the-loop experimental annotation to efficiently fine tune function prediction models. We compare active learning training to standard supervised training for biological enzyme function prediction, demonstrating that active learning achieves performance comparable to standard training across diverse protein sequence evaluation datasets while requiring fewer model updates, processing less data, and substantially reducing computational cost.
El banco más grande de secuencias de proteínas contiene cientos de millones de registros, pero solo una diminuta fracción de ellos está verificada experimentalmente: menos del uno por ciento.