Los datos de entrenamiento son los ejemplos —imágenes, textos o mediciones— que se utilizan para enseñar a un modelo de aprendizaje automático a reconocer patrones y hacer predicciones. La calidad y diversidad de estos datos determinan lo que el modelo aprende y cómo generaliza a nuevas situaciones. Sin datos de entrenamiento representativos, incluso el algoritmo más sofisticado falla.
Historia
El concepto surgió en la década de 1950 con los perceptrones, pero el aprendizaje profundo moderno depende de conjuntos de datos masivos y de la potencia computacional que estuvo disponible en la década de 2010.
Cómo funciona
Durante el entrenamiento, el modelo ajusta sus parámetros internos para minimizar la diferencia entre sus predicciones y las respuestas correctas en los datos de entrenamiento. Esto se hace de forma iterativa, a menudo mediante el descenso de gradiente, donde el modelo aprende a extraer características relevantes de los ejemplos. El proceso es análogo a ajustar una curva a puntos, pero en espacios de alta dimensión.
En la práctica
Los datos de entrenamiento impulsan redes neuronales que diagnostican enfermedades a partir de imágenes médicas, predicen patrones climáticos y traducen idiomas en tiempo real.
En el hielo antártico, una partícula fantasma deja tras de sí solo un débil destello de luz azul. El detector IceCube capta esos destellos, y con ellos hay que deducir de dónde vino la partícula. El modelo PolarBERT aprendió a hacerlo, pero qué ve exactamente en su interior seguía siendo un misterio.
Una proteína en la célula no permanece inmóvil, como un maniquí en un escaparate. Sus átomos tiemblan, se estiran y se doblan constantemente, como una cuerda de guitarra tensa que sigue sonando después de que la rozas con el dedo. Para entender cómo funciona una proteína, hay que saber con qué firmeza cada parte se aferra a sus vecinas.
Un ingeniero de proteínas se parece a un cocinero que intenta hacer un plato que sea a la vez sabroso, saludable y barato. Al cambiar un ingrediente, corre el riesgo de estropear otro. Antes, los asistentes informáticos solo podían evaluar las propiedades de las proteínas por separado, sin ver cómo se relacionan entre sí.
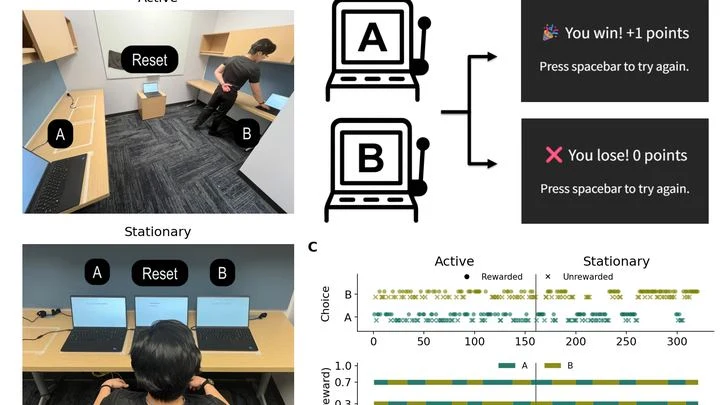
Una persona lanza una moneda para tomar una decisión. Está quieta: la moneda cae cara. Da un par de pasos y vuelve a lanzar. Parecería que caminar no debería influir en la moneda. Pero ¿y si el simple paseo cambia la frecuencia con la que decide repetir el lanzamiento anterior?
Esto es exactamente lo que comprobaron los investigadores.
Cuatro trazos débiles en una imagen: eso es todo lo que ve un astrónomo. Como un escultor que reconstruye la forma de un vidrio invisible a partir de cuatro sombras.
Cien mil estrellas en el denso núcleo de un cúmulo globular se mueven como bolas de acero en una gigantesca máquina de pinball. Cada «empujón» —un encuentro gravitacional entre un sistema binario y una estrella solitaria— desencadena una cascada de eventos impredecibles.
Una biblioteca enorme donde cada libro es una instrucción precisa para ensamblar una molécula de proteína. La red neuronal AlphaFold2 ha leído millones de estos libros y ha aprendido a generar al instante un modelo tridimensional ya terminado.
En combate, un piloto necesita entender al instante qué objeto es y cuáles son sus intenciones. Los sistemas convencionales esperan datos completos del radar, como un portero que solo reacciona después del disparo. El nuevo algoritmo funciona como un portero experimentado: a partir de los primeros movimientos del delantero, predice la maniobra del objetivo.
Las señales de radio en una habitación se comportan como el sonido en una sala de conciertos: al rebotar en paredes y objetos, crean un patrón irrepetible, una melodía silenciosa de cada lugar. El teléfono, como un oído atento, capta esa melodía entre interferencias y distorsiones. Memoriza qué acorde corresponde a la esquina del sofá y cuál al marco de la puerta.
El robot malabarista atrapa y lanza pelotas al ritmo exacto de un humano, como dos púlsares que emiten pulsos al unísono. Hacer malabares con tres pelotas es una cascada clásica que sigue un compás definido, similar a la rotación uniforme de un faro cósmico. Si rompes el ritmo, el patrón se desmorona.
La inteligencia artificial que predice la acústica de una sala se parece a un estudiante en un examen con una chuleta. Si los puntos de prueba son los mismos que los de entrenamiento, el modelo simplemente memoriza la 'huella sonora' de cada posición, como un estudiante que reconoce el examen por una esquina doblada.
Los modelos que convierten texto en audio recrean bien los sonidos individuales, pero se confunden cuando en el guión hay varios. Por ejemplo, según el guión primero suena el timbre, luego los pasos, después el portazo. El generador puede alterar los eventos y el oyente escuchará los pasos antes del timbre.
El enfoque estándar actual para entrenar a la IA se parece a un niño encerrado en una biblioteca: recuerda millones de libros, pero no sabe que el fuego quema o que una caída duele.
El cerebro se comunica con breves chasquidos eléctricos. Antes, para aprender este lenguaje, se necesitaban miles de ejemplos traducidos por un experimentador. El método MOJO sigue otro camino: como cuando se aprende un idioma por inmersión, primero escucha el 'flujo de conciencia' sin pistas y encuentra por sí mismo patrones repetitivos.
Evaluar la calidad de una imagen es tarea de un inspector meticuloso con un juego de herramientas. La red neuronal IQA-T1 actúa exactamente así: no solo observa la imagen, sino que aplica ora un espectroscopio, ora un luxómetro.
Tradicionalmente, los algoritmos de aprendizaje automático operan en un entorno estático, como agua que fluye por un cauce ya trazado sin cambiar su forma. El nuevo método invierte este paradigma: permite que el agente aprenda acciones y, al mismo tiempo, modifique el entorno en el que existe.
Cuando presionas «ensalada» y el teclado sugiere «César», detrás de escena millones de teléfonos están aprendiendo juntos a predecir palabras. No intercambian tus mensajes, solo mejoras del algoritmo común, como un entrenador que envía a los atletas solo los cambios en el plan: «añade 5 flexiones a las de ayer». La entropía de la información ayuda a enviar solo correcciones valiosas e inesperadas.
Los científicos tomaron 16 actividades cotidianas — desde lavar platos hasta hacer sentadillas — y descompusieron los movimientos en componentes elementales, como un espectroscopio descompone la luz en un espectro. Comparando tres enfoques, encontraron una clave inesperada para el reconocimiento: basta con un fotograma congelado promediado.
Un árbol genealógico se convierte en un enredo si se tienen en cuenta los hijos adoptivos y los segundos matrimonios. La evolución a menudo se parece a ese enredo: aunque el modelo estándar —la representación tradicional de la evolución divergente, donde las especies se ramifican como un árbol— dibuja un árbol de especies ordenado, en realidad los genes no solo se…
La tecnología compleja —desde drones hasta robots cirujanos— a veces se comporta como un mustang salvaje: llena de desorden y caprichos, donde un leve contacto provoca una tormenta. En lugar de memorizar fórmulas, el nuevo método observa el sistema como un jinete adiestrador.
El sistema energético vivo se parece a un organismo: las líneas de transmisión son vasos, la corriente es la sangre. Los datos, en cambio, son impulsos nerviosos que antes se perdían. mAIEnergy conecta estos «nervios» a un «cerebro» común.
Un detective experimentado no calcula la trayectoria de un criminal a partir de las leyes de la física: consulta el archivo de casos similares. Así funciona este nuevo método de predicción: en lugar de ecuaciones complejas, dispone de un enorme archivo de trayectorias ya ocurridas: movimientos planetarios, cotizaciones de divisas, señales del espacio.
El aprendizaje automático hace tiempo que dejó de ser una simple herramienta: se está convirtiendo en un investigador que extrae por sí mismo las leyes de la naturaleza de los datos. Pero, ¿cómo llega la mente de silicio a la comprensión?
El cielo de rayos gamma captado por el telescopio Fermi es una grandiosa sinfonía de miles de fuentes. Aquí las pulsaciones rítmicas de púlsares, los potentes acordes de núcleos activos de galaxias, pero sobre todo objetos no identificados, cuya parte sigue siendo un misterio.
Las señales gravitacionales de estrellas masivas moribundas son susurros que nos llegan desde los laboratorios más violentos del Universo. Einstein predijo estas ondas gravitacionales hace más de un siglo, pero solo hoy, con detectores como LIGO, comenzamos a escucharlas.
Las perovskitas híbridas son las estrellas emergentes de la fotovoltaica: su eficiencia crece tan rápido que parece que estamos al borde de una revolución solar. Pero estos materiales, como intrincados mosaicos de átomos, son extremadamente vulnerables: la humedad, el calor y la luz los convierten rápidamente en polvo.
Una neurona se parece a un instrumento musical complejo. Para entender cómo responderá al tacto, antes había que conectarse directamente a cada cuerda: un procedimiento delicado, lento y solo posible en células individuales.
Imagina una audición para una orquesta sinfónica, donde de cientos de aspirantes solo se quedan aquellos cuyos instrumentos suenan limpios y resisten un feroz crescendo. En el mundo de los materiales, las computadoras han aprendido a generar «partituras atómicas»: miles de cristales virtuales que prometen ser la base de chips cuánticos o superconductores.
Casi un siglo después de que Fritz Zwicky sospechara que algo andaba mal en el movimiento de las galaxias del cúmulo de Coma, y Vera Rubin midiera las velocidades estelares en los brazos espirales, la naturaleza de la materia oscura sigue siendo uno de los enigmas más acuciantes.
60 ratones, 1980 muestras, 234 pacientes con cáncer de pulmón. Detrás de cada número hay miles de genes. Su actividad se mide para entender la enfermedad. Pero los datos no son homogéneos: de un paciente se evalúa el nivel de proteína (número continuo), se le asigna un diagnóstico (sí/no) y se determina el subtipo de tumor (categoría).
Un médico hojea el historial clínico y ve una línea: «El fármaco reduce el riesgo». Pero, ¿hasta qué punto se puede creer? ¿Se basa la afirmación en un par de casos de la práctica o en decenas de miles de pacientes en un estudio ciego? De la respuesta depende el tratamiento.
Las redes neuronales comunes aprenden de ejemplos, como una persona que memoriza melodías de oído. Pero las redes que tienen incorporadas las leyes físicas desde el principio se parecen a un músico que conoce las notas y la armonía: puede tocar una pieza nueva con solo unos cuantos acordes.
Un chef no gasta ingredientes preparando el plato entero para probar el sabor; simplemente prueba una gota de salsa. La misma lógica está en el método de ‘emparejamiento informativo’ para predecir la resistencia de los metales.
El diseño de máquinas se parece a la cocina: hay que saber exactamente dónde se romperá la «masa». Los viejos cálculos por computadora revisan cada punto de la pieza durante horas, como medir toda la olla para que el asa no se caiga.
Un cajero de supermercado en hora punta no memoriza cada compra que pasa por su caja: se queda con el total y vigila la cola. Más o menos así reparte el cerebro sus fuerzas: la corteza, cara y precisa (la que se encarga de pensar), y los núcleos subcorticales, más simples y económicos (donde viven los hábitos), trabajan en pareja.
Las redes neuronales convencionales aprenden de miles de ejemplos, gastando horas y gigavatios. Los físicos encontraron un atajo cuántico. Ya Max Planck demostró la discretización de la energía, y hoy esto permite generar sin entrenamiento.
En una persona, la enfermedad comienza con un temblor en la mano: la taza baila sobre el platillo mientras la lleva a la mesa. En otra, las piernas de repente se niegan a caminar con firmeza: el paso se vuelve corto y arrastrado, como si el suelo se hubiera cubierto de una capa pegajosa. No son dos enfermedades distintas, sino dos caras de la misma: la enfermedad de Parkinson.
Un mosaico de grandes baldosas de colores. Cada baldosa es la cantidad media de precipitación durante un mes entero en un territorio del tamaño de un pequeño país. Para una idea general, la imagen sirve, pero si necesitas saber si ayer llovió sobre una ciudad concreta, es inútil.
Cada vez que dudas ante un paso arriesgado —si invertir en acciones o esperar—, en tu cabeza se desarrolla un diálogo interno. Normalmente, los científicos intentan reconstruir el curso de ese diálogo basándose únicamente en la elección final, como si un detective reconstruyera una conversación entre dos personas mirando una foto del lugar del encuentro.