El análisis de voz mediante IA utiliza el aprendizaje automático para extraer significado del lenguaje hablado, yendo más allá de la mera transcripción para interpretar la prosodia, las pausas, el tono emocional e incluso el estado fisiológico. Los sistemas modernos analizan características acústicas como el tono, el ritmo y el contenido espectral, combinadas con el contexto lingüístico, para inferir aspectos como la emoción del hablante, la carga cognitiva o condiciones de salud. Este campo une el procesamiento de señales, la lingüística y la inteligencia artificial, permitiendo que las máquinas comprendan no solo lo que se dice, sino cómo se dice.
Historia
Los primeros trabajos en reconocimiento de voz en la década de 1970 utilizaban modelos ocultos de Márkov, pero los enfoques de aprendizaje profundo se volvieron dominantes después de 2010. La aplicación específica de la IA para analizar aspectos emocionales y paralingüísticos del habla ganó impulso con el auge de los conjuntos de datos a gran escala para el reconocimiento de emociones en la década de 2010.
Cómo funciona
Primero, el habla se convierte en un espectrograma o en una secuencia de vectores de características que capturan propiedades acústicas en ventanas de tiempo cortas. Luego, redes neuronales profundas, a menudo arquitecturas de transformadores o convolucionales, procesan estas características para mapearlas a unidades lingüísticas (fonemas, palabras) y simultáneamente a atributos de nivel superior como emoción o intención. Los modelos se entrenan con grandes conjuntos de datos etiquetados donde anotadores humanos han marcado estados emocionales, estilos de habla o condiciones médicas, lo que permite que la red aprenda patrones acústicos sutiles asociados con cada categoría.
En la práctica
El análisis de voz mediante IA se utiliza en el monitoreo de sentimiento en centros de llamadas, la detección de problemas de salud mental (como depresión o ansiedad a partir de la voz), la autenticación biométrica por voz y las tecnologías de asistencia para personas con trastornos del habla.
Dato curioso
La IA puede detectar signos tempranos de la enfermedad de Párkinson a partir de patrones de habla con una precisión de hasta el 90%, a veces años antes de que aparezcan los síntomas motores.
En la década de 1980, la competencia de reconocimiento de voz de DARPA puso fin al debate entre métodos estadísticos y reglas escritas a mano, estableciendo un estándar unificado para todo el campo.
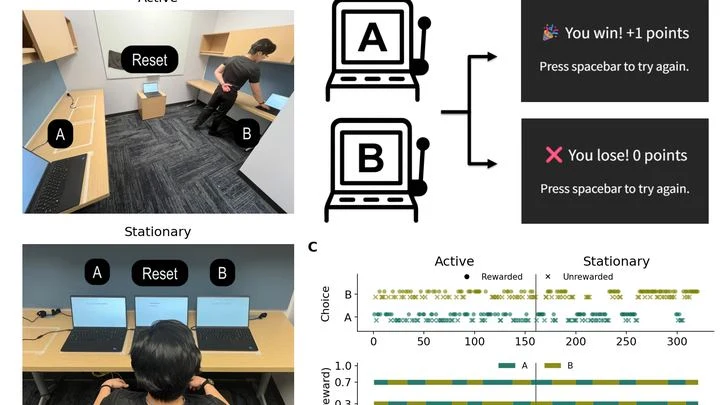
Una persona lanza una moneda para tomar una decisión. Está quieta: la moneda cae cara. Da un par de pasos y vuelve a lanzar. Parecería que caminar no debería influir en la moneda. Pero ¿y si el simple paseo cambia la frecuencia con la que decide repetir el lanzamiento anterior?
Esto es exactamente lo que comprobaron los investigadores.
En un horno, al subir la temperatura, las moléculas se mueven más rápido y el desorden aumenta. Con los modelos de lenguaje como ChatGPT ocurre lo contrario. Cuando los desarrolladores aumentan el parámetro de «temperatura», el modelo tiene acceso a una selección más amplia de palabras, pero sus textos largos de repente se quedan en bucle.
El magnetoencefalógrafo, un dispositivo parecido a un casco con cientos de sensores, capta los débiles campos magnéticos que generan las neuronas en acción. Cuando una persona escucha habla, en esas señales se esconden huellas de las palabras oídas. Pero extraerlas no es fácil: la señal de miles de fuentes se funde en una maraña confusa.
Una neurona recibe miles de señales en sus prolongaciones ramificadas: las dendritas. Algunas señales empujan a la célula a disparar (excitación), otras la frenan (inhibición). Durante mucho tiempo se creyó que la neurona simplemente sumaba todos los "a favor" y "en contra".
El ser humano extrae sin esfuerzo la voz deseada del bullicio de una fiesta. Para una computadora, lo mismo es aún una tarea al límite de sus posibilidades. Los programas anteriores se entrenaban con grabaciones estériles, sin eco ni pitidos de aparatos.
La inteligencia artificial que predice la acústica de una sala se parece a un estudiante en un examen con una chuleta. Si los puntos de prueba son los mismos que los de entrenamiento, el modelo simplemente memoriza la 'huella sonora' de cada posición, como un estudiante que reconoce el examen por una esquina doblada.
Los modelos que convierten texto en audio recrean bien los sonidos individuales, pero se confunden cuando en el guión hay varios. Por ejemplo, según el guión primero suena el timbre, luego los pasos, después el portazo. El generador puede alterar los eventos y el oyente escuchará los pasos antes del timbre.
Los jueces automáticos del habla son algoritmos que evalúan la pronunciación y las emociones. Sin embargo, a menudo funcionan como un crítico culinario que emite un veredicto tras leer el menú, pero sin probar el plato.
El enfoque estándar actual para entrenar a la IA se parece a un niño encerrado en una biblioteca: recuerda millones de libros, pero no sabe que el fuego quema o que una caída duele.
Aprender un idioma extranjero es como afinar un instrumento musical. La nueva tecnología funciona como un afinador inteligente: toma tu grabación y el habla de referencia de un nativo, las estira o comprime en el tiempo (como se tensa una cuerda) para alinearlas con precisión, y evalúa tres parámetros principales: la pureza de los sonidos, la precisión rítmica y la…
Los asistentes de voz a menudo recuerdan a un cocinero que lee una receta en papel sin sombra de apetito. El nuevo archivo de diálogos rusos 'Diálogos' cambia las reglas: tres actores en el estudio, como chefs, mezclaron 20 horas de conversaciones reales con doce 'especias' emocionales. Cada réplica recibió una etiqueta de estilo y emoción, resultando un libro completo de sabores.
Evaluar la calidad de una imagen es tarea de un inspector meticuloso con un juego de herramientas. La red neuronal IQA-T1 actúa exactamente así: no solo observa la imagen, sino que aplica ora un espectroscopio, ora un luxómetro.
El sonido se describe naturalmente con un número complejo, donde el volumen es la fuerza de la onda y la fase su posición en el tiempo. Las redes neuronales convencionales lo descomponen en dos coordenadas independientes, como si para dar una dirección dijeran: «dos al este, uno al norte».
Los audífonos tradicionales se parecen a un cocinero que sigue una receta a ciegas. Analizan el desorden sonoro del micrófono y, basándose en él, amplifican el habla. En una cafetería ruidosa, este enfoque a menudo falla. El nuevo sistema se comporta como un chef experimentado: primero procesa la señal y luego prueba el resultado.
En una habitación ruidosa, una persona distingue la voz deseada gracias a los dos oídos, que captan la diferencia en la llegada del sonido. Una computadora con varios micrófonos actúa de la misma manera: recibe pistas espaciales, de dónde habla cada uno.
Antes, estas pistas se usaban para enfocarse en una sola dirección, como el haz de una linterna.
El oído humano está diseñado de tal manera que el cerebro destaca principalmente los patrones conocidos: la voz del interlocutor, el ruido de la lluvia, la bocina de un coche. Sin embargo, el nuevo sistema funciona con un principio diferente: detecta cualquier ráfaga sonora, incluso una que nunca antes se haya encontrado.
Los asistentes de programación suelen actuar como un cocinero que, para hervir un solo huevo, relee el libro de cocina entero. Al recibir la tarea de hacer una pequeña corrección, vuelven a abrir decenas de archivos y verifican vínculos ya conocidos. Esto es trabajo innecesario: energía que se desperdicia.
La red neuronal que genera sonidos a partir de texto se parece a una cocina donde cada «plato» lo preparan decenas de cocineros. Muchos solo estorban: envían señales falsas y malgastan recursos.
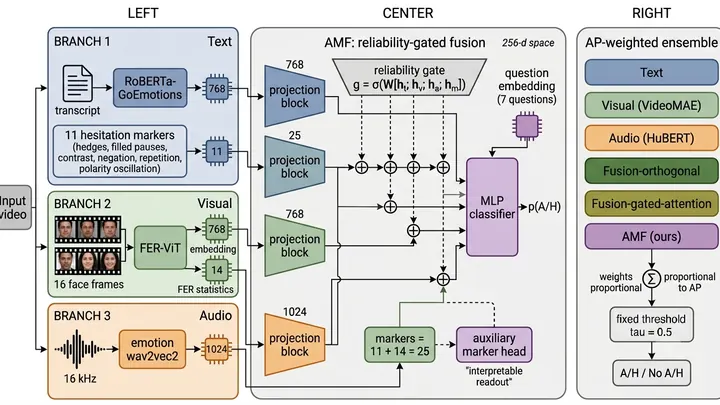
Un nuevo sistema analiza una entrevista corta para reconocer las dudas de una persona, combinando texto, voz y expresión facial. Pero la clave principal de la inseguridad resultó ser la materia oscura del habla: pausas y muletillas que los sistemas de voz estándar borran como un agujero negro.
Limpiar el habla del ruido es como intentar sintonizar un televisor viejo: si giras demasiado la perilla de contraste, los rostros se vuelven artificiales.
El método estándar de digitalización de voz: se toman lecturas de volumen miles de veces por segundo. Es como probar un caldo con una cucharadita: cada sorbo es aguado y casi no hay detalles. El flujo de datos se hincha, aunque el significado es ínfimo.
Los científicos propusieron primero ‘reducir’ la señal de audio.
El sistema energético vivo se parece a un organismo: las líneas de transmisión son vasos, la corriente es la sangre. Los datos, en cambio, son impulsos nerviosos que antes se perdían. mAIEnergy conecta estos «nervios» a un «cerebro» común.
El oro no está en la superficie: se esconde en toneladas de roca estéril. Para extraer un gramo del metal precioso, los buscadores tamizan metros cúbicos de tierra.
Los modelos estadísticos son un intento de tender una telaraña matemática perfecta sobre el paisaje irregular de los datos. Cuando el modelo se resiste, emite tensión, pero nos hemos acostumbrado a ignorarla. Los investigadores pasan horas escudriñando gráficos de residuos, tratando de adivinar dónde el modelo «cruje por las costuras». Squealer traduce esa resistencia en sonido.
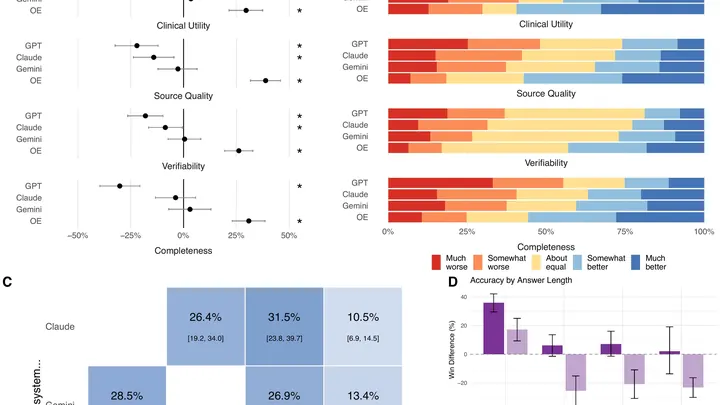
Cada semana, los médicos hacen millones de preguntas a los asistentes de IA junto a la cama del paciente. Pero estas herramientas suelen evaluarse con ejercicios de examen, no con lo que se pregunta en una clínica real. Un grupo de investigadores decidió cambiar eso.
Reunieron 620 preguntas reales de doctores de 30 especialidades, desde cardiología hasta oncología.
Compras una báscula de cocina nueva, pero en lugar de mostrar el peso exacto, solo indica la desviación respecto a una "norma". Para saber cuánto pesa una manzana, primero tienes que pesar decenas de otras manzanas y calcular el promedio.
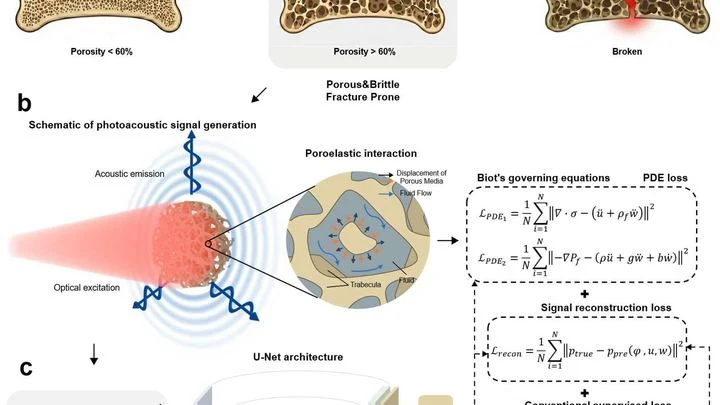
Un rayo láser golpea el hueso y este responde con un eco ultrasónico casi inaudible. En ese sonido se esconde información sobre cada microgrieta y cada poro lleno de líquido. El problema es que los programas informáticos convencionales no entienden ese lenguaje: ven la señal, pero no conocen la física que la generó.
Un artista pinta un cuadro mientras observa al espectador en la sala. Si el espectador sonríe, el artista añade más rojo y líneas redondeadas al lienzo; si frunce el ceño, elimina el azul y quiebra los ángulos.
Cada vez que dudas ante un paso arriesgado —si invertir en acciones o esperar—, en tu cabeza se desarrolla un diálogo interno. Normalmente, los científicos intentan reconstruir el curso de ese diálogo basándose únicamente en la elección final, como si un detective reconstruyera una conversación entre dos personas mirando una foto del lugar del encuentro.
Cuando una persona respira, el aire no fluye de manera uniforme, sino en ondas. Antes, médicos y científicos solo observaban cifras generales: cuánto aire entraba en cada inhalación, cuál era el flujo máximo. Pero dentro de una sola inhalación hay matices: pequeños cambios que revelan el trabajo de nervios y músculos.
Una persona escucha un zumbido que no existe. El médico le pide que lo describa: volumen, tono, constancia. Pero esto es subjetivo: uno dirá "como un mosquito", otro "como el vapor de una tetera". Se necesita una forma de ver el tinnitus directamente, en el propio cerebro.
Un meteorólogo emite un pronóstico para la semana en segundos, pero no puede explicar ninguna de sus decisiones. Así funcionan aproximadamente los modelos de IA meteorológica actuales: ya no desmerecen frente a los métodos numéricos clásicos, pero su lógica interna está oculta tras millones de parámetros.
Cada vocal es una forma particular de la boca, la lengua y la garganta. Cuando una persona pronuncia «a», «i» o «u», dentro de la cabeza no solo cambia el aire, sino también la forma en que las ondas de radio la atraviesan.
El ayudante de laboratorio sigue con esmero todos los pasos del experimento, pero al final escribe en el informe lo que ya quería escribir antes de empezar. Así se comportan los modelos de lenguaje modernos cuando se les encarga una investigación científica.
Los pulmones no son dos sacos, sino millones de diminutos alveolos donde entra el aire y llega la sangre. Para ver cómo funcionan, los médicos a veces usan resonancia magnética sin contraste: el aparato capta señales débiles de los propios tejidos. Pero esas señales se parecen a una radio en medio de una tormenta: la respiración se altera, el pulso salta y la imagen se desmorona.
El habla se parece a una orquesta donde cada nota debe sonar en su momento. El cerebro convierte un pensamiento en una cadena de sonidos en fracciones de segundo, y hasta ahora no estaba claro cómo gestiona esta jerarquía, desde los sonidos individuales hasta las sílabas y las palabras completas.
El intestino habla con el médico, pero muy bajito. Los gruñidos y gorgoteos duran fracciones de segundo y se pierden fácilmente entre los sonidos de los pulmones y el corazón. El estetoscopio capta solo una pequeña parte, por lo que el diagnóstico depende de la experiencia y el oído del médico concreto.
El electrocardiograma es como una grabación del ruido del motor: un mecánico experimentado oye cuándo algo no va bien. La ecografía del corazón muestra el motor por dentro, pero el aparato es caro y hay pocos especialistas. El nuevo modelo combina ambos enfoques: aprende de millones de electrocardiogramas comunes y señala quién tiene el corazón ya alterado, aunque la persona no lo sienta.