Chasser les gènes en un mot express
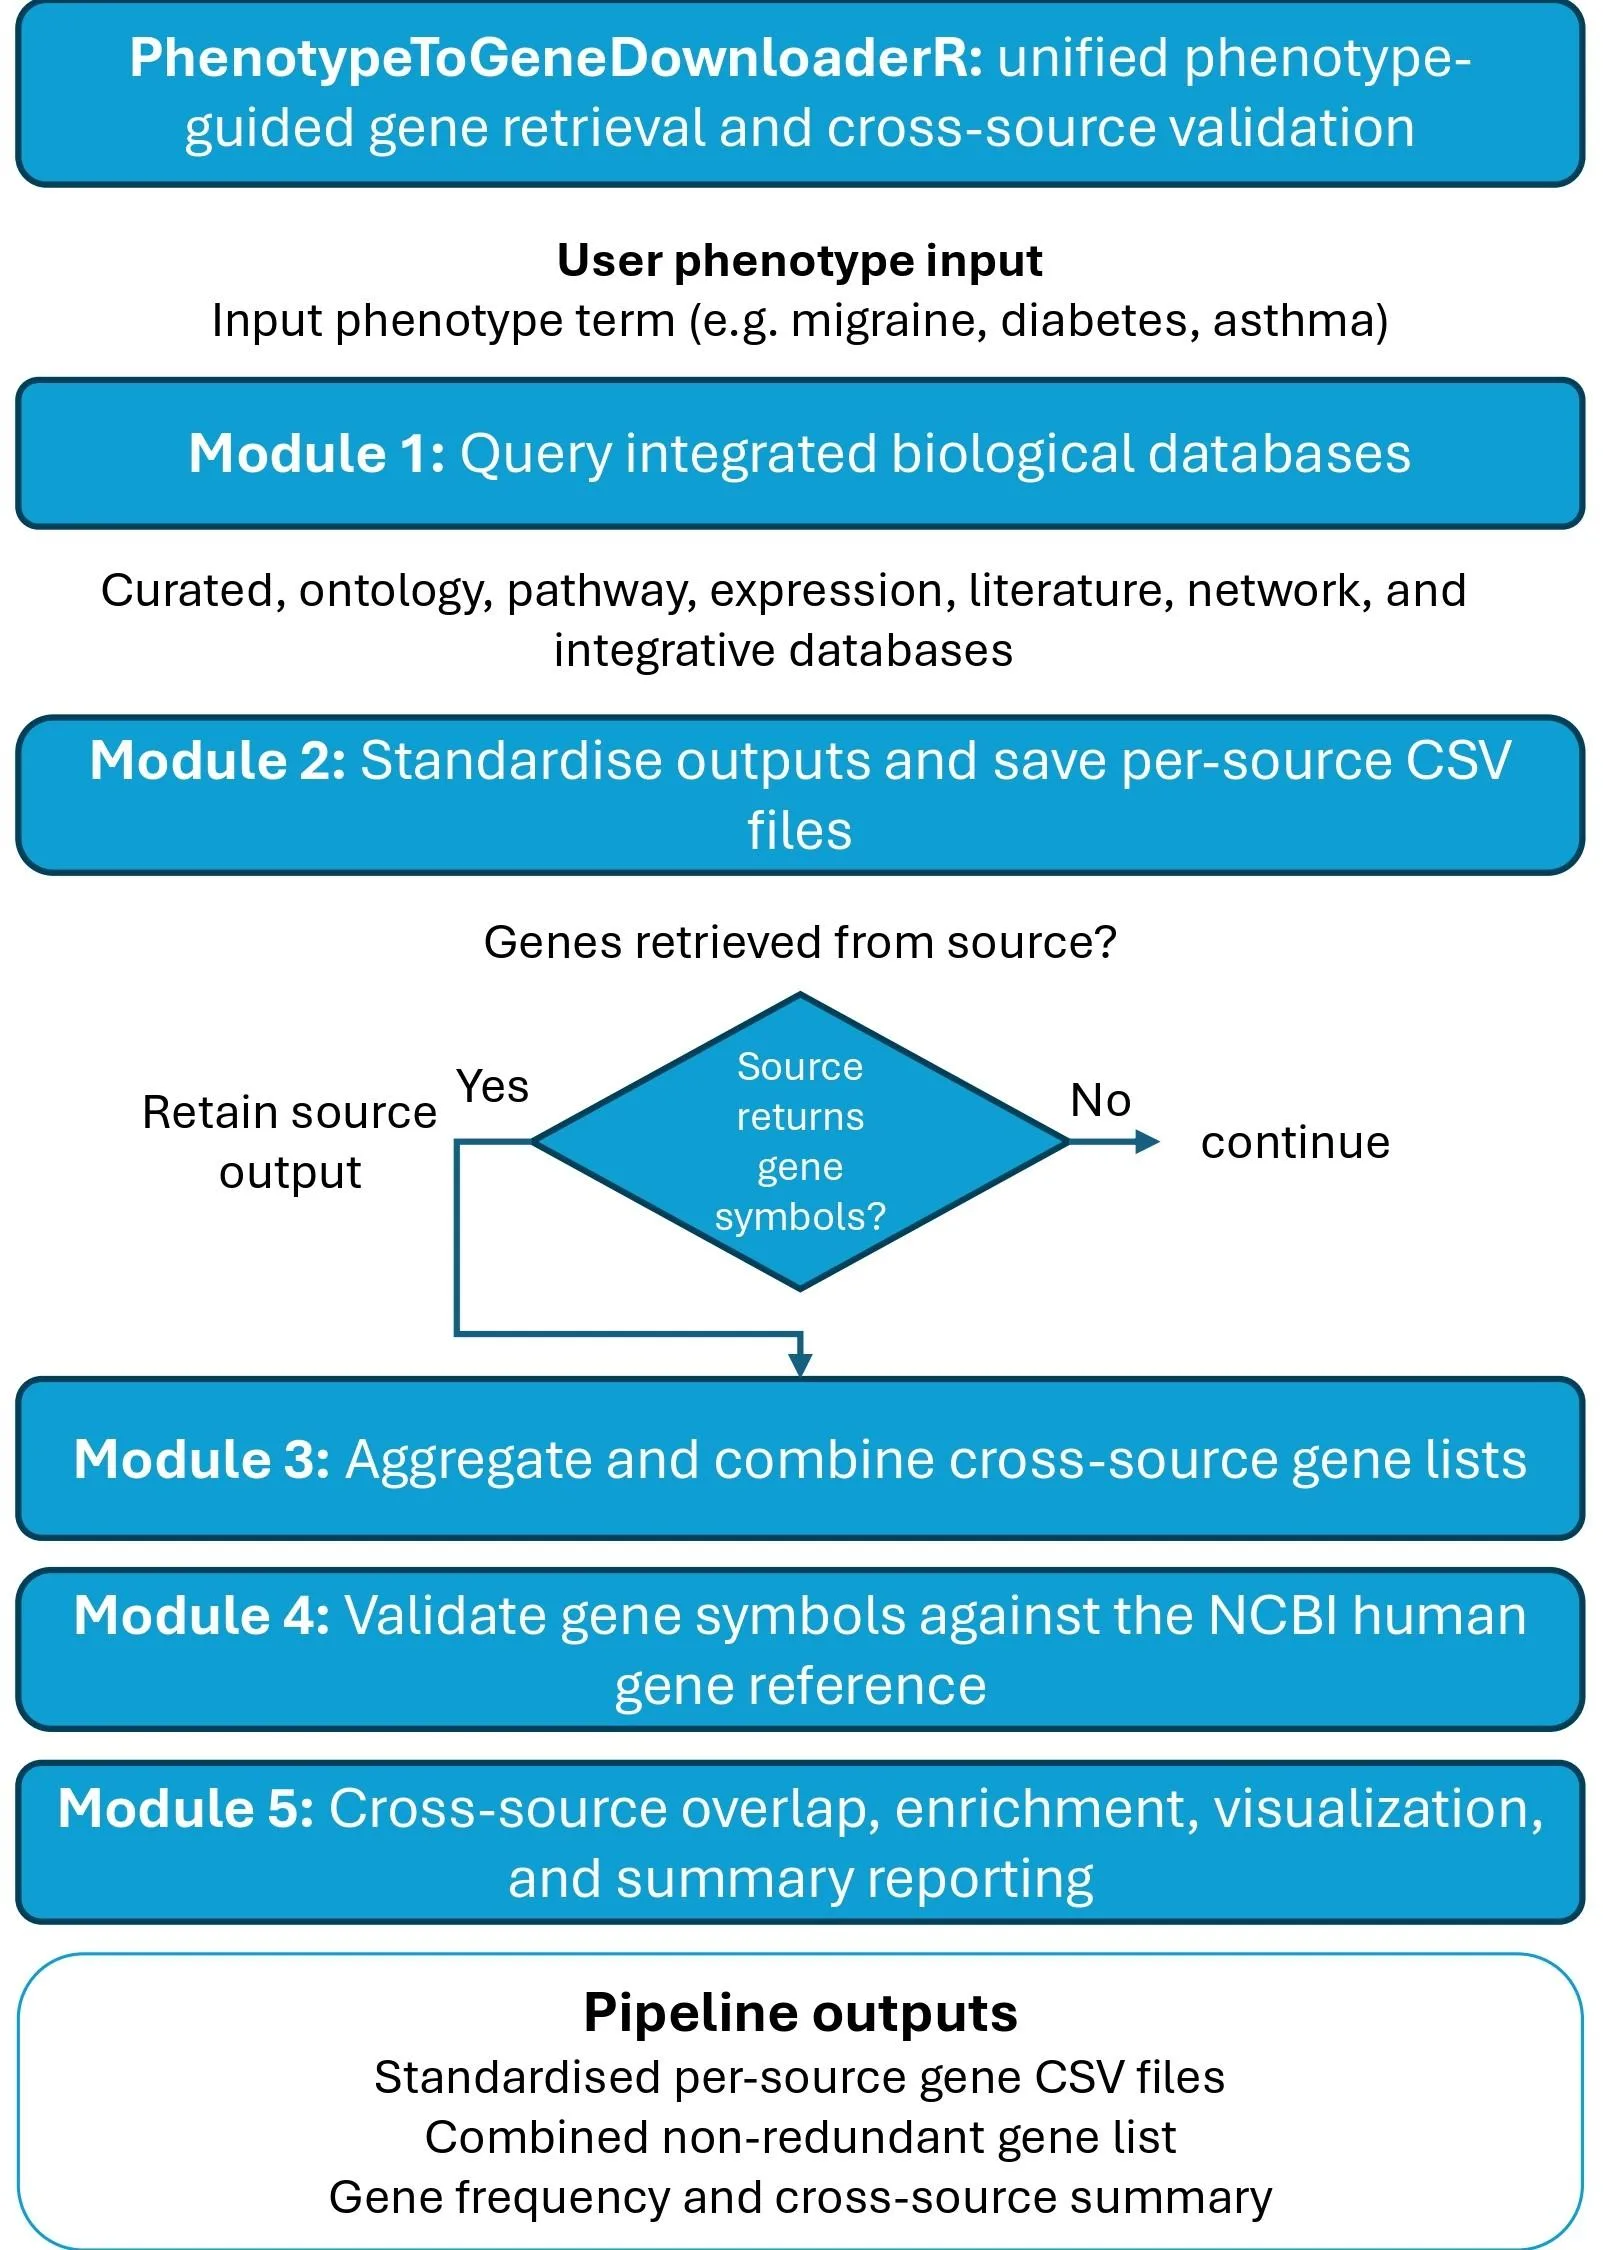
Assembler un puzzle dont les pièces sont éparpillées dans 13 boîtes avec des systèmes de numérotation différents — voilà à quoi ressemble la recherche des gènes associés à une maladie précise. Les données existent, mais elles sont cachées dans des bases avec leurs propres interfaces, formats et même langage de description. Le nouveau programme PhenotypeToGeneDownloaderR joue le rôle de traducteur et de trieur : vous lui donnez le nom d'une maladie, et il parcourt lui-même tous les entrepôts, extrait les listes de gènes et les ramène à un dénominateur commun.
Les listes collectées ne coïncident souvent pas entre elles — chaque base voit le problème sous son propre angle, et c'est là la force de l'approche : en les combinant, on obtient une image plus complète. Lorsque le programme a été testé par rapport au « gold standard » de trois sources faisant autorité (HPO, ClinVar et OMIM), il a trouvé 1039 gènes sur 1056 connus, soit 98,4 %. Cela signifie que presque rien n'est manqué, et le superflu est minime. Un tel outil économise des semaines de travail manuel et réduit le risque d'erreur lorsque un médecin ou un chercheur transcrit manuellement les noms d'un système à un autre.
Résumé original
tel que rédigé par les auteurs, en anglais arXiv:2605.01378
Identifying phenotype-associated genes is a common first step in polygenic risk score construction, enrichment testing, target prioritisation and variant interpretation, but relevant evidence is distributed across heterogeneous databases with different interfaces, formats and evidence models. Here, we present PhenotypeToGeneDownloaderR, a phenotype-guided R/Python pipeline for automated gene retrieval, harmonisation, symbol validation and cross-source summary analysis. Given a phenotype term, the pipeline queries integrated biological databases, standardises per-source outputs, combines gene lists, validates retrieved symbols against the NCBI human gene reference and generates summary tables and visualisations. Across 13 clinically relevant phenotypes and 13 databases, PhenotypeToGeneDownloaderR generated 136,487 raw gene retrievals, with at least one source returning genes for every phenotype. Across all 13 phenotypes, 100,175 of 114,345 combined input symbols were retained after direct or synonym-based validation, corresponding to an 87.6\% validation rate. Cross-source overlap was low, supporting the complementarity of integrated evidence sources. Against an HPO/ClinVar/OMIM-derived gold standard, the pipeline recovered 1,039 of 1,056 known phenotype-associated genes, corresponding to 98.4\% recall. PhenotypeToGeneDownloaderR provides a lightweight, reproducible upstream framework for generating candidate gene sets for downstream prioritisation and interpretation. The pipeline is implemented in R and Python, released under the MIT licence, and available at https://github.com/MuhammadMuneeb007/PhenotypeToGeneDownloaderR.
Les noms de gènes changent parfois comme les adresses des rues lors d'un renommage de ville — sans vérification dans un répertoire à jour, on peut citer pendant des années une « vieille maison » qui n'existe plus sur les cartes officielles.