Радионебо на плечах добровольцев: как гражданская наука учит ИИ видеть сложные галактики ✛
Контекст
Новое поколение широкоугольных радиотелескопов, таких как ASKAP, за одну ночь собирает данные о миллионах источников. Автоматические алгоритмы хорошо справляются с компактными объектами, но пасуют перед протяжёнными структурами с причудливой морфологией: джетами, мостами, пузырями. Вокруг этой задачи уже сложилось целое направление: одни группы ищут радиосигналы техногенного происхождения, другие строят карты сотен тысяч галактик с помощью нейросетей, третьи ловят призрачное свечение на краях скоплений. Работа RGZ EMU стоит на отшибе: она не открывает новые источники, а создаёт эталонные разметки, без которых все эти карты и поиски останутся сырыми.
Методы
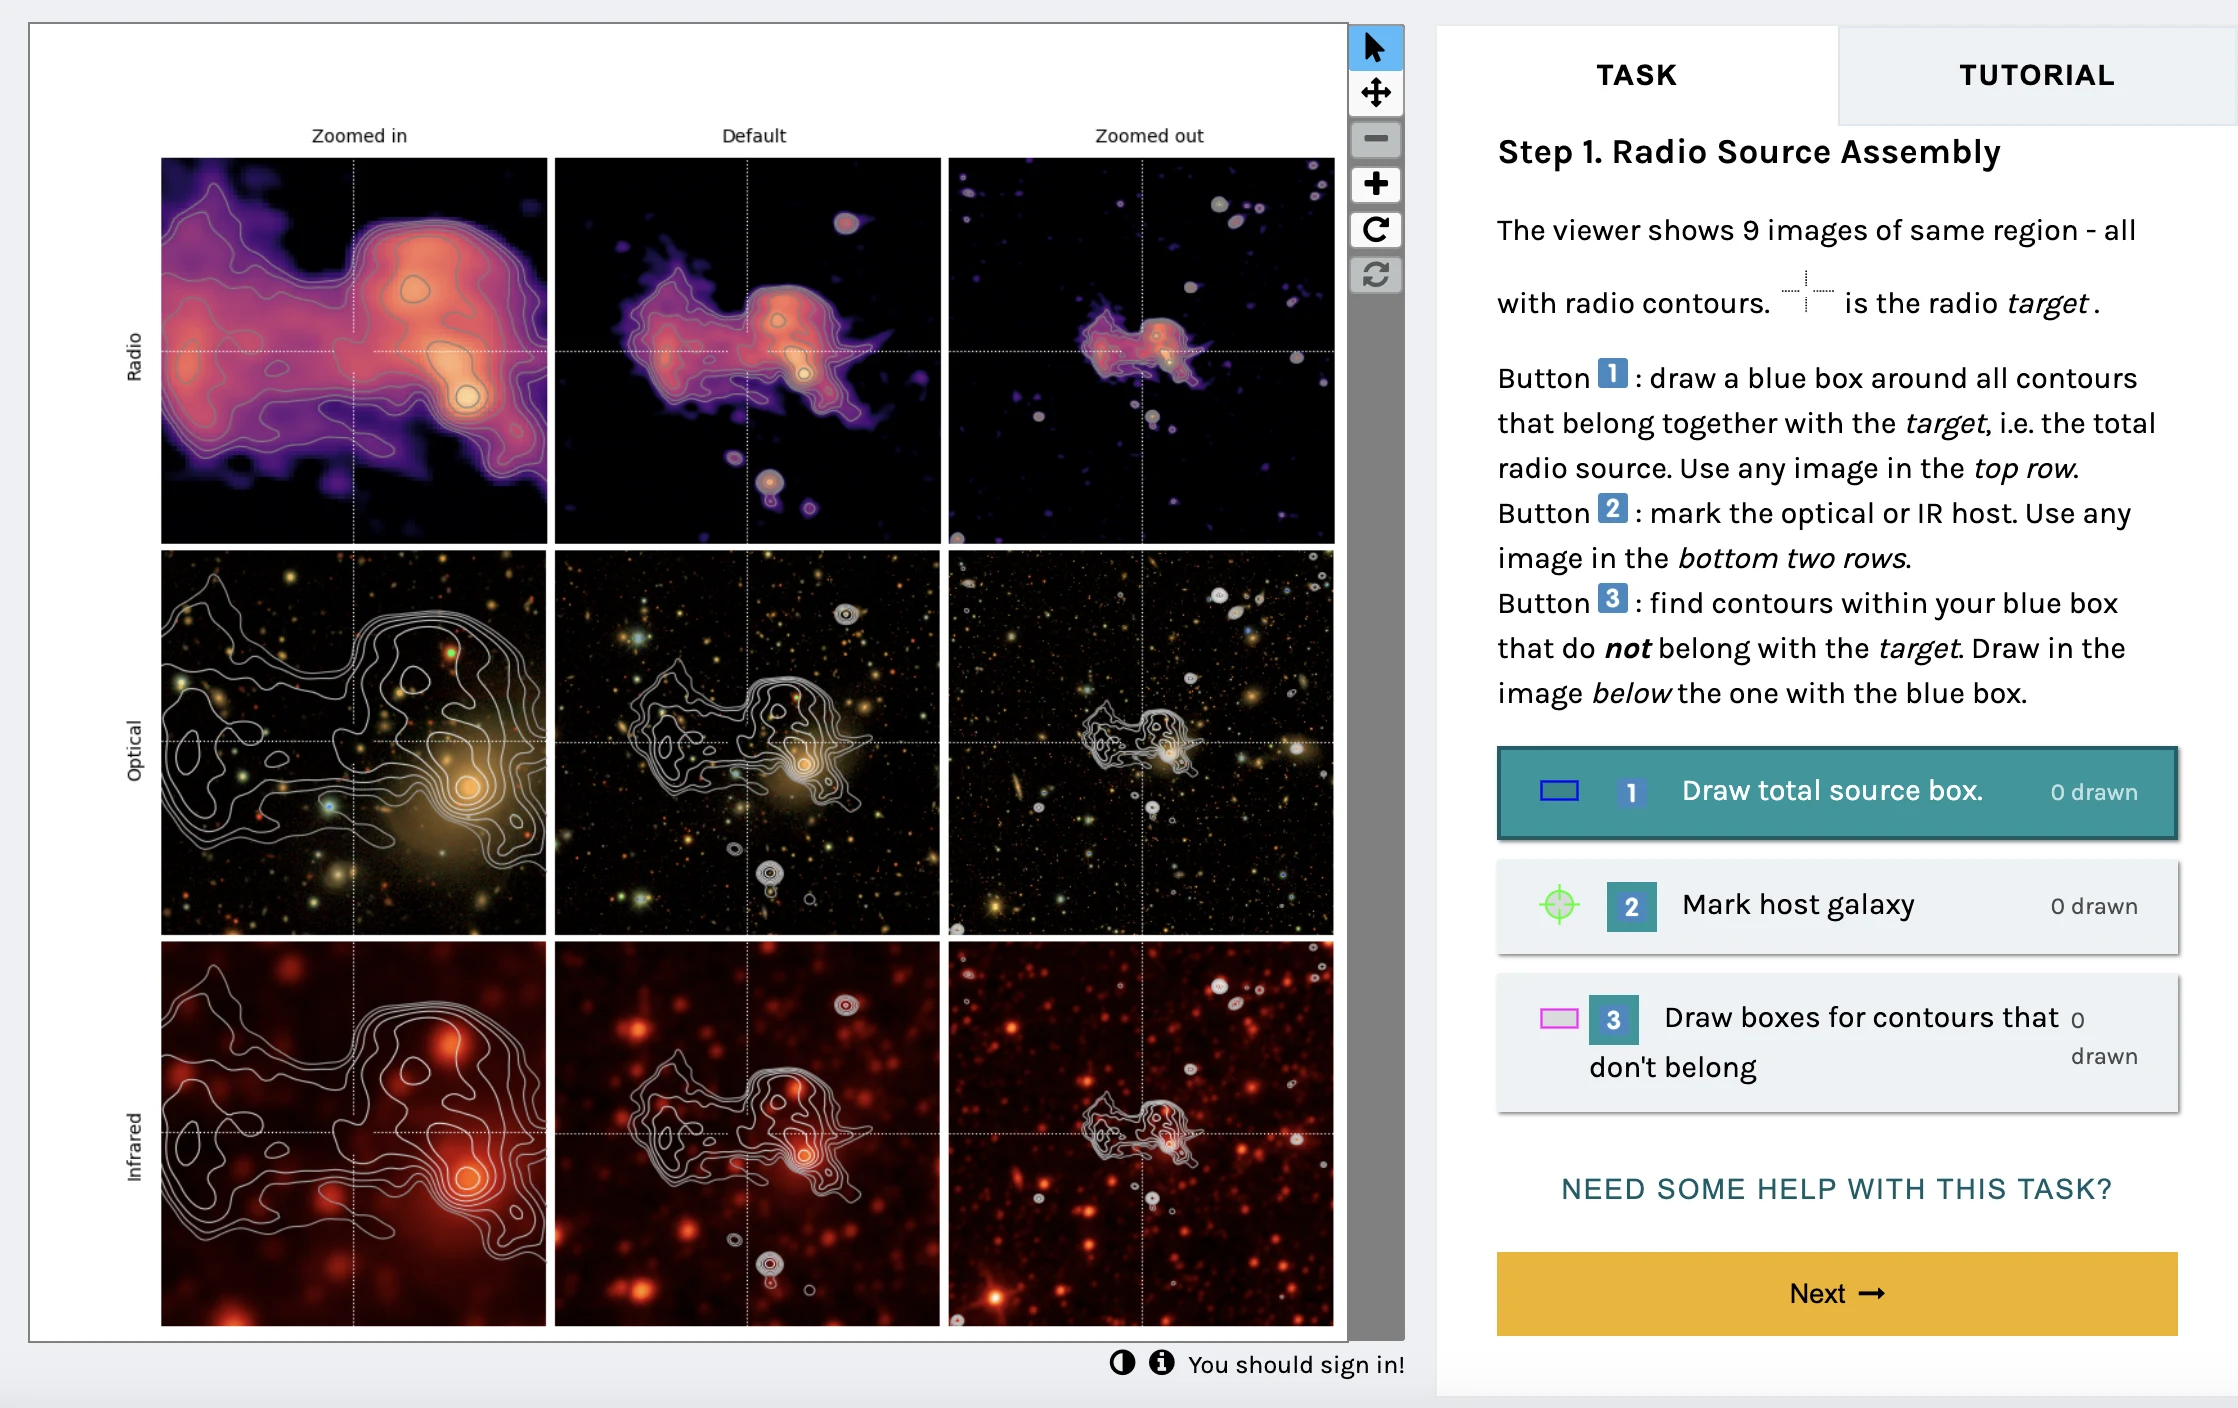
В основе работы — гибридный конвейер, где человек и машина дополняют друг друга. Сначала из каталога Selavy отбирают источники с высокой морфологической сложностью: для этого используют грубую меру Колмогорова, которая оценивает, насколько плохо изображение сжимается, то есть насколько богата его внутренняя структура. Затем к сложности добавляют угловой размер, чтобы добровольцам доставались самые интересные и крупные объекты. На платформе Zooniverse волонтёры отмечают связанные радиокомпоненты, находят родительские галактики и присваивают простые теги вроде «песочные часы», «изогнутый», «следы родительской галактики». Эти теги родились из семантической таксономии, построенной методами обработки естественного языка: сначала из описаний выделили 22 морфологических признака, затем свели к набору примерно из десяти интуитивных ярлыков. Так возникает общий словарь, понятный и человеку, и алгоритму.
Результаты
За первый этап более 2500 добровольцев выполнили около 97 000 классификаций. Предварительный анализ показывает, что коллективная точность волонтёров приближается к консенсусу экспертов, как только набирается достаточное число независимых ответов. Это согласуется с более ранними результатами проекта Galaxy Zoo и подтверждает пригодность «золотых образцов» для обучения моделей. Особенно ценны редкие и неоднозначные источники, где автоматические пайплайны чаще ошибаются. Многоязычное развёртывание (греческий, китайский, урду, японский) подчёркивает открытость проекта и расширяет пул участников.
Значение
Работа даёт эталонные разметки для обучения глубоких моделей, чего не хватало соседним проектам, которые полагались либо на чистую автоматику, либо на ограниченные экспертные выборки. Отличие от ближайших соседей — в масштабе и системности: здесь не ищут сигналы пришельцев и не строят карты по одному алгоритму, а создают размеченный корпус, который можно использовать многократно и в разных задачах. Это первая проверка гибридного подхода на реальных данных EMU, где сложность источников выше, чем в прежних обзорах.
Развитие
В ближайшие пять лет проект расширится на весь обзор EMU и охватит около четырёх миллионов протяжённых источников. Активное обучение замкнёт петлю: модели будут предлагать наиболее информативные объекты для разметки, а новые разметки — улучшать модели. Такой цикл станет испытательным стендом для надёжного ИИ перед запуском Square Kilometre Array, где объёмы данных вырастут на порядки.
Влияние
Результаты напрямую повлияют на каталог EMUCAT и подготовку к SKA, а также на межволновые исследования с обзорами POSSUM, WALLABY, PEGASUS и Euclid.
Следующие шаги
Масштабирование на полный EMU, интеграция с активным обучением и выпуск первой версии каталога с гибридными классификациями.
Ключевые проблемы
Для радиоастрономии остаётся открытым вопрос, как автоматически распознавать редкие морфологии без предвзятости обучающей выборки. Гражданская наука даёт способ собрать разнообразные примеры, но не решает проблему смещения: добровольцы тоже предпочитают яркие и необычные объекты. Долгосрочная задача — понять, где человеческая интуиция незаменима, а где алгоритм уже превосходит её.
Взгляд машины знаний
Этот раздел адресован автору работы и его коллегам. Соседние работы нашёл смысловой поиск по нашему архиву — не по совпадению слов, а по смыслу. Мы не рецензируем: мы показываем поле вокруг.
Что сделано в работе
Работа описывает проект Radio Galaxy Zoo EMU: краудсорсинговую разметку 6230 сложных радиоисточников обзора EMU силами 2500 добровольцев, которые выполнили около 97 000 классификаций. Использована гибридная схема: автоматический отбор по морфологической сложности (мера Колмогорова) и угловому размеру, затем ручная разметка на платформе Zooniverse с тегами из семантической таксономии, построенной методами NLP. Результатом станут открытый каталог EMUCAT и тренировочные данные для моделей, готовящихся к эпохе SKA.
В чём сила
Сила работы в создании эталонного размеченного корпуса для сложных протяжённых радиоисточников, полученного через согласованный словарь тегов, понятный и людям, и алгоритмам. Масштаб и системность подхода дают основу для обучения глубоких моделей там, где автоматические пайплайны часто ошибаются.
Куда можно двигаться
- Может быть интересно сравнить полученные разметки с результатами автоматической классификации, описанной в работе, где нейросеть без подсказок открывает новые галактики: это позволит оценить, насколько модели, обученные на данных RGZ EMU, улучшают обнаружение редких морфологий.опора: Нейросеть без учителя открывает новые галактики arXiv:2511.05439
- Рядом лежит работа, где нейросеть нарисовала карты 639 тысяч галактик: можно попробовать использовать размеченные источники RGZ EMU как дополнительный тренировочный набор для улучшения качества карт протяжённых структур.опора: Нейросеть ZooBot:3D построила структурные карты 639 тысяч галактик arXiv:2606.16507
- В архиве есть полный разбор исследования, кто скрывается в радиосвете галактик: там обсуждается связь морфологии с физикой источников, и ваши теги могли бы помочь в интерпретации таких связей для выборки EMU.опора: Радиокарта трёх галактик: компактные источники против диффузного фона arXiv:2507.23332
Что можно попробовать
- Проверить, насколько теги из семантической таксономии коррелируют с физическими параметрами источников (например, redshift, мощность), используя каталог из полного разбора.
- Обучить модель на текущих разметках и сравнить её предсказания с консенсусом волонтёров на новых данных, чтобы оценить прирост точности.
- Использовать подход с NLP для автоматического расширения таксономии на основе описаний редких источников, отмеченных волонтёрами.
Почему это может быть важно
Эталонные разметки сложных радиоисточников критичны для подготовки к потоку данных SKA, где ручная проверка каждого объекта станет невозможной. Открытый корпус RGZ EMU может стать стандартом для обучения и валидации алгоритмов классификации, улучшая надёжность автоматических каталогов и освобождая экспертов для анализа действительно необычных объектов.
Работы рядом в нашем архиве
- Нейросеть ZooBot:3D построила структурные карты 639 тысяч галактикблизость 0.52
- Пять тысяч гигантов на радиокарте небаблизость 0.51
- Гравитационные сирены: где искать ключ к тёмной Вселеннойблизость 0.50
- Космос натренировали предсказыватьблизость 0.50
- Свет далёких галактик: как отличить спокойные от бурныхблизость 0.50
- Нейросеть без учителя открывает новые галактикиблизость 0.49
- Радиокарта трёх галактик: компактные источники против диффузного фонаблизость 0.49
Вокруг этой работы в архиве пусто: ближайший разбор всего на 0.52, при обычных 0.64. Похоже, рядом почти не бурили.
Один из тегов для классификации — «песочные часы»: так выглядят радиогалактики с двумя симметричными лепестками, напоминающие фигуру, по которой отмеряли время в древности.
Ключевые числа
- количество классификаций: 97 000
- число волонтёров: более 2500
- размер выборки Phase I: 6230 протяжённых источников
- чувствительность обзора EMU-PS: 25–30 мкЯн/луч
- угловое разрешение: 11–18 угловых секунд