46 способов посчитать риск экспресс
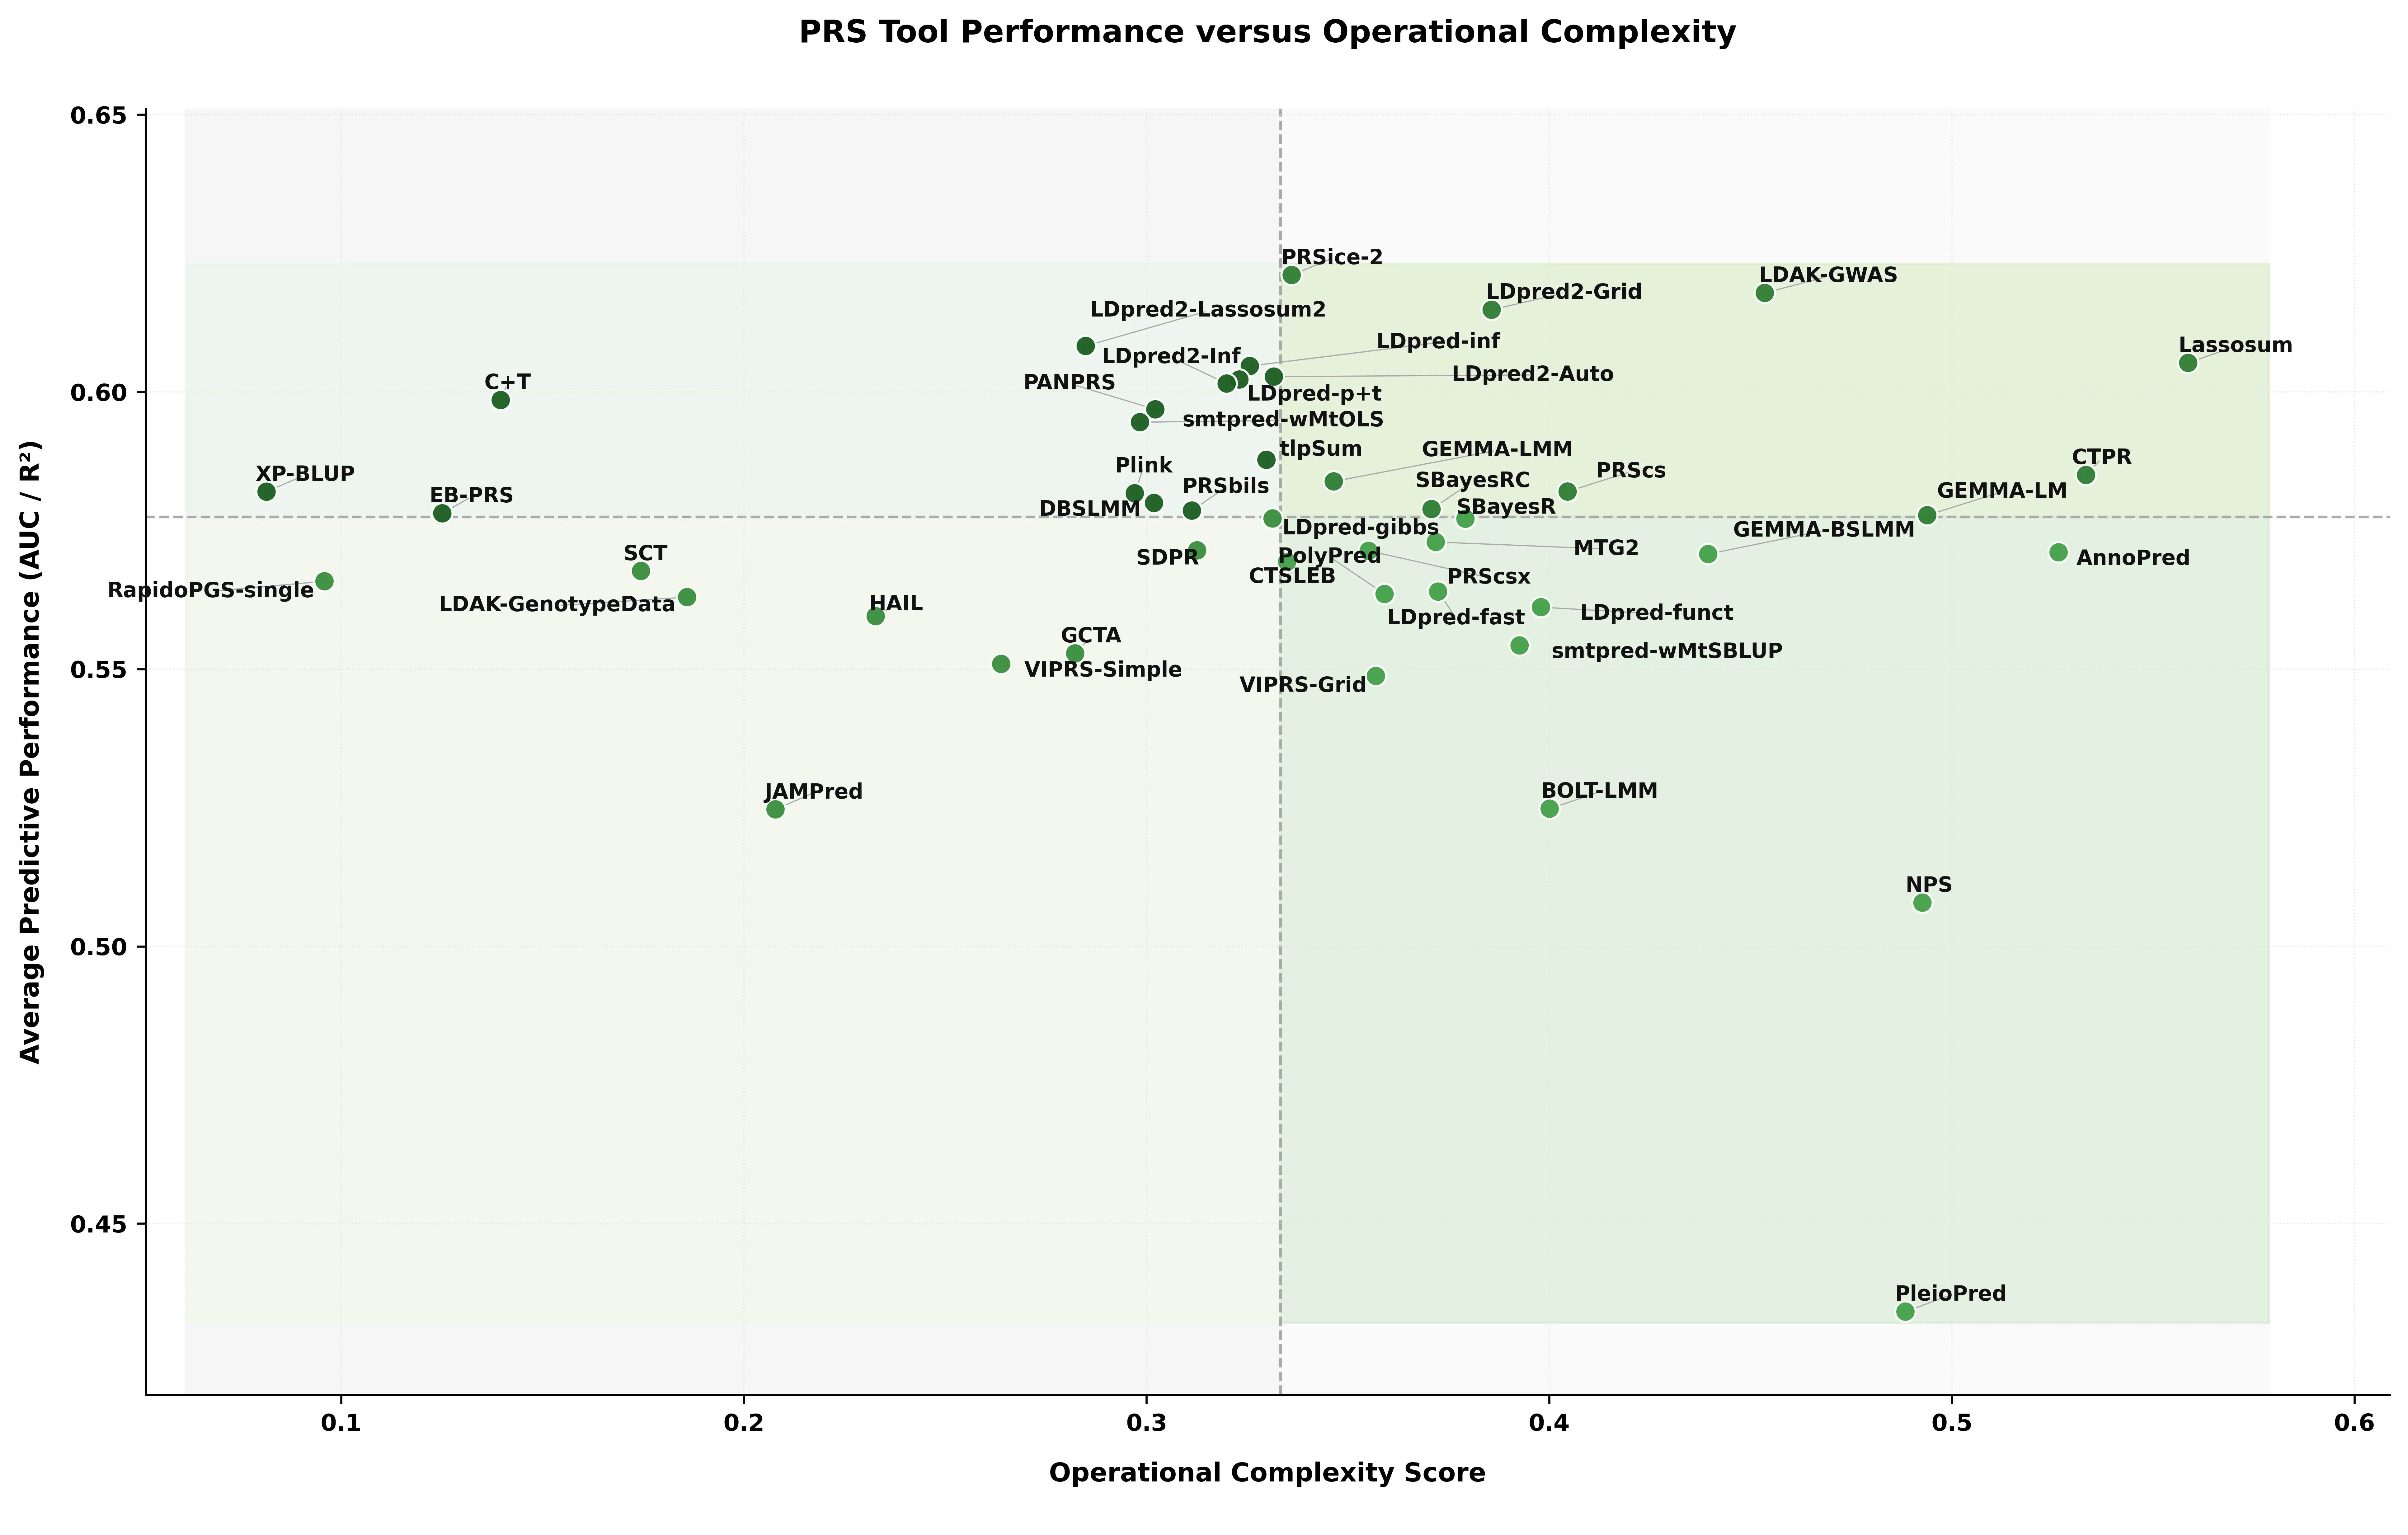
Генетики читают ДНК как длинный список букв. Из него они складывают «оценку полигенного риска» — число, которое показывает, насколько у человека выше или ниже среднего шанс заболеть, например, диабетом. Таких способов посчитать риск сейчас десятки, и каждый делает это по-своему: один смотрит на тысячу букв, другой — на миллион, третий требует мощный компьютер, четвёртый падает на половине данных.
Авторы работы собрали 46 таких инструментов и устроили им честный экзамен. Взяли данные из британского биобанка — там хранятся образцы ДНК и медицинские карты сотен тысяч людей. Каждый инструмент должен был предсказать семь заболеваний и один обычный признак (например, рост). Проверяли в трёх ситуациях: без дополнительных данных, только по ДНК, и вместе с возрастом, полом и другими сведениями. Оказалось, что универсального победителя нет: один инструмент хорош для диабета, другой — для астмы, а третий быстрее всех, но чуть менее точен.
Практический вывод простой: выбор инструмента — это не только про математику. Нужно смотреть, сколько у вас данных, какой мощности компьютер, умеет ли программа не ломаться на середине расчёта. Авторы сделали свой каркас открытым, чтобы любой исследователь мог повторить сравнение на своих данных и не наступать на те же грабли.
Оригинальная аннотация
как её написали авторы, на английском arXiv:2603.21201
Polygenic risk score (PRS) tools differ substantially in statistical assumptions, input requirements, and implementation complexity, making direct comparison difficult. We developed a harmonized, implementation-aware benchmarking framework to evaluate 46 PRS tools across seven binary UK Biobank phenotypes and one continuous trait under three model configurations: null, PRS-only, and PRS plus covariates. The framework integrates standardized preprocessing, tool-specific execution, hyperparameter exploration, and unified downstream evaluation using five-fold cross-validation on high-performance computing infrastructure. In addition to predictive performance, we assessed runtime, memory use, input dependencies, and failure modes. A Friedman test across 40 phenotype--fold combinations confirmed significant differences in tool rankings ($$\chi^2 = 102.29$$, $$p = 2.57 \times 10^{-11}$$), with no single method universally optimal. These findings provide a reproducible framework for comparative PRS evaluation and demonstrate that tool performance is shaped not only by statistical methodology but also by phenotype architecture, preprocessing choices, covariate structure, computational demands, software robustness, and practical implementation constraints.
Один из инструментов в тесте мог занимать в 100 раз больше памяти, чем другой, при почти одинаковой точности предсказаний.