46 способов посчитать риск экспресс
Генетики читают ДНК как длинный список букв. Из него они складывают «оценку полигенного риска» — число, которое показывает, насколько у человека выше или ниже среднего шанс заболеть, например, диабетом. Таких способов посчитать риск сейчас десятки, и каждый делает это по-своему: один смотрит на тысячу букв, другой — на миллион, третий требует мощный компьютер, четвёртый падает на половине данных.
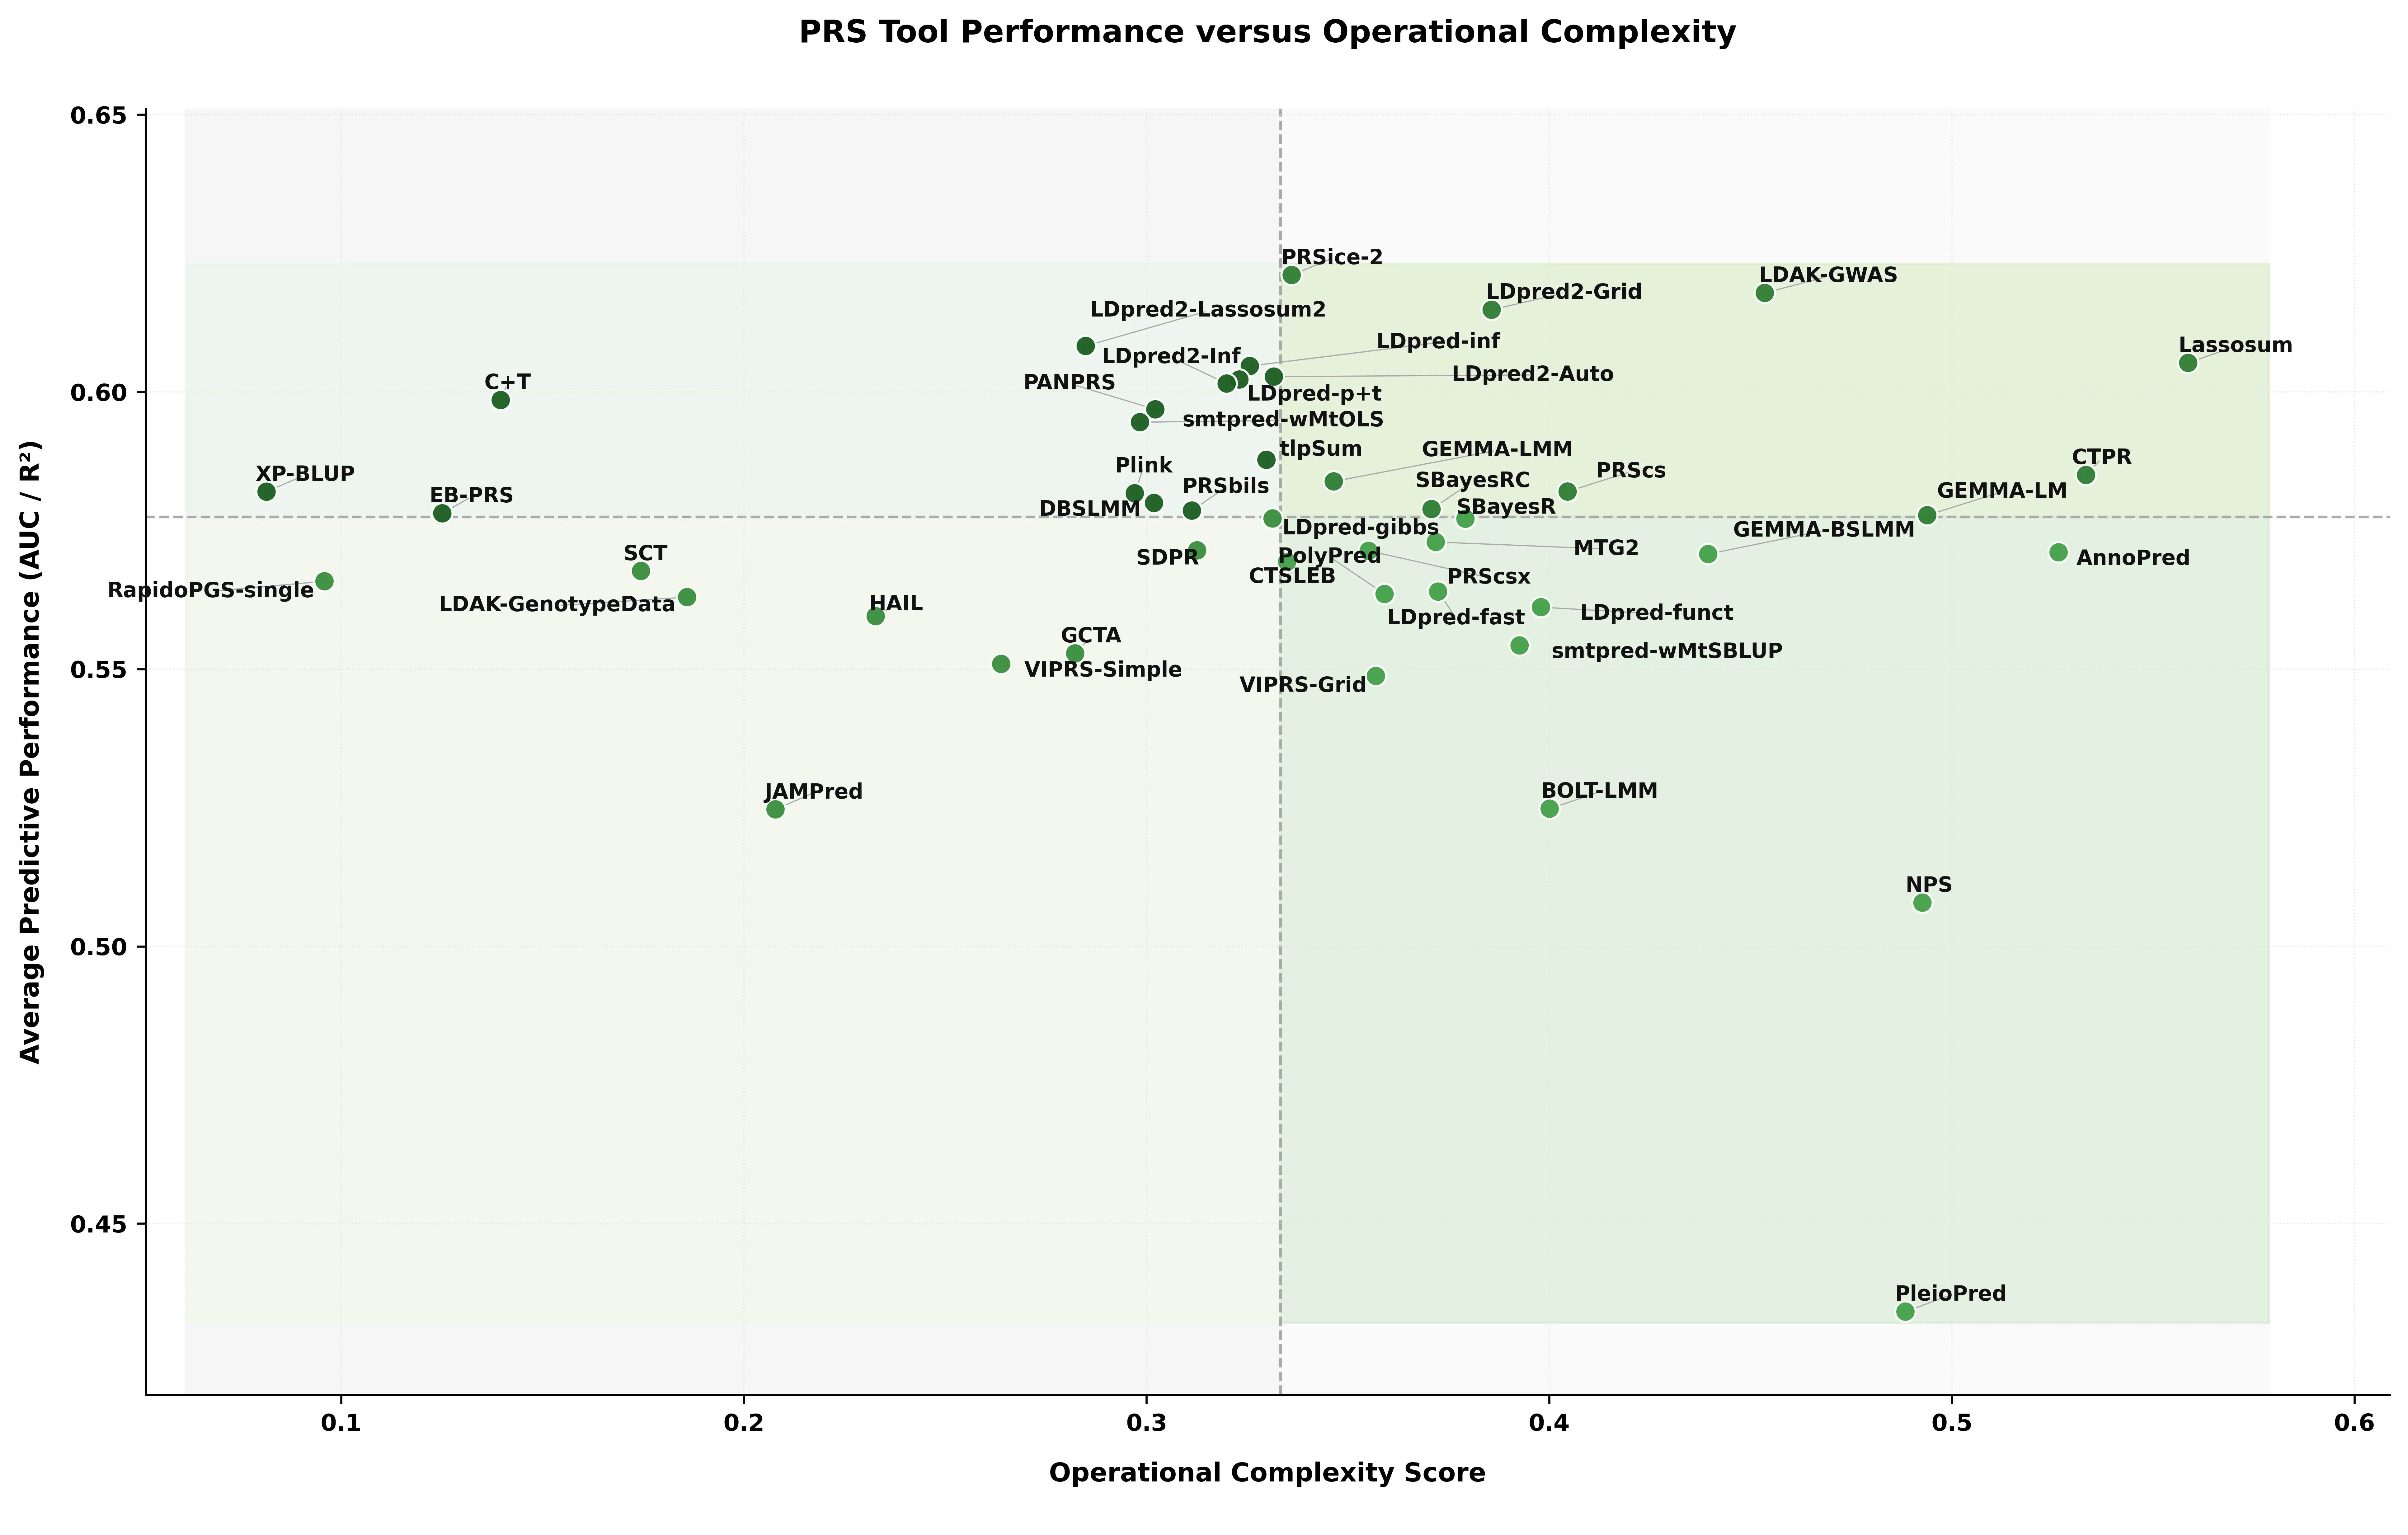
Авторы работы собрали 46 таких инструментов и устроили им честный экзамен. Взяли данные из британского биобанка — там хранятся образцы ДНК и медицинские карты сотен тысяч людей. Каждый инструмент должен был предсказать семь заболеваний и один обычный признак (например, рост). Проверяли в трёх ситуациях: без дополнительных данных, только по ДНК, и вместе с возрастом, полом и другими сведениями. Оказалось, что универсального победителя нет: один инструмент хорош для диабета, другой — для астмы, а третий быстрее всех, но чуть менее точен.
Практический вывод простой: выбор инструмента — это не только про математику. Нужно смотреть, сколько у вас данных, какой мощности компьютер, умеет ли программа не ломаться на середине расчёта. Авторы сделали свой каркас открытым, чтобы любой исследователь мог повторить сравнение на своих данных и не наступать на те же грабли.
Один из инструментов в тесте мог занимать в 100 раз больше памяти, чем другой, при почти одинаковой точности предсказаний.