كيف تكتشف النماذج اللغوية التكرارات في البروتينات سريع
البروتينات هي سلاسل من الأحماض الأمينية، وكثيرًا ما توجد فيها مقاطع متكررة. أحيانًا تكون التكرارات دقيقة، مثل نفس العبارة تُقال مرتين. وأحيانًا تكون مع أخطاء مطبعية: حرفان مُستبدلان، لكن المعنى واحد. هذه التكرارات مهمة: فهي تساعد البروتين على الالتفاف في الشكل الصحيح وأداء وظيفته.
كان العلماء يعرفون بالفعل أن النماذج اللغوية المدربة على ملايين تسلسلات البروتينات قادرة على العثور على هذه التكرارات. لكن كيف تفعل ذلك بالضبط، بقي لغزًا. في الدراسة الجديدة، نظر المؤلفون داخل النموذج وتتبعوا عمله خطوة بخطوة. وتبين أن آلية التكرارات غير الدقيقة هي أكثر عمومية: فهي تشمل آلية التكرارات الدقيقة، كما لو أن القدرة على قراءة نص به أخطاء مطبعية تمنح تلقائيًا القدرة على قراءة نص بدونها.
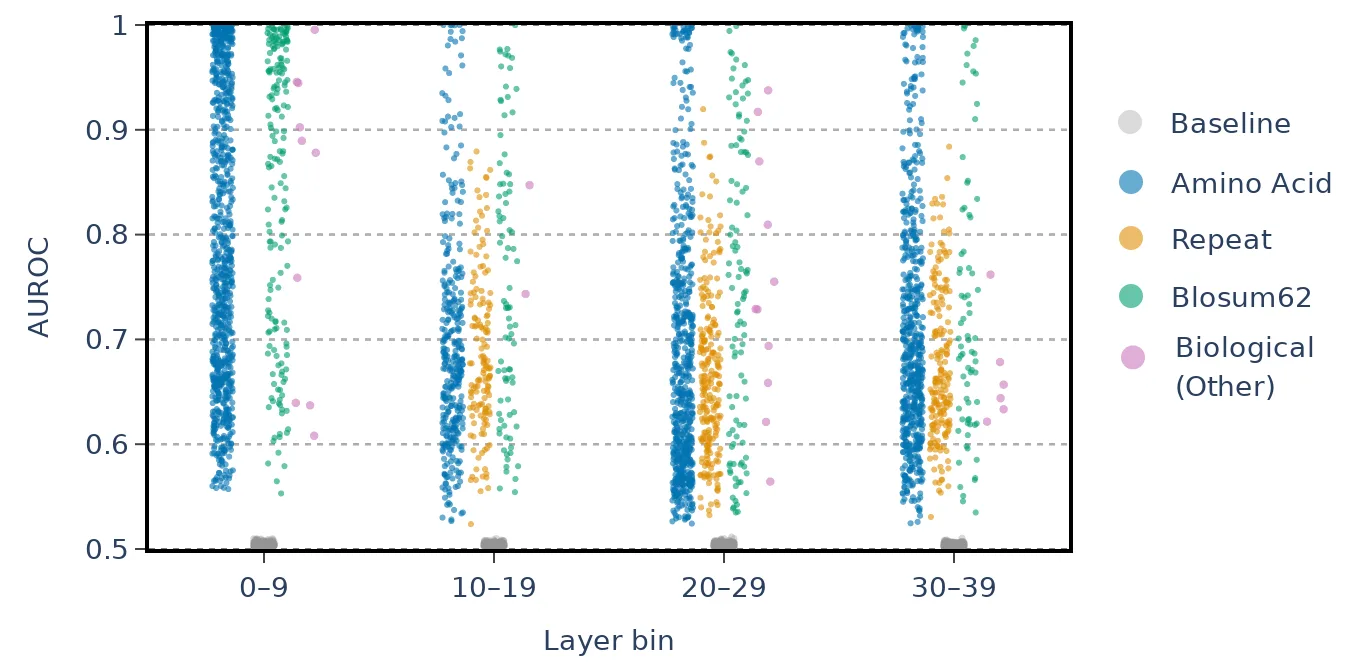
بعد ذلك، تجد ما يسمى "رؤوس الاستقراء" للانتباه مقاطع متطابقة أو متشابهة في أماكن مختلفة من السلسلة وتنقل المعلومات بينها. وهذا يساعد النموذج على التنبؤ بالحمض الأميني الذي يجب أن يكون في موضع النقص. وهكذا يجمع النموذج اللغوي بين الآلية العامة للبحث عن الأنماط والمعرفة البيولوجية بخصائص الأحماض الأمينية.
هذا الاكتشاف هو خطوة نحو فهم كيف يمكن للنماذج التقاط عمليات تطورية أكثر تعقيدًا مكتوبة في تسلسلات البروتينات. وهذا يعني أنها ستتمكن في المستقبل من التنبؤ بشكل أفضل ببنية البروتينات ووظيفتها، وهو أمر مهم لتطوير الأدوية والتقنيات الحيوية.
الملخص الأصلي
كما كتبه المؤلفون، بالإنجليزية arXiv:2602.23179
Protein sequences are abundant in repeating segments, both as exact copies and as approximate segments with mutations. These repeats are important for protein structure and function, motivating decades of algorithmic work on repeat identification. Recent work has shown that protein language models (PLMs) identify repeats, by examining their behavior in masked-token prediction. To elucidate their internal mechanisms, we investigate how PLMs detect both exact and approximate repeats. We find that the mechanism for approximate repeats functionally subsumes that of exact repeats. We then characterize this mechanism, revealing two main stages: PLMs first build feature representations using both general positional attention heads and biologically specialized components, such as neurons that encode amino-acid similarity. Then, induction heads attend to aligned tokens across repeated segments, promoting the correct answer. Our results reveal how PLMs solve this biological task by combining language-based pattern matching with specialized biological knowledge, thereby establishing a basis for studying more complex evolutionary processes in PLMs.
في البروتينات، يمكن أن تكون التكرارات طويلة جدًا — على سبيل المثال، بروتين التيتين الذي يمنح العضلات مرونتها يحتوي على مئات من المجالات المتكررة، تشبه حلقات السلسلة.