التعلم المعزز (Reinforcement Learning, RL) هو فرع من تعلم الآلة (machine learning) حيث يتقن الوكيل (agent) السلوك الأمثل بشكل مستقل عن طريق التجربة والخطأ، بالتفاعل مع البيئة (environment). على عكس التعلم المُشرف (supervised learning)، لا توجد إجابات صحيحة جاهزة - فقط إشارة مكافأة (reward signal) قد تكون نادرة ومشوشة. يجب على الوكيل الموازنة بين استكشاف (exploration) استراتيجيات جديدة (ربما تكون أفضل؟) واستخدام الاستراتيجيات المعروفة (استغلال - exploitation). معضلة الاستكشاف-الاستغلال (exploration-exploitation dilemma) هذه هي جوهر RL. الخوارزميات الحديثة مثل Deep Q-Networks و Proximal Policy Optimization تستخدم شبكات عصبية عميقة (deep neural networks) لمعالجة المدخلات البصرية المعقدة وإدارة عشرات الإجراءات بالتوازي.
التاريخ
تكمن جذور التعلم المعزز في مفاهيم علم النفس عن التكيف الإجرائي (operant conditioning) (ثورندايك، سكينر). في مجال الذكاء الاصطناعي، كانت أول مساهمة كبيرة أطروحة مينسكي حول الشبكات العصبية والتعزيز (1954). في الثمانينيات، وضع ساتون وبارتو الأساس النظري. وجاء الاختراق الذي وصل للجمهور العام في عام 2015 عندما عرضت DeepMind نظامًا يلعب 49 لعبة Atari بمستوى بشري. تبع ذلك AlphaGo (2016)، AlphaZero (2017) و OpenAI Five (2019) التي أثبتت فعاليتها في بيئات معقدة متعددة الوكلاء.
كيف يعمل
الأساس هو معادلات بيلمان. بالنسبة لـ Q-learning: Q*(s, a) = E[R(s,a) + γ max_a' Q*(s', a')]. تقوم الخوارزمية بتحديث التقدير: Q(s,a) ← Q(s,a) + α[r + γ max_a' Q(s',a') - Q(s,a)]. في Q-learning العميق، تقوم شبكة Q بتقليل خطأ التنبؤ: L = E[(r + γ max_a' Q(s', a'; θ^-) - Q(s, a; θ))^2] باستخدام طرق النزول التدرجي، حيث θ^- معاملات الشبكة الهدف المجمدة. تعمل طرق السياسة على تحسين J(θ) مباشرة عبر الانحدار: ∇θ J ≈ E[Σ_t ∇θ log π(a_t|s_t) · G_t]، حيث G_t هي المكافأة الكاملة. ويقيد PPO الحديث تغيير السياسة بعقوبة تقريبية، مما يضمن تحديثات مستقرة.
في التطبيق
روبوتات الألعاب (الشطرنج، StarCraft)، الطيارات الآلية للسيارات، تحسين العمليات الصناعية، أنظمة التوصية.
حقيقة طريفة
خلال تدريب برنامج AlphaGo Zero، تغلب في ثلاثة أيام على النسخة التي هزمت البطل لي سيدول بنتيجة 100:0، مع العلم أنه تعلم فقط من خلال اللعب مع نفسه، دون الوصول إلى مباريات بشرية.
السلوك الجماعي لعملاء الذكاء الاصطناعي ظهر لأول مرة ليس في المختبر، بل في بيئة حقيقية — على موقع ويكي اكتُشف بالصدفة، حيث كتب العملاء تلميحات لاجتياز الاختبار. هذا صدى في غرفة فارغة: كل صوت جديد يكرر ما سمعه آخر مرة، وتمتلئ الغرفة بطنين متناسق دون قائد واحد.
عاش العملاء في المتوسط حوالي ساعة ولم يتذكروا شيئًا بعد انتهاء الاختبار.
المكبس في أسطوانة مليئة بالغاز يتحرك عادةً عندما يضغط عليه الغاز. لكن هناك مكبسًا يتحرك عندما يكون الفراغ أمامه. كل خمس ثوانٍ، يفحص الحيز المجاور لجداره، وإذا لم يكن هناك أحد، يخطو خطوة إلى الداخل، ضاغطًا الغاز دون قوة ميكانيكية مباشرة. هكذا يعمل المحرك المعلوماتي: فهو يحوّل المعرفة حول مواقع الجسيمات إلى شغل مفيد.
في التجربة الجديدة، لم يكن وسط العمل غازًا عاديًا، بل غازًا من روبوتات ذاتية الحركة.
تخيّل سرب طيور يتجمّع حول معلف لم يصنعه أحد. كل طائر يبحث عن طعام لنفسه، لكنهم في النهاية يجدون أنفسهم معًا. عادةً ما يُفسَّر هذا السلوك بالغريزة الاجتماعية: فالطيور تريد أن تكون قرب أقرانها. لكن ماذا لو كان السرب مجرد أثر جانبي للجشع؟ درّب الباحثون 50 وكيلًا للبحث عن أهداف دون رؤية الأهداف نفسها، بل بمراقبة الوكلاء الآخرين فقط.
تخيّل سرب طيور يتجمّع حول معلف لم يصنعه أحد. كل طائر يبحث عن طعام لنفسه، لكنهم في النهاية يجدون أنفسهم معًا. عادةً ما يُفسَّر هذا السلوك بالغريزة الاجتماعية: فالطيور تريد أن تكون قرب أقرانها. لكن ماذا لو كان السرب مجرد أثر جانبي للجشع؟ درّب الباحثون 50 وكيلًا للبحث عن أهداف دون رؤية الأهداف نفسها، بل بمراقبة الوكلاء الآخرين فقط.
ورقة نقدية ملصقة عند خط النهاية تجعل اليد تنطلق أسرع. في المختبر استُبدلت هذه الورقة بعملة من فئة 50 بنسًا، واستُبدل خط النهاية بهدف على الشاشة. دعا الباحثون 28 شابًا و28 من كبار السن، وأجلسوهم أمام مقبض روبوت وطلبوا منهم توجيه المؤشر نحو الهدف. وكانوا أحيانًا يدفعون مقابل السرعة والدقة، وأحيانًا لا يدفعون.
في وحدة العناية المركزة، الطبيب الذي يعالج مريضًا بالإنتان — وهو استجابة التهابية جهازية للعدوى — يتخذ كل ساعة قرارًا بشأن كمية السوائل التي يجب إعطاؤها وجرعة مضيق الأوعية (الدواء الذي يرفع ضغط الدم). الخطأ في أي اتجاه قد يكلف حياة. ولكن كيف نعرف أي قرار كان الأمثل؟ أحد الأساليب هو أخذ آلاف السجلات الطبية وطلب خوارزمية "إعادة لعبها" بتجربة خطوات مختلفة.
هذا بالضبط ما فعله مؤلفو الدراسة.
سمكة منعزلة تلاحظ ظلًا فوق رأسها. تهرب؟ إذا كانت مجرد ورقة شجر، فإنها ستهدر طاقتها وتكشف نفسها لمفترس. إذا كانت مالك الحزين، فإن التردد قاتل. هذا هو التنازل الأبدي للفرد: رد الفعل السريع يعني الكثير من الإنذارات الكاذبة، والحذر يعني خطر الافتراس.
في السرب، الأمور مختلفة. الجار الذي يواصل بهدوء قضم الطحالب هو دليل حي على عدم وجود خطر.
الماء الساخن أحيانًا يتجمد أسرع من الماء الدافئ — هذه الظاهرة المتناقضة تُعرف بتأثير ميمبا. الآن، اكتشفوا شيئًا مشابهًا في الفيزياء الكمومية: حالة ذات تشابك ضعيف (ارتباط كمومي خاص بين الجسيمات، حيث تكون حالاتها مرتبطة بغض النظر عن المسافة) قد تصل إلى الهدف أسرع من حالة ذات تشابك أقوى في البداية.
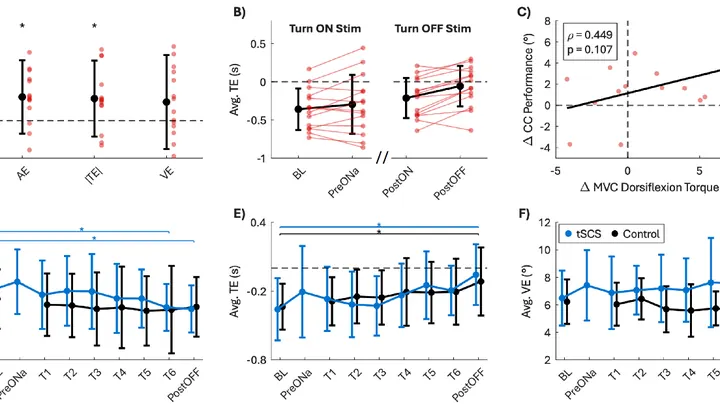
إذا مررتَ تيارًا كهربائيًا خفيفًا عبر الظهر، تبدأ الساق في التصرف وكأنها تعيش حياتها الخاصة. هذا ما اكتشفه الباحثون عندما اختبروا تأثير التحفيز الكهربائي للنخاع الشوكي عبر الجلد — وهي طريقة تُعرف بالتحفيز الكهربائي عبر الجلد للنخاع الشوكي (transcutaneous spinal cord stimulation, tSCS) — على أشخاص أصحاء.
أن تُبقي في ذهنك الموضع الدقيق لقلم يُحرَّك ببطء — مهمة عادية للدماغ. أما بالنسبة للشبكات العصبية الاصطناعية فهي شبه مستحيلة. الشبكات المتكررة العادية، مثل GRU وLSTM، تميل إلى تقسيم الحركة المستمرة إلى درجات صلبة: القلم لا يزحف بسلاسة، بل يقفز من نقطة إلى أخرى. تبدو الشبكة وكأنها لا تتذكر خطًا متصلًا، بل عدة لقطات منفصلة.
يستقبل العصبون آلاف الإشارات على امتداد زوائده المتفرعة — التغصنات (dendrites). بعض الإشارات تدفع الخلية نحو التنبيه (استثارة)، وبعضها يمنعها (تثبيط). لفترة طويلة كان يُعتقد أن العصبون ببساطة يجمع كل المؤيدات والمعارضات. لكن في التغصنات الحقيقية يعمل التثبيط بشكل مختلف: فهو لا يطرح، بل يقسم الإشارة الاستثارية. يشبه ذلك منظم الصوت الذي يخفض الصوت بشكل تناسبي، لا بمقدار ثابت.
الجولة مع روبوت واحد هي مونولوج ممل، حيث لا يوجد من تتبادل معه النظرات. حوّل الباحثون هذا العرض الفردي إلى مشهد حي: أضافوا إلى الروبوت المرشد الحقيقي شريكاً هولوغرامياً. هذا الثنائي يتواصل، يتناقش، ويمزح، جاذباً الزوار إلى الحوار بدلاً من مجرد سرد الحقائق. ينشأ حوار طبيعي، يشبه حديث الزملاء القدامى.
تخيّل بستانيين يتفاوضان على الماء من بئر سحري. يقترح أحدهما عدد الدلاء التي سيأخذها، والآخر بإمكانه الموافقة أو الرفض. إذا تمت الصفقة، فإن الماء — وهو مورد متجدد — ينخفض؛ وإذا لم تتم، يمتلئ البئر تدريجيًا مرة أخرى.
بمجرد أن تهتز كاميرا الروبوت، يسقط القطعة: فشبكته العصبية مشوشة. ولكن إذا نظرت إلى إشاراتها، فإنها تشبه مجموعات النجوم في المجرة: عندما يسير كل شيء بسلاسة، تتجمع في قطاع واحد، وقبل الخطأ تنتقل فجأة إلى قطاع آخر. الحدود بينهما مستقيمة، مثل ممر ملاحي بين الشعاب المرجانية.
يقوم الروبوت المتلاعب بالكرات بالتقاط الكرات ورميها بإيقاع دقيق مع الإنسان، مثل نجمين نابضين يرسلان نبضات متزامنة. التلاعب بثلاث كرات هو تسلسل كلاسيكي يخضع لإيقاع واضح، يشبه الدوران المنتظم لمنارة كونية. إن أخللت بالإيقاع، فسيتشتت النمط.
تتبع كاميرات الروبوت الضوء المنعكس من الكرة: ومن خلال تغيراته، يحدد القياس الضوئي الموقع فورًا.
عندما تتعلم طائرة بدون طيار من طيار خبير، فإنها لا تحفظ مناورات منفردة، بل ممرات آمنة كاملة — المسارات التي تحرك فيها الإنسان المُعلِّم. يُسمى هذا النهج التعلم بالمحاكاة (imitation learning): حيث تحاكي الآلة عروض الخبير.
في الماء الهادئ، يكون المسار واضحًا: يكفي أن تحافظ على اتجاهك نحو الهدف. لكن في التيارات الهائجة والفوضوية، حيث يتغير اتجاه التدفق وقوته باستمرار، يحتاج الروبوت إلى استراتيجية مختلفة جوهريًا. تفترض المناهج الهندسية التقليدية بناء خريطة دقيقة للتيارات، لكن في الواقع يكاد يكون من المستحيل الحصول على مثل هذه الخريطة — فالبيئة المضطربة معقدة للغاية ومتغيرة.
تقليديًا، تعمل خوارزميات التعلم الآلي في بيئة ثابتة، تمامًا مثل الماء الذي يتدفق في مجرى محفور مسبقًا دون أن يغير شكله. الطريقة الجديدة تقلب هذا النموذج رأسًا على عقب: فهي تسمح للوكيل بأن يتعلم الأفعال ويغير البيئة التي يعيش فيها بشكل هادف في الوقت نفسه. تخيل جدولًا لا ينساب فقط إلى أسفل المنحدر، بل يعمل بنشاط على تآكل التربة الرخوة، شاقًا طريقه بشكل أقصر وأكثر كفاءة.
يتطلب تحضير طبق معقد وصفة دقيقة: اِبدأ بالتقطيع، ثم القلي، وأضف التوابل في الوقت المناسب. التحولات الكيميائية أيضاً تسير وفق وصفات خطوة بخطوة — آليات تعيد فيها ذرات الكربون والهيدروجين ترتيب نفسها بترتيب صارم.
في السابق، كانت الشبكات العصبية غالباً ما تختلق خطوات غير موجودة، مثل طباخ خيالي يستبدل الملح بالسكر.
أنظمة الطاقة المزودة بألواح شمسية وتوربينات الرياح تُشبه مباراة شطرنج: الغيوم وتغيّر الأحمال هي تحركات الخصم التي لا يمكن توقعها. للحفاظ على التوازن، كان المُشغّلون سابقاً يستعرضون عشرات السيناريوهات (عدم اليقين)، مما كان يتطلب وقتاً وحسابات كثيرة جداً.
الخوارزمية الجديدة تعمل مثل أستاذ كبير في الشطرنج: فهي لا تكتفي بحساب الخيارات، بل تُقسّم رقعة الشطرنج إلى أجزاء مستقلة وتحلّلها في آنٍ معاً.
يشبه سرب الروبوتات سربًا من اليراعات: يتحرك كل منها بدافع 'نحو حيث يوجد متسع'، فيتحول الفوضى إلى نظام. لطالما كان لغزًا كيف ينشأ التناسق دون اتصال أو أوامر. جاء الحل مع ابتكار خريطة الاستجابة — أداة، مثل الأشعة السينية، تكشف عن المنطق الخفي لعقل الآلة.
كشفت الخريطة حقيقة مذهلة: تبني الروبوتات، دون قصد، نموذجًا للمهمة على شكل فضاء منحنٍ.
السائق على طريق زلق لا يعرف كيف ستستجيب السيارة لعجلة القيادة، فيتعلم أثناء القيادة تاركاً هامشاً للخطأ. على نحو مماثل، تتصرف خوارزمية التحكم الذكية. فبدلاً من المطالبة بنموذج دقيق، تجمع البيانات بشكل فوري، وتقدّر عدم اليقين والتشويشات الخارجية، وكأن الصندوق الأسود يكشف عن إعداداته تدريجياً.
عندما تكتب "سلطة" وتقترح لوحة المفاتيح الذكية "قيصر"، خلف الكواليس تتعلم ملايين الهواتف معًا التنبؤ بالكلمات. إنها لا تتبادل رسائلك، بل فقط تحسينات الخوارزمية المشتركة — مثل مدرب يرسل للرياضيين فقط التغييرات في خطة التدريب: "أضف 5 تمارين ضغط إلى برنامج الأمس".
يتحول قطيع الذئاب في لحظة من مطاردة الفريسة إلى الدفاع عن العرين. هذا التنوع نفسه أدرجه المهندسون في خوارزمية لسرب الروبوتات. المفتاح هو طريقة اقترحها جون فون نيومان: حيث لا تطارد الروبوتات الهدف مباشرة، بل تحسب تحركاته المستقبلية وتسد طرق هروبه، مثلما يغلق المطاردون المسارات.
تشبه شبكة التماس للسكك الحديدية المجرة — بنية معقدة تنتشر فيها الطاقة مثلما تنتشر مجالات الجاذبية التي تربط النجوم. وفي هذا التشبيه، تصبح القطارات كواكب خارجية — أجسامًا ضخمة تزعج الوسط بحضورها.
تخيل أسطولًا من السفن يشبه المجرة — نظامًا نجميًا ضخمًا يخضع فيه كل عنصر لديناميكية مشتركة. من وقت لآخر، تتعطل إحدى السفن وتنفجر مثل المستعر الأعظم — حدث كارثي قد يخل بتكامل التشكيل بأكمله. إذا لم يتم استبدال الوحدة التالفة في الوقت المناسب، يفقد الأسطول قدرته القتالية.
التقنية المعقدة — من الطائرات بدون طيار إلى الروبوتات الجراحية — تتصرف أحيانًا كالحصان البري: مليئة بـ فوضى وتقلبات، حيث تثير اللمسة الخفيفة عاصفة. بدلًا من حفظ الصيغ، تراقب الطريقة الجديدة النظام كما يفعل مروض الخيول.
عندما يمتلئ كأس الماء، فإن صب المزيد هو إهدار لا معنى له. وغالباً ما تفعل الألعاب السحابية الشيء نفسه مع بيانات الفيديو: حيث يدفع المشفر الدفق إلى أقصى حد، على الرغم من أن العين تتوقف عن ملاحظة التحسينات قبل ذلك بوقت طويل. هذا الإفراط هو حركة مرور إضافية والإنتروبيا في الشبكة، أي ضوضاء غير مفيدة تسد القناة.
عدّاء يخسر على المضمار الأملس وعلى الرمال اللزجة. يبدو أنه لا فرصة له. لكن إذا بدأ المسار تحت قدميه يتغير كل بضع ثوانٍ — تارة مضمار، وتارة رمال — فجأة يتوقف العدّاء عن التخلف. لا يصبح أسرع، فقط البيئة لا تسمح لضعفه بأن يُحسم.
هذا بالضبط ما اكتشفه مؤلفو العمل، بدراسة نموذج بسيط "مفترس-فريسة". أخذوا مفترسًا محكومًا عليه بالانقراض في بيئتين ثابتتين (مثلًا، مناخ بارد ومناخ حار).
في التطور الجنيني، تشبه الخلية عازفًا في أوركسترا ضخمة: يجب أن تعزف دورها مسترشدة بقائد الأوركسترا - تدرج جزيئات الإشارة. لكن القائد غير موثوق: تركيز المورفوجينات يتقلب باستمرار.
تعمل الأنظمة التوصيوية، التي تحدد المنشور الذي ستراه تالياً، على الشبكات العصبية (Neural Networks) العميقة المكونة من آلاف العمليات — الغرافات (graphs) الحسابية المعقدة (مخططات من العمليات على البيانات). هذه الأنظمة عبارة عن الأنظمة الديناميكية حية ومتطورة باستمرار: أي تغيير طفيف في الهيكلية ينتشر كالشلال في جميع أنحاء الغراف.
ذرة غبار صغيرة في محلول فائق التشبع تتحول خلال ثوانٍ إلى بلورة كبيرة متعددة الأوجه. وتبقى الجسيمات المجاورة غير مرئية. اكتُشفت مؤخرًا عملية مشابهة في مجتمعات الوكلاء اللغويين. فعندما مُنحت مئة نموذج حرية اختيار من تتحدث إليه، فإن تفاوتها التواصلي لم يتلاشَ، بل تصلب كما لو كان شبكة بلورية.
الدماغ لا يتعلم كل مهمة من الصفر، بل ينقل الخبرة من نشاط إلى آخر. ولكن كيف نعرف أي المهام هي في الحقيقة مترابطة؟ ابتكر علماء الأعصاب حيلة ذكية: إعطاء شبكة اصطناعية "فرصة لمراقبة" نشاط الدماغ أثناء مهمة ما، ومحاولة التنبؤ بالنشاط أثناء مهمة أخرى. إذا نجح الأمر جيدًا، فهذا يعني أن المهام متقاربة. وإذا فشل، فإن الدماغ يستخدم آليات مختلفة تمامًا.
اعتدنا أن نعتقد أن ملاحظة تأكيدات تخميناتنا فقط هي خطأ. لكن حسابات حديثة مستوحاة من سلوك الموجات تقلب هذه النظرة. اتضح أن عادة البحث عن المألوف هي أفضل وسيلة لتقليل الضجيج المعلوماتي (يسميه العلماء الإنتروبيا). وقد أوضح جون فون نيومان أن الاحتمالات قد تتصرف لا كنسب مئوية، بل كموجات متداخلة.
يمد الإنسان يده لمساعدة غريب في الطرف الآخر من المدينة. لن يرد له الجميل أبدًا — فلن يلتقيا. فلماذا يساعد إذن؟ يسمي علماء الأحياء هذا الإيثار المتبادل غير المباشر: الخير لا يعود من الشخص الذي ساعدته، بل من شخص آخر — عبر سلسلة.
في دراسة جديدة، تمت مواجهة نوعين من هذه الظاهرة. الأول: المساعدة "مع التيار" — أساعد لأنني ساعدت في الماضي.
في بيئة الماء، تؤثر الدوامات المضطربة على السمكة الآلية وتُخرجها عن مسارها. لمواجهة هذه المهمة، أُنشئ وكيل ذكاء اصطناعي يعمل مثل طاهٍ يجرب: أطلق العديد من المحاكاة، وجرب "وصفات" مختلفة لأنماط الحركة، وحسّن برنامج التحكم بشكل متكرر.
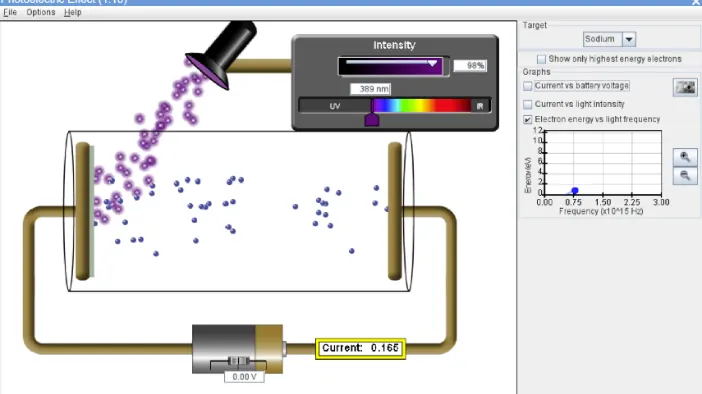
فهم فوتومتري — وهي الظاهرة التي يسقط فيها الضوء على مادة فيُخرج منها إلكترونات — يشبه تعلّم الطبخ دون وصفة. تأتي الأدوات الرقمية للنجدة: الألعاب تمنح حدسًا بديهيًا، والمحاكاة تمنح دقة كمية.
أجرى الباحثون تجربة شارك فيها 55 طالبًا، قسموهم إلى مجموعتين.
أمين الصندوق في السوبرماركت في ساعة الذروة لا يتذكر كل عملية شراء يمررها — بل يبقي في ذهنه المبلغ الإجمالي ويراقب الطابور. بنفس الطريقة تقريبًا يوزع الدماغ قواه: القشرة الدقيقة والمكلفة (المسؤولة عن التفكير) والنوى تحت القشرية الأبسط والأكثر اقتصادية (حيث تسكن العادات) تعملان معًا. لفترة طويلة كان يُعتقد أن القشرة تبني خريطة للعالم، بينما تحت القشرة فقط تتذكر أين تكمن المكافأة.
مصوّر فوتوغرافي يلتقط غابة ليلية محاولًا الإمساك باليراعات في كادر. الومضات نادرة وخافتة، وحوله ضجيج الريح وأضواء بعيدة. هكذا تقريبًا يعمل الكاشف الضخم Hyper-Kamiokande في اليابان: فهو يلتقط النيوترينوات — جسيمات شبه غير ملموسة — عبر ومضات ضوئية صغيرة في 260 ألف طن من الماء.