Cómo aprende una red neuronal a hablar como un humano exprés
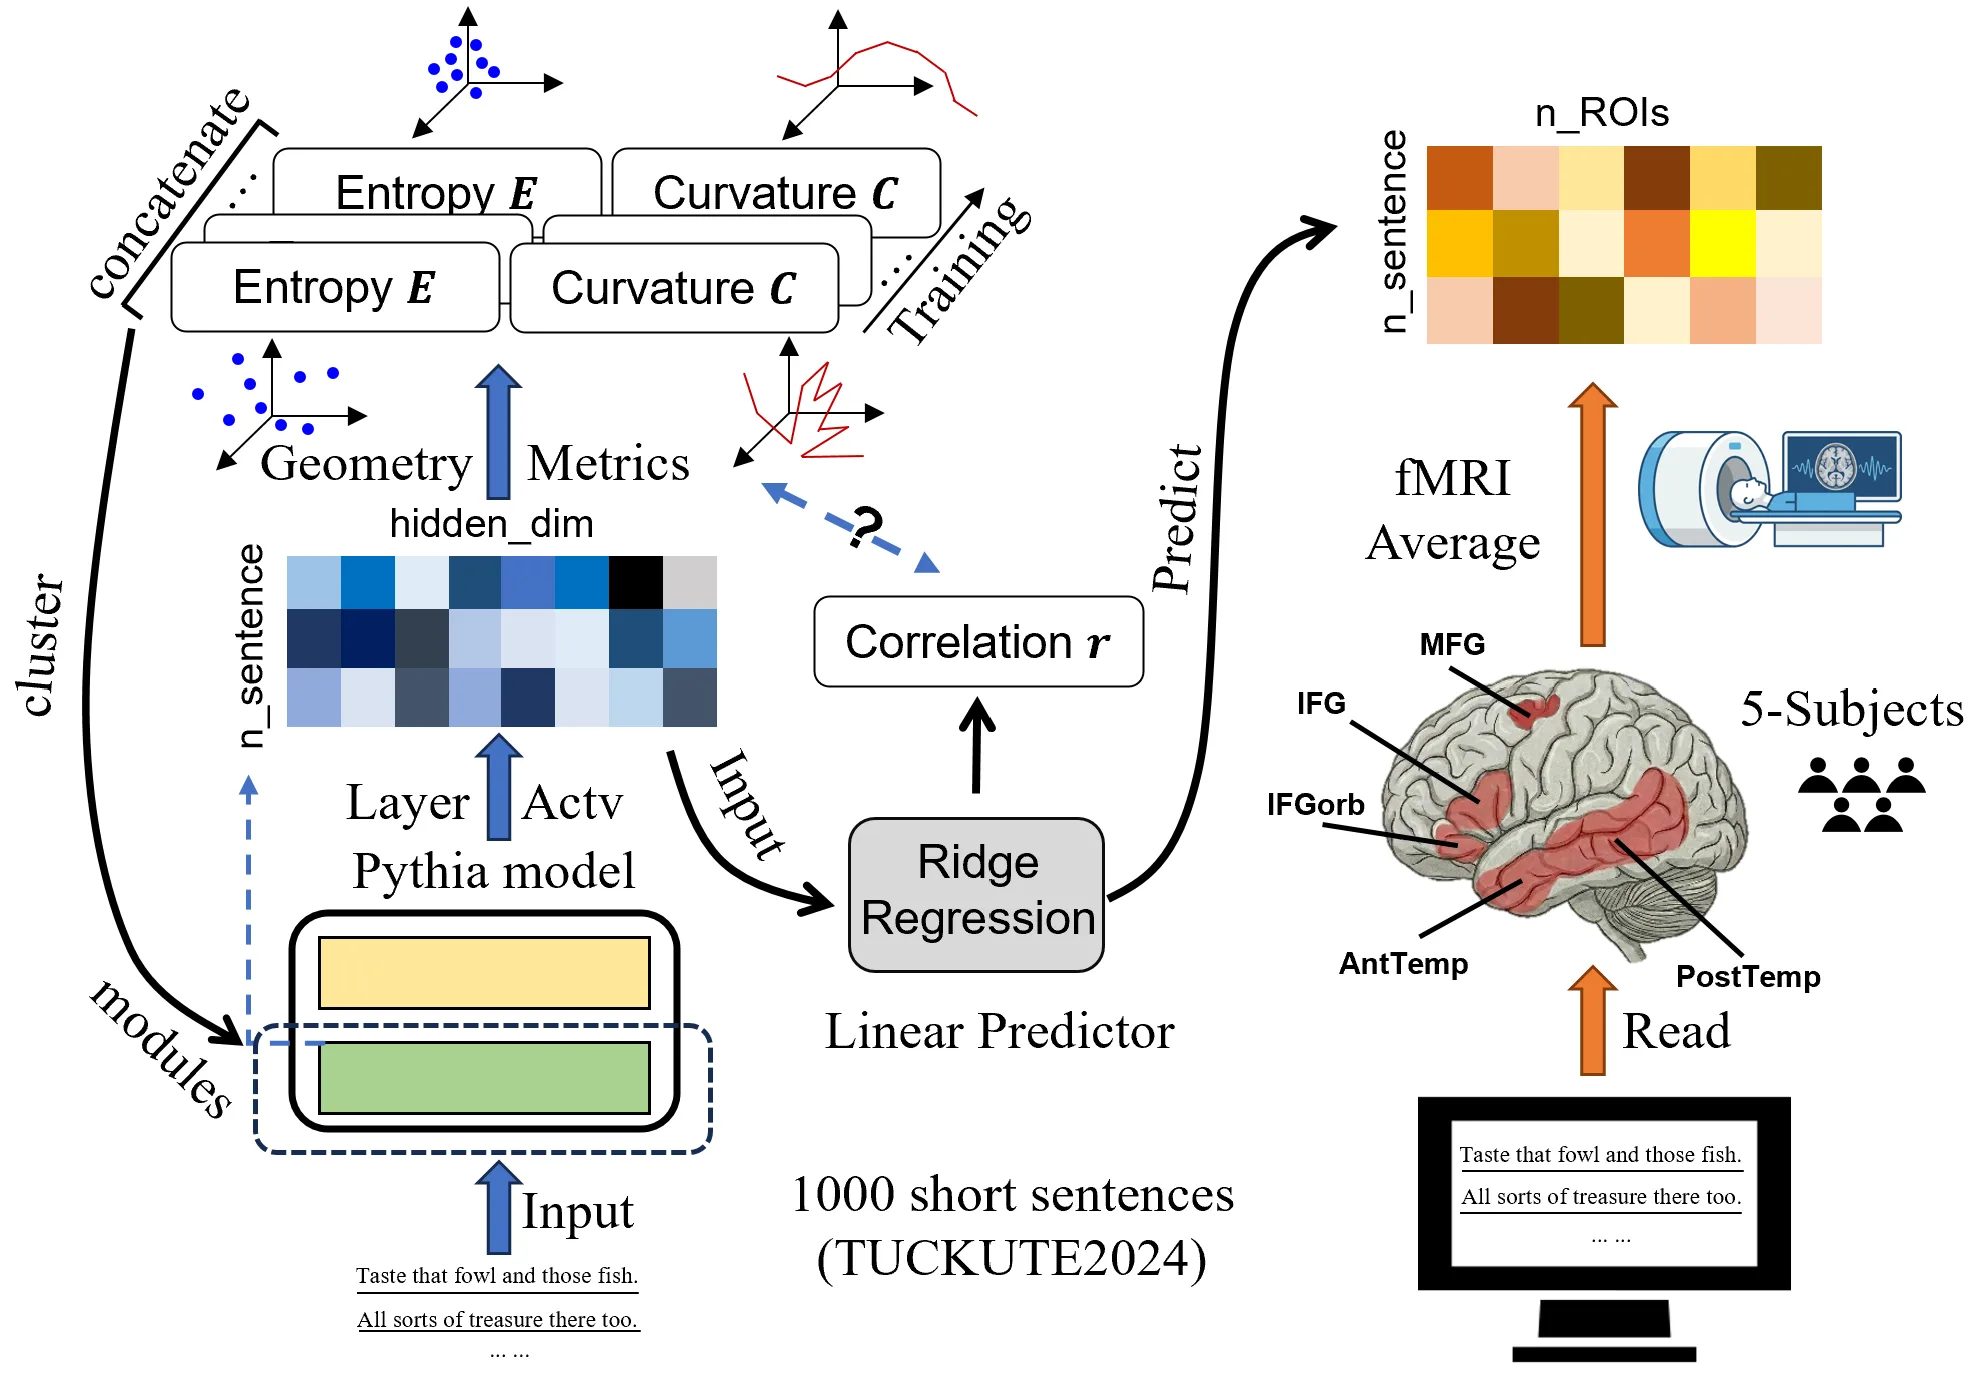
Un modelo de lenguaje es una construcción de múltiples capas, donde cada capa procesa las palabras a su manera. Al inicio del entrenamiento, las capas son caóticas, pero poco a poco se organizan en dos equipos. El primer equipo trabaja de forma simple: su geometría interna se suaviza y se vuelve menos enredada. El segundo permanece complejo y sinuoso.
Los científicos compararon el modelo con datos de fMRI de personas que escuchaban o leían texto. La similitud con el cerebro aparecía de manera desigual: en las regiones temporales (que procesan el sonido y el significado de las palabras) era rápida y estable, mientras que en las frontales (que construyen frases) llegaba más tarde y de forma gradual. Además, en los modelos más grandes esta relación era más fuerte.
Así que aprender un idioma es un camino del caos al orden. El cerebro quizá hace lo mismo: suaviza algunas rutas de procesamiento de información y deja otras complejas para mantener la flexibilidad.
Resumen original
tal como lo escribieron los autores, en inglés arXiv:2602.07539
How large language models (LLMs) align with the neural representation and computation of human language is a central question in cognitive science. Using representational geometry as a mechanistic lens, we addressed this by tracking entropy, curvature, and fMRI encoding scores throughout Pythia (70M-1B) training. We identified a geometric modularization where layers self-organize into stable low- and high-complexity clusters. The low-complexity module, characterized by reduced entropy and curvature, consistently better predicted human language network activity. This alignment followed heterogeneous spatial-temporal trajectories: rapid and stable in temporal regions (AntTemp, PostTemp), but delayed and dynamic in frontal areas (IFG, IFGorb). Crucially, reduced curvature remained a robust predictor of model-brain alignment even after controlling for training progress, an effect that strengthened with model scale. These results links training-driven geometric reorganization to temporal-frontal functional specialization, suggesting that representational smoothing facilitates neural-like linguistic processing.
Las capas de un modelo de lenguaje se pueden comparar con los pisos de un edificio: los pisos inferiores descomponen las palabras en sonidos y letras, y los superiores construyen el significado. La investigación mostró que los pisos "simples" están más cerca de la entrada, y los "complejos", de la salida.
En la película "Ella", la inteligencia artificial Samantha evoluciona y comienza a entender a los humanos mejor que ellos mismos. Esta investigación es un paso hacia comprender cómo una máquina podría alcanzar ese nivel.